JAVA学习路线
目录
JAVA
Java 是一种广泛使用的编程语言和计算平台,最初由 Sun Microsystems 公司(现属于 Oracle 公司)于 1995 年发布。Java 以其稳定性、跨平台性和丰富的库和框架而著称,广泛应用于企业级应用、移动应用、Web 应用和嵌入式系统等多个领域。Java EE(Java Platform, Enterprise Edition)提供了一套完整的技术栈,用于构建和运行大型的 Web 应用和服务。 其跨平台性、面向对象编程特性、丰富的库和框架、高安全性和高性能,使得 Java 在过去的几十年中一直保持着重要的地位。对于开发者来说,掌握 Java 可以带来广阔的职业发展机会和技术成长空间。
但并不是所有的工程和环境需要企业等级的复杂性,比如一个简单的个人网站或者独自编程的程序师所写的程序。这些程序师会发现 Java 的复杂管理对于自己要做的程序来说过于强大了。一些人觉得 Java 在面向对象上面做的没有 Ruby 和 Smalltalk 纯粹。但是最新出现的用 Java 实现的语言 Groovy 解决了这些问题。 Java 应用通常需要大量的配置文件和复杂的构建工具(如 Maven 和 Gradle)。对于简单项目或个人开发者来说,这种复杂性可能会显得不必要。
基本概念
Java 程序员之所以容易搞混值传递和引用传递,主要是因为 Java 有两种数据类型,一种是基本类型,比如说 int,另外一种是引用类型,比如说 String。
基本类型的变量存储的都是实际的值,而引用类型的变量存储的是对象的引用——指向了对象在内存中的地址。值和引用存储在 stack(栈)中,而对象存储在 heap(堆)中。
之所以有这个区别,是因为:
- 栈的优势是,存取速度比堆要快,仅次于直接位于 CPU 中的寄存器但缺点是,栈中的数据大小与生存周期必须是确定的。
- 堆的优势是可以动态地分配内存大小,生存周期也不必事先告诉编译器,Java 的垃圾回收器会自动收走那些不再使用的数据。但由于要在运行时动态分配内存,存取速度较慢。
Java 有 8 种基本数据类型,分别是 int、long、byte、short,float,double 、char 和 boolean。它们的值直接存储在栈中,每当作为参数传递时,都会将原始值(实参)复制一份新的出来,给形参用。形参将会在被调用方法结束时从栈中清除。
Java only uses PASS-BY-VALUE:把引用变量的复制传给数组对象
jdk(develop kit)包含 jre 包含 jvm;JRE 是 java 运行时的环境,包含 jvm 和核心类库,JDK 是开发工具包
Race Condition(也叫做资源竞争),是多线程编程中比较头疼的问题。特别是 Java 多线程模型当中,经常会因为多个线程同时访问相同的共享数据,而造成数据的不一致性。为了解决这个问题,通常来说需要加上同步标志“synchronized”,来保证数据的串行访问。但是“synchronized”是个性能杀手,过多的使用会导致性能下降,特别是扩展性下降,使得你的系统不能使用多个 CPU 资源。without proper synchronization and their operation interleaves on each other.
Class 类
Object 类是一切 java 类的父类,对于普通的 java 类,即便不声明,也是默认继承了 Object 类。典型的,可以使用 Object 类中的 toString()方法。
Class 类是用于 java 反射机制的,一切 java 类,都有一个对应的 Class 对象,他是一个 final 类。Class 类的实例表示,正在运行的 Java 应用程序中的类和接口。
Class 类的实例表示正在运行的 Java 应用程序中的类和接口。枚举是一种类,注释是一种接口。每个数组属于被映射为 Class 对象的一个类,所有具有相同元素类型和维数的数组都共享该 Class 对象。基本的 Java 类型(boolean、byte、char、short、int、long、float 和 double)和关键字 void 也表示为 Class 对象。
Class 没有公共构造方法。Class 对象是在加载类时由 Java 虚拟机以及通过调用类加载器中的 defineClass 方法自动构造的。
注解
注解是元数据的一种形式,提供有关于程序但不属于程序本身的数据。注解对它们注解的代码的操作没有直接影响。
注解的作用
- **减少配置:**运行时动态处理,得到注解信息,实现代替配置文件的功能;
- **减少重复工作:**比如第三方框架 xUtils,通过注解@ViewInject 减少对 findViewById 的调用,类似的还有(JUnit、ActiveAndroid 等);
通过上面的描述可以发现,其实注解干的很多事情,通过配置文件也可以干,比如为类设置配置属性;但注解和配置文件是有很多区别的,在实际编程过程中,注解和配置文件配合使用在工作效率、低耦合、可拓展性方面才会达到权衡。
三类:自定义注解、JDK 内置注解、还有第三方框架提供的注解。
- 自定义注解就是我们自己写的注解,比如@UserLog
- JDK 内置注解,比如@Override 检验方法重写,@Deprecated 标识方法过期等
- 第三方框架定义的注解比如 SpringMVC 的@Controller 等
public @interface 注解名称{ 属性列表;}Java 定义了一套注解,共有 7 个,3 个在 java.lang 中,剩下 4 个在 java.lang.annotation 中。
作用在代码的注解是
- @Override - 检查该方法是否是重写方法。如果发现其父类,或者是引用的接口中并没有该方法时,会报编译错误。
- @Deprecated - 标记过时方法。如果使用该方法,会报编译警告。
- @SuppressWarnings - 指示编译器去忽略注解中声明的警告。
作用在其他注解的注解(或者说 元注解)是:
- @Retention - 标识这个注解怎么保存,是只在代码中,还是编入 class 文件中,或者是在运行时可以通过反射访问。
- @Documented - 标记这些注解是否包含在用户文档中。
- @Target - 标记这个注解应该是哪种 Java 成员。
- @Inherited - 标记这个注解是继承于哪个注解类(默认 注解并没有继承于任何子类)
(class 文件。)AOP(面向切面)思想,将程序中所有功能点划分为:需要登录与无需登录两种类型,即两个切面。对于切面的区分即可采用注解。
反射
通过 java 语言中的反射机制可以操作字节码文件(可以读和修改字节码文件。) 通过反射机制可以操作代码片段。(class 文件。)Reflection(反射)是 Java 被视为动态语言的关键,反射机制允许程序在执行期借助于 Reflection API 取得任何类的内部信息,并能直接操作任意对象的内部属性及方法
(3)、RUNTIME
反射是一开始并不知道我要初始化的类是什么,自然也无法使用 new 关键字来创建对象了。这时候,我使用 JDK 提供的反射 API 进行反射调用。**反射就是在运行状态中,对于任意一个类,都能够知道这个类的所有属性和方法;对于任意一个对象,都能够调用它的任意方法和属性;并且能改变它的属性。**是 Java 被视为动态语言的关键。
通过 java 语言中的反射机制可以操作字节码文件(.class)注解保留至运行期,意味着我们能够在运行期间结合反射技术获取注解中的所有信息
实例化
Demo demo = new Demo();
1)右边的“new Demo”,是以 Demo 类为模板,在堆空间里创建一个 Demo 类对象(也简称为 Demo 对象)。
2)末尾的()意味着,在对象创建后,立即调用 Demo 类的构造函数,对刚生成的对象进行初始化。构造函数是肯定有的。如果你没写,Java 会给你补上一个默认的构造函数。
3)左边的“Demo demo”创建了一个 Demo 类引用变量。所谓 Demo 类引用,就是以后可以用来指向 Demo 对象的对象引用。
4)“=”操作符使对象引用指向刚创建的那个 Demo 对象。demo 此时应该叫对象引用,它存储在栈中,保存了对象在堆中的地址
3.实例化对象的语法:
类名 引用变量名 = new 构造器名() ;4.访问成员属性或成员方法一般语法是:
引用成员变量名.成员名JVM
是运行不同 bytecode 的虚拟机。JVM 有针对不同系统的特定实现(Windows,Linux,macOS),目的是使用相同的字节码,它们都会给出相同的结果。可移植性高。字节码是 JVM 理解的代码(.class)。而且,由于字节码并不针对一种特定的机器,因此,Java 程序无须重新编译便可在多种不同操作系统的计算机上运行。
native 方法是通过 java 中的 JNI 实现的。JNI 是 Java Native Interface 的 缩写。从 Java 1.1 开始,Java Native Interface (JNI)标准成为 java 平台的一部分,它允许 Java 代码和其他语言写的代码进行交互。
JNI 一开始是为了本地已编译语言,尤其是 C 和 C++而设计 的,但是它并不妨碍你使用其他语言,只要调用约定受支持就可以了。
分为程序计数器、虚拟机栈、本地方法栈 3 个区域
为什么要有程序计数器? 为了保证程序(在操作系统中理解为进程)能够连续地执行下去,CPU 必须具有某些手段来确定下一条指令的地址。而程序计数器正是起到这种作用,所以通常又称为指令计数器。
- 线程私有。为了记录线程字节码的指令地址
- 执行java方法时,程序计数器是有值的,执行native本地方法时,程序计数器的值为空。
- 程序计数器,是唯一一个在 java 虚拟机规范中没有规定任何OutOfMemoryError的区域。
- 程序计数器占用内存很小,在进行JVM内存计算时,可以忽略不计。
JVM 内存(Data area)
运行步骤:
1.方法区(Method Area)与 Java 堆一样,是各个线程共享的内存区域。
2.方法区在 JVM 启动的时候被创建,并且它的实际的物理内存空间中和 Java 堆区一样都可以是不连续的。
3.方法区的大小,跟堆空间一样,可以选择固定大小或者可扩展。
4.方法区的大小决定了系统可以保存多少个类,如果系统定义了太多的类(加载大量第三方 jar 包、tomcat 部署的工程过多、大量动态生成反射类),导致方法区溢出,虚拟机同样会抛出内存溢出错误:java.lang.OutOfMemoryError: PermGen space(jdk7 以前)或者 java.lang.OutOfMemoryError: Metaspace(jdk8 以后)
5.关闭 JVM 就会释放这个区域的内存。
Garbage collection
在 JVM 五种内存模型中,有三个是不需要进行垃圾回收的:程序计数器、JVM 栈、本地方法栈。因为它们的生命周期是和线程同步的,随着线程的销毁,它们占用的内存会自动释放,所以只有方法区和堆需要进行 GC。
在 Java 中,没有任何引用的对象就是一个垃圾。2 方法判断:引用计数法,和可达性分析算法。
1。在当前的 jvm 中并没有采用,原因是他并不能解决对象之间循环引用的问题。 假设有 A 和 B 两个对象之间互相引用,也就是说 A 对象中的一个属性是 B,B 中的一个属性时 A,这种情况下由于他们的相互引用,从而是垃圾回收机制无法识别。
因为引用计数法的缺点有引入了可达性分析算法: 通过判断对象的引用链是否可达来决定对象是否可以被回收。
按代的垃圾回收机制
新生代(Young generation):绝大多数最新被创建的对象都会被分配到这里,由于大部分在创建后很快变得不可达,很多对象被创建在新生代,然后“消失”。对象从这个区域“消失”的过程我们称之为:Minor GC 。
老年代(Old generation):对象没有变得不可达,并且从新生代周期中存活了下来,会被拷贝到这里。其区域分配的空间要比新生代多。也正由于其相对大的空间,发生在老年代的 GC 次数要比新生代少得多。对象从老年代中消失的过程,称之为:Major GC 或者 Full GC。
**持久代(Permanent generation)**也称之为 方法区(Method area):用于保存类常量以及字符串常量。注意,这个区域不是用于存储那些从老年代存活下来的对象,这个区域也可能发生 GC。发生在这个区域的 GC 事件也被算为 Major GC 。只不过在这个区域发生 GC 的条件非常严苛,必须符合以下三种条件才会被回收:
1、所有实例被回收
2、加载该类的 ClassLoader 被回收
3、Class 对象无法通过任何途径访问(包括反射)
什么时候进行回收
1.会在 cpu 空闲的时候自动进行回收 2.在堆内存存储满了之后 3.主动调用 System.gc()后尝试进行回收
如何回收
标记-清除”(Mark-Sweep)算法,如同它的名字一样,算法分为“标记”和“清除”两个阶段:首先标记出所有需要回收的对象,在标记完成后统一回收所有被标记的对象 “标记-整理”(Mark-Compact)算法,标记过程仍然与“标记-清除”算法一样,但后续步骤不是直接对可回收对象进行清理,而是让所有存活的对象都向一端移动,然后直接清理掉端边界以外的内存
CMS 是一个老年代收集器,全称 Concurrent Low Pause Collector,是 JDK1.4 后期开始引用的新 GC 收集器,在 JDK1.5、1.6 中得到了进一步的改进。它是对于响应时间的重要性需求大于吞吐量要求的收集器。对于要求服务器响应速度高的情况下,使用 CMS 非常合适。
jVM 变量储存
Stack(local variable and methods)*** 方法内变量
Heap(objects and array)*** 实例变量在对象中,可被垃圾收集
**在 Java 虚拟机中,对象是在 Java 堆中分配内存的,这是一个普遍的常识。**但是,有一种特殊情况,那就是如果经过逃逸分析后发现,一个对象并没有逃逸出方法的话,那么就可能被优化成栈上分配。这样就无需在堆上分配内存,也无须进行垃圾回收了。
(1)程序内存布局场景下,堆与栈表示两种内存管理方式;
实际内存地址空间中的堆和栈与数据结构中的有区别 内存中的栈区处于相对较高的地址,以地址的增长方向为上的话,栈地址是向下增长的。
栈中分配局部变量空间,堆区是向上增长的用于分配程序员申请的内存空间。 另外还有静态区是分配静态变量,全局变量空间的。 只读区是分配常量和程序代码空间的;以及其他一些分区。
private` `static` `int` `ii = ``2``; ``// 方法区(jdk7之前) -> 堆(jdk7及以后) ``private` `static` `String ss``/*引用:方法区(jdk7之前) -> 堆(jdk7及以后)*/` ``// 常量 ``private` `final` `int` `iii = ``3``;``// 方法区(jdk7之前) -> 堆(jdk7及以后) ``private` `final` `String sss``/*引用:方法区(jdk7之前) -> 堆(jdk7及以后)*/` `= ``new` `String(``"c"``)``/*对象实例:堆*/``; ``// 静态常量 ``private` `final` `static` `String ssss``/*引用:方法区(jdk7之前) -> 堆(jdk7及以后)*/` `= ``new` `String(``"d"``)``/*对象实例:堆*/``;Dynamic binding
c 当 apparent type(reference variable) is called in a method, JVM 编译时首先检查 多态中的 superclass,然后 actual class of object 被检查。就是决定调用哪个方法 at runtime
JVM 使用 invokevirtual 指令来调用与 C++ 虚拟方法等效的 Java。在 C++ 中,如果我们想要覆盖另一个类中的一个方法,我们需要将其声明为虚拟,但在 Java 中,所有方法默认都是虚拟的(除了 final 和静态方法),因为我们可以覆盖子类中的每个方法。在 Java 中,所有非最终非私有、非静态方法都是虚拟的,这意味着可以在子类中覆盖的任何方法都是虚拟的
2、堆栈缓存方式区别
栈使用的是一级缓存, 它们通常都是被调用时处于存储空间中,调用完毕立即释放。
堆则是存放在二级缓存中,生命周期由虚拟机的垃圾回收算法来决定(并不是一旦成为孤儿对象就能被回收)。所以调用这些对象的速度要相对来得低一些。
3、堆栈数据结构区别
堆(数据结构):堆可以被看成是一棵树,如:堆排序。
栈(数据结构):一种先进后出的数据结构。
object 的 life 取决于 references
Class variable ,methods use:STATIC
static{ } //set static final 常量
static final 变量在静态存储空间,被所有线程共享。static final 变量可以在定义时初始化。static final 变量可以在静态代码块中初始化。 final 成员变量存储在对象中,不同对象有不同的值。 final 变量可以在定义时初始化。 final 变量可以在构造函数中初始化。
类加载过程 及 双亲委派
所有类都由类装载器载入,载入内存中的类对应一个 java.lang.Class 实例。
类从被加载到内存中开始,到卸载出内存,经历了加载、连接、初始化、使用5 个阶段,其中连接又包含了验证、准备、解析三个步骤。这些步骤总体上是按照图中顺序进行的

4、解析 虚拟机将用于标识引用的符号替换为实际指向的引用的地址。符号或符号引用只不过是个标识(描述符),而实际地址才是真正的目的内存位置。
解析动作主要针对:类或接口、字段(类成员变量)、类方法、接口方法等引用进行。
类或接口的解析:判断所要转化成的直接引用是对数组类型,还是对普通的对象类型的引用,从而进行不同的解析。 字段解析:对字段进行解析时,会先在本类中查找是否包含有简单名称和字段描述符都与目标相匹配的字段,如果有,则查找结束;如果没有,则会按照继承关系从上往下递归搜索该类所实现的各个接口和它们的父接口,还没有,则按照继承关系从上往下递归搜索其父类,直至查找结束,查找流程如下图所示:
最后需要注意:理论上是按照上述顺序进行搜索解析,但在实际应用中,虚拟机的编译器实现可能要比上述规范要求的更严格一些。如果有一个同名字段同时出现在该类的接口和父类中,或同时在自己或父类的接口中出现,编译器可能会拒绝编译。
类方法解析:对类方法的解析与对字段解析的搜索步骤差不多,只是多了判断该方法所处的是类还是接口的步骤,而且对类方法的匹配搜索,是先搜索父类,再搜索接口。 接口方法解析:与类方法解析步骤类似,由于接口不会有父类,因此,只递归向上搜索父接口就行了。
- 初始化
给类的静态变量初始化值,不同于准备阶段,此处是使用用于自定义的值进行赋值。
为什么说 java 解释和编译并存?
从.class 到机器码 Java 通过解释器逐行解释执行,后面引入的 JIT 编译器运行效率高。当 JIT 编译器完成第一次编译后,其会将字节码对应的机器码保存下来,下次可以直接使用。
解释性语言在运行程序的时候才翻译(java,Python),比如解释性 basic 语言,专门有一个解释器能够直接执行 basic 程序,每个语句都是执行的时候才翻译。这样解释性语言每执行一次就要翻译一次,效率比较低。编译型语言(C)写的程序执行之前,需要一个专门的编译过程,把程序编译成为机器语言的文件,比如 exe 文件,以后要运行的话就不用重新翻译了,直接使用编译的结果就行了(exe 文件),因为翻译只做了一次,运行时不需要翻译,所以编译型语言的程序执行效率高。
8 个二进制位为一个字节单位。一个英文字母(不分大小写)占一个字节的空间,一个中文汉字占两个字节的空间。英文标点占一个字节,中文标点占两个字节
泛型(generics)
Java 泛型(generics)是 JDK 5 中引入的一个新特性, 泛型提供了编译时类型安全检测机制,该机制允许程序员在编译时检测到非法的类型。泛型的本质是参数化类型,也就是说所操作的数据类型被指定为一个参数。
- 强化类型安全,由于泛型在编译期进行类型检查,从而保证类型安全,减少运行期的类型转换异常。
- 消除强制转换
- 类型依赖关系更加明确,接口定义更加优好,增强了代码和文档的易读性。
//表示类型参数可以是任何类型 public class Apple<?>{}
//表示类型参数必须是 A 或者是 A 的子类
public class Apple
//表示类型参数必须是 A 或者是 A 的超类型
public class Apple
泛型一般有三种使用方式:泛型类、泛型接口、泛型方法。
ArrayList<E>中的E称为类型变量或者类型形参整个ArrayList<Integer>称为参数化的类型Lambda
1.8 后特性, 目的 简化代码 形式:( parameter-list ) -> { expression-or-statements }
原来我们创建一个线程并启动它是这样的:
public class LamadaTest { public static void main(String[] args) { new Thread(new Runnable() { @Override public void run() { System.out.println("沉默王二"); } }).start(); }}通过 Lambda 表达式呢?只需要下面这样:
public class LamadaTest { public static void main(String[] args) { new Thread(() -> System.out.println("沉默王二")).start(); }}使用场景
一、列表循环 1.增强 for 循环写法:
List<Integer> list = Arrays.asList(1, 2, 3, 4, 5);for (Integer integer : list) { System.out.print(integer+" ");}2.lambda 表示写法:
list.forEach(x-> System.out.print(x+" "));//如果只需要调用单个函数对列表元素进行处理,那么可以使用更加简洁的 方法引用 代替 Lambda 表达式:list.forEach(System.out::print);二、事件监听 1.匿名函数写法:
new JButton().addActionListener(new ActionListener() { @Override public void actionPerformed(ActionEvent e) { // handle the events }});2.lambda 表达式写法:
// 这里主要体现为 比写匿名函数更简洁new JButton().addActionListener(e -> { // handle the events});三、代替 Runnable 1.通常写法:
new Runnable() { @Override public void run() { System.out.println("hello world"); }};2.lambda 表达式写法:
Runnable runnable = () -> System.out.println(“hello world”);
四、Map 映射
List<Integer> list1 = Arrays.asList(1, 2, 3, 4, 5);List<Integer> collect = list1.stream().map(x -> x * 2).collect(Collectors.toList());collect.forEach(System.out::println);五、Reduce 聚合1.增强for循环写法:int result = 0;for (Integer number : numbers) { result+=number;}2.lambda 表达式写法:
List<Integer> numbers = Arrays.asList(1, 2, 3, 4, 5);int sum = numbers.stream().reduce((x, y) -> x + y).get();数据类型
JDK1.6 及以前,常量池在方法区,这时的方法区也叫做永久代; JDK1.7 的时候,方法区合并到了堆内存中,这时的常量池也可以说是在堆内存中; JDK1.8 及以后,方法区又从堆内存中剥离出来了,但实现方式与之前的永久代不同,这时的方法区被叫做元空间,常量池就存储在元空间。
A servlet is deployed in a container. life cycle: init() service() destroy()
Java 中使用 final 关键字来修饰常量
自动类型转换:
低 ------------------------------------> 高计算时低的类型转换为高的,然后运算byte,short,char—> int —> long—> float —> double强制类型转换
强制转换的格式是在需要转型的数据前加上“( )”,然后在括号内加入需要转化的数据类型。有的数据经过转型运算后,精度会丢失,而有的会更加精确,
- x = (int)34.56 + (int)11.2; // 丢失精度
- y = (double)x + (double)10 + 1; // 提高精度
OO 面向对象
对象与类
class only exists at compile time; an object only exists at runtime
对象有 attributes(instance variable) and operations(methods)
local variable versus. instance variable
- 局部变量未被初始化 parameter is virtually the same as local variable
- 实例变量在类中 valid 被声明,且被初始化。多线程中,实例变量是多个线程共享资源,要注意同步访问时可能出现的问题
- 类变量用 static 声明,一个对象修改了变量,则所以对象中这个变量的值都会发生改变
构造器
构造器的继承 子类构造器会默认调用父类无参构造器,如果父类没有无参构造器,则必须在子类构造器的第一行通过 super 关键字指定调用父类的哪个构造器,具体看下文例子。final 类是不允许被继承的,编译器会报错。很好理解,由于 final 修饰符指的是不允许被修改,而继承中,子类是可以修改父类的,这里就产生冲突了,所以 final 类是不允许被继承的。
- 只有一对花括号包裹起来的代码我们称之为构造代码块。
- 构造代码块与构造方法一样都是在类被实例化的过程中被调用的。
父类静态代码块 > 子类静态代码块 > 父类构造代码块 > 父类构造器 > 子类构造代码块 > 子类构造器
首先是类的初始化,先要初始化 main 方法所在的类,即 Son 类,因为 Son 继承了 Father 类,所以要先初始化 Father 类 Father 类的初始化是从静态变量和静态代码块顺序执行,也就是先打印 5,再打印 1Son 类的初始化逻辑相同,先打印 10,再打印 6 然后是实例的初始化,同样 Son 继承了 Father,那么需要先初始化 Father 的实例 father 实例的初始化顺序应该是 9,3(Son 类重写了 test 方法)、2,变量赋值和非静态代码块顺序执行,构造方法最后执行。son 实例的初始化顺序为 9、8、7 第二个 son 实例的初始化同第二步所以最后的答案为:5、1、10、6、9、3、2、9、8、7
特性:继承、多态、封装
多态
(Polymorphism)按字面的意思就是“多种状态”。在 Java 中多态性是允许你将父对象设置成为和一个或更多的他的子对象相等的技术,赋值之后,父对象就可以根据当前赋值给它的子对象的特性以不同的方式运作。 父类引用指向子类对象
多态,指允许不同类的对象对同一消息做出响应。即同一消息可以根据发送对象的不同而采用多种不同的行为方式。(发送消息就是函数调用)简单的说,就是一句话:允许将子类类型的指针赋值给父类类型的指针(申明:Java 中并没有指针这一说法,但是有引用的地方就会有指针)。 **解说:**在一般的继承关系中,总是父类给予子类更多的财富,让子类拥有更多的功能,而多态讲的是子类对父类的孝敬。只要将子类类型的指针赋值给父类类型的指针,那么我们就可以把父类当做子类来看待,也就是说,我们可以通过父类来使用子类的方法。这就是所说的父子情深。
(2)作用
通过继承和多态,我们可以实例化一个父类对象,把各个子类当做父类的一个状态,当我们需要某个子类的时候,我们就借用指针,来得到相应子类的方法。经过这样处理,我们可以利用父类多态,方便的使用其所有子类的方法,从而使我们面对一个统一的对象(父类)来处理多种状态下的情况。
(3)体现
必要条件 要有继承; 要有重写; 父类引用指向子类对象。
多态的方面,分为向上转型和向下转型。
假定父类为 动物,子类为狗,父类有一个方法发声(),狗继承并覆盖了一个发声方法。在子类重写该方法
则(以下过程 c#实现):动物 a=new 狗();//这就为向上转型 a.发声();
在调用 a.发声();时调用的是狗的发声()也可调动物类其他方法 但不能调用狗类方法
若修改为动物 a=new 狗();
狗 b=(狗)a;//这里向下转型
Dynamic Binding 动态绑定是指在执行期间(非编译期)判断所引用对象的实际类型,根据其实际的类型调用其相应的方法。程序运行过程中,把函数(或过程)调用与响应调用所需要的代码相结合的过程称为动态绑定。程序在 JVM 运行过程中,会把类的类型信息、static 属性和方法、final 常量等元数据加载到方法区,这些在类被加载时就已经知道,不需对象的创建就能访问的,就是静态绑定的内容;需要等对象创建出来,使用时根据堆中的实例对象的类型才进行取用的就是动态绑定的内容。
继承与类
类和类之间的关系有三种:is-a、has-a 和 use-a 关系。
is-a 关系也叫继承 inheritance 或泛化,比如学生和人的关系、手机和电子产品的关系都属于继承关系。
public class Penguin extends Animal { public Penguin(String myName, int myid) { super(myName, myid); }}has-a 关系通常称之为聚类(关联)aggregation,比如部门和员工的关系,汽车和引擎的关系都属于关联关系;关联关系如果是整体和部分的关联,那么我们称之为聚合关系;如果整体进一步负责了部分的生命周期(整体和部分是不可分割的,同时同在也同时消亡),那么这种就是最强的关联关系,我们称之为合成关系。 use-a 关系通常称之为依赖,比如司机有一个驾驶的行为(方法),其中(的参数)使用到了汽车,那么司机和汽车的关系就是依赖关系。
Delegation(委托)
委托依赖于动态绑定,因为它要求特定的方法可以在运行时调用不同的代码段。不使用继承,而是利用委托结合 A,达到复用 A 类中代码
subclass 只有一个 parent
Private 方法不能继承且不能被子类 seen
UML 类之间的关系
5 种关系从弱到强
- 依赖(dependency)use-a , has-a
- 关联(association)
- 聚合(aggregation)
- 组合(composition)
- 继承(inheritance)可以更加细得分为
实现(realization)和泛化(generalization)实现和泛化`,实现就是类实现接口,泛化就是类继承类、类继承抽象类、接口继承接口。 如是实现的话,那么子类就不能够在扩充方法,如果是泛化的话,可以在父类基础上再次扩充自己的方法。
is-a 关系也叫继承 inheritance 或泛化,比如学生和人的关系、手机和电子产品的关系都属于继承关系。
has-a 关系通常称之为聚类(关联)aggregation、dependency,比如部门和员工的关系,汽车和引擎的关系都属于关联关系;关联关系如果是整体和部分的关联,那么我们称之为聚合关系;如果整体进一步负责了部分的生命周期(整体和部分是不可分割的,同时同在也同时消亡),那么这种就是最强的关联关系,我们称之为合成关系。 use-a 关系通常称之为依赖,比如司机有一个驾驶的行为(方法),其中(的参数)使用到了汽车,那么司机和汽车的关系就是依赖关系。
聚合关系是“has-a”关系,组合关系是“contains-a”关系;聚合关系表示整体与部分的关系比较弱,而组合比较强;聚合关系中代表部分事物的对象与代表聚合事物的对象的生存期无关,一旦删除了聚合对象不一定就删除了代表部分事物的对象。组合中一旦删除了组合对象,同时也就删除了代表部分事物的对象
封装 Encapsulation
封装是指把一个对象的状态信息(也就是属性)隐藏在对象内部,不允许外部对象直接访问对象的内部信息。但是可以提供一些可以被外界访问的方法来操作属性。就好像我们看不到挂在墙上的空调的内部的零件信息(也就是属性),但是可以通过遥控器(方法)来控制空调。如果属性不想被外界访问,我们大可不必提供方法给外界访问。但是如果一个类没有提供给外界访问的方法,那么这个类也没有什么意义了。就好像如果没有空调遥控器,那么我们就无法操控空凋制冷,空调本身就没有意义了(当然现在还有很多其他方法 ,这里只是为了举例子)。
Abstract class
抽象是相对于具体而言的,一般而言,具体类有直接对应的对象,而抽象类没有,它表达的是抽象概念,一般是具体类的比较上层的父类。比如说,狗是具体对象,而动物则是抽象概念,樱桃是具体对象,而水果则是抽象概念,正方形是具体对象,而图形则是抽象概念。下面我们通过一些例子来说明 Java 中的抽象类。
图形类 Shape,它有一个方法 draw(),Shape 其实是一个抽象概念,它的 draw 方法其实并不知道如何实现,只有子类才知道。这种只有子类才知道如何实现的方法,一般被定义为抽象方法。
- The compiler will not let you instantiate an abstract class ///abstractin terms of classesthat class must be extended, in order to be instantiated•abstractfor methodsthe method must be overridden in the child class
- 子类必须 implement superclass 的所有抽象方法,但父类可以没有抽象方法,有抽象方法的一定是抽象类。
- 抽象方法也不能用 static 修饰,试想一下,如果用 static 修饰了,那么我们可以直接通过类名调 用,抽象类不能被实例化.
- 抽象类中的抽象方法只是声明,不包含方法体,就是不给出方法的具体实现也就是方法的具体功能。
抽象方法不能用 private 修饰,因为抽象方法必须被子类实现(覆写),而 private 权限对于子类来 说是不能访问的,所以就会产生矛盾
ADvantage:1、由于抽象类不能被实例化,最大的好处就是通过方法的覆盖来实现多态的属性。也就是运行期绑定 2、抽象类将事物的共性的东西提取出来,由子类继承去实现,代码易扩展、易维护。
子类继承父类执行顺序
SonTest.java
  public class SonTest extends FatherTest {
  // 然后再加入一个main函数  public static void main(String[] args) {  System.out.println("--子类主程序--");  FatherTest father = new FatherTest("父亲的名字");  father.speak();  SonTest son = new SonTest("儿子的名字");  son.speak();  }  }
1.先父再子,执行子类的重写方法
[https://img2018.cnblogs.com/blog/1080293/201809/1080293-20180927140643561-1197079835.jpg]

2.静态代码块—主程序—非静态代码块—构造函数—一般方法
(Override)与(Overload)

重写是子类对父类的允许访问的方法的实现过程进行重新编写, 返回值和形参都不能改变。即外壳不变,核心重写!
重写的好处在于子类可以根据需要,定义特定于自己的行为。 也就是说子类能够根据需要实现父类的方法。
重写方法不能抛出新的检查异常或者比被重写方法申明更加宽泛的异常。例如: 父类的一个方法申明了一个检查异常 IOException,但是在重写这个方法的时候不能抛出 Exception 异常,因为 Exception 是 IOException 的父类,只能抛出 IOException 的子类异常。
在面向对象原则里,重写意味着可以重写任何现有方法。如下 方法 1.super
public class A { private String nameA="A"; public void getName() { System.out.println("父类"+nameA); } public static void main(String[] args) { }}public class B extends A{ private String nameB="B"; @Override //注解重写方法 public void getName() { System.out.println("子类"+nameB); super.getName(); } public static void main(String[] args) { B b=new B(); b.getName(); }}Output:子类B父类Akeyword : super. 调用父类方法、变量(非 private 修饰) super()调用父类构造器
What is the relation between class and object?
变量初始化
三类:1.类的属性
对于第一种变量,Java 虚拟机会自动进行初始化。如果给出了初始值,则初始化为该初始值。如果没有给出,则把它初始化为该类型变量的默认初始值。
int 类型变量默认初始值为 0 float 类型变量默认初始值为 0.0f double 类型变量默认初始值为 0.0boolean 类型变量默认初始值为 false char 类型变量默认初始值为 0(ASCII 码) long 类型变量默认初始值为 0 所有对象引用类型变量(String,Array)默认初始值为 null,即不指向任何对象。
注意数组本身也是对象,所以没有初始化的数组引用在自动初始化后其值也是 null。
语法
高级 for()
int[] nums = {10,20,30,40,50};//方法一:通过数组下标进行遍历for(int i=0;i<nums.length;i++){int n = nums[i];System.out.println(n);}//方法二:使用for-each进行遍历 for(datatype x: nums) for(int i : index)的意思就是说,遍历index数组,每次遍历的对象用i 这个对象去接收。 相当于: int i=0; //用于接收index数组中的某一个对象 for(int j = 0;j<index.length;j++){ i = index[j]; }for(int n:nums){System.out.println(n);}编译运行
类——对象——属性、方法
一个文件中只能有一个 public class,表示公开接口。虚拟机会找 public 类中的 main 方法
第 2、 public 类的名字必须和这个编译单元的文件名彻底相同,包括大小写。
对于一个 public 类,它是能够被项目中任何一个类所引用的,只需在使用它前 import 一下它所对应的 class 文件便可。将类名与文件名一一对应就能够方便虚拟机在相应的路径(包名)中找到相应的类的信息。若是不这么作的话,就很难去找,并且开销也会很大。
java 中的修饰符分为类修饰符,字段修饰符,方法修饰符。根据功能的不同,主要分为以下五种。
权限访问修饰符
public,protected,default,private,这四种级别的修饰符都可以用来修饰类、方法和字段。
public–publicinstance variables and methods are inherited•
protected–protectedinstance variables and methodsare inherited•
private– any privateinstance variables and methodsare not inherited and cannot be seen by the subclass
(一般实例变量用 private 修饰)
private int[] age; //private 封装了 class 中的 age 属性
非访问修饰符
抽象方法控制符 abstract 、静态方法控制符 static 、最终方法控制符 final 、本地方法控制符 native 、同步方法控制符 synchronized
(1)抽象方法控制符 abstract : 抽象类不能用来实例化对象,声明抽象类的唯一目的是为了将来对该类进行扩充。
一个类不能同时被 abstract 和 final 修饰。如果一个类包含抽象方法,那么该类一定要声明为抽象类,否则将出现编译错误。
抽象类可以包含抽象方法和非抽象方法。
(2)静态方法控制符 static :用修饰符 static 修饰的方法称为静态方法。静态方法是属于整个类的类方法;而不使用 static 修饰、限定的方法是属于某个具体类对象的方法。 由于 static 方法是属于整个类的,所以它不能操纵和处理属于某个对象的成员变量,而只能处理属于整个类的成员变量,即 static 方法只能处理 static 的域。
(3)最终方法控制符 final :final 类不能被继承;final 方法不能重写,可被继承;final 成员变量可以继承。
用修饰符 final 修饰的方法称为最终方法。最终方法是功能和内部语句不能更改的方法,即。final 固定了方法所具有的功能和操作,防止当前类的子类对父类关键方法的错误定义,保证了程序的安全性和正确性。所有被 private 修饰符限定为私有的方法,以及所有包含在 final 类 ( 最终类)不能被 extends
当变量是 final 时,通过将 final 局部变量”复制”一份,复制品直接作为局部内部中的数据成员.这样:当局部内部类访问局部变量 时,其实真正访问的是这个局部变量的”复制品”(即:这个复制品就代表了那个局部变量).因此:类内其他方法访问局部变量需要设置其为 final
(4)本地方法控制符 native :用修饰符 native 修饰的方法称为本地方法。为了提高程序的运行速度,需要用其它的高级语言书写程序的方法体,那么该方法可定义为本地方法用修饰符 native 来修饰。
(5)同步方法控制符 synchronized :该修饰符主要用于多线程程序中的协调和同步
Static keyword
!https://images2018.cnblogs.com/blog/1295451/201808/1295451-20180815143157281-699250705.png

static 静态成员变量:被所有对象共享,无需初始化变量,方便调用
静态成员变量虽然独立于对象,但是不代表不可以通过对象去访问,所有的静态方法和静态变量都可以通过对象访问(只要访问权限足够)。 this 访问
this.方法名称
用来访问本类的成员方法
this(); //访问本类的构造方法
static final:定义常量
static 方法:可重写不能重载,隐藏,其中不能使用非静态方法(main 中不能直接调用非静态方法),不能使用非静态变量
instance method can invoke static method
想在不创建对象的情况下调用某个方法,就可以将这个方法设置为 static。我们最常见的 static 方法就是 main 方法,只能访问 static 变量。因为程序在执行 main 方法的时候没有创建任何对象,因此只有通过类名来访问。
import
-
单类型导入(single-type-import) (例:import java.util.ArrayList; )
-
按需类型导入(type-import-on-demand) (例:import java.util.*;)
java 以这样两种方式导入包中的任何一个 public 的类和接口
String
String 的底层是一个用 private 和 final 修饰的 char 数组。final 可以保证数组的的引用地址不会被改变,private 不允许外部访问可以保证数组的值不会被修改,这样就能保证 String 类的不可变性。是对象不是基本数据类型
- 因为 String 类的不可变性,才能使得 JVM 可以实现字符串常量池;字符串常量池可以在程序运行时节约很多内存空间,因为不同的字符串变量指向相同的字面量时,都是指向字符串常量池中的同一个对象。这样一方面能够节约内存,另一方面也提升了性能。
- 因为 String 类的不可变性,从而保证了字符串对象在多线程环境下是线程安全的。
常量池(constant pool)指的是在编译期被确定,并被保存在已编译的.class 文件中的一些数据。它包括了关于类、方法、接口等中的常量,也包括字符串常量。
对字符串常量池进行总结:
当用 new 关键字创建字符串对象时, 不会查询字符串常量池; 当用双引号直接声明字符串对象时, 虚拟机将会查询字符串常量池.
说白了就是: 字符串常量池提供了字符串的
复用
功能,
除非我们要显式创建新的字符串对象
, 否则对同一个字符串虚拟机只会维护一份拷贝。
!https://img-blog.csdnimg.cn/img_convert/9b21555ad4b131f7b86d599a6d465f51.png

 private String s/*引用:堆*/ = new String("a")/*对象实例:另一块堆空间中*/;private String s1/*引用:堆*/ = "aa"/*字面量aa:字符串常量池*/;// 字符串常量池是运行时常量池的一部分,在jdk7之前位于方法区,jdk7开始移至堆中String a = "hello2";String b = "hello";String c = b + 2;System.out.println((a == c));输出结果为:false。由于有符号引用的存在,所以  String c = b + 2;不会在编译期间被优化,不会把b+2当做字面常量来处理的
String a = "hello2";final String b = "hello";String c = b + 2;System.out.println((a == c));输出结果为:true。对于被final修饰的变量,会在class文件常量池中保存一个副本,也就是说不会通过连接而进行访问
StringBuffer and StringBuilder
- 操作少量的数据: 适用 String
- 单线程操作字符串缓冲区下操作大量数据: 适用 StringBuilder are mutable
- 多线程操作字符串缓冲区下操作大量数据: 适用 StringBuffer are mutable
String <—> 包装类
String —> Integer: Integer i1 = new Integer(“12”); 或者 Integer i1 = Integer.valueOf(“12”) 包装类 —> String: String str = 任何对象.toString();
Stringbuffer(synchronisation) vs. new StringBuilder(“cat”); 5.0 后新方法
Scanner class
1.把 word 当成 delimiter myScanner.next()
2.读取 primitive type values
3.Reading console input : new Scanner(System.in)
equals ==区别
== 对于基本数据类型来说,比较的是值。对于引用数据类型来说,比较的是对象的内存地址。
因为 Java 只有值传递,所以,对于 == 来说,不管是比较基本数据类型,还是引用数据类型的变量,其本质比较的都是值,只是引用类型变量存的值是对象的地址。
equals() 作用不能用于判断基本数据类型的变量,只能用来判断两个对象是否相等。equals()方法存在于Object类中,而Object类是所有类的直接或间接父类。
“equals()` 方法存在两种使用情况:
- 类没有覆盖
equals()方法 :通过equals()比较该类的两个对象时,等价于通过“==”比较这两个对象,使用的默认是Object类equals()方法。 - 类覆盖了
equals()方法 :一般我们都覆盖equals()方法来比较两个对象中的属性(值)是否相等;若它们的属性(值)相等,则返回 true(即,认为这两个对象相等)。
举个例子:
public class test1 {    public static void main(String[] args) {        String a = new String("ab"); // a 为一个引用  堆内存“ab”        String b = new String("ab"); // b为另一个引用,对象的内容一样        String aa = "ab"; // 放在常量池中        String bb = "ab"; // JVM从常量池中查找 bb指向同一地址        if (aa == bb) // true            System.out.println("aa==bb");
        if (a == b) // false,非同一对象            System.out.println("a==b");        if (a.equals(b)) // true            System.out.println("aEQb");        if (42 == 42.0) { // true            System.out.println("true");        }    }}Copy to clipboardErrorCopied
说明:
- 若当前对象和比较的对象是同一个对象,即 return true。也就是 Object 中的 equals 方法。 若当前传入的对象是 String 类型,则比较两个字符串的长度,即 value.length 的长度。 若长度不相同,则 return false 若长度相同,则按照数组 value 中的每一位进行比较,不同,则返回 false。若每一位都相同,则返回 true。 若当前传入的对象不是 String 类型,则直接返回 false
- 当创建
String类型的对象时,虚拟机会在常量池中查找有没有已经存在的值和要创建的值相同的对象,如果有就把它赋给当前引用。如果没有就在常量池中重新创建一个String对象。
一、equeals 相等,那么 hashCode 一定相等
二、hashCode 相等,那么 equals 不一定返回 true
三、hashCode 不相等,那么 equals 一定不相等
为什么有了 equals 这样有效的方法还需要 hashCode 呢?
因为:
在 HashSet(特性:不含有重复的内容),有新对象加入时,会先计算对象的 HashCode 值来判断对象加入的位置,同时于已有的对象 hashCode 作比较,如果有相同的,再用 equals 去比较,若相同那么则不加入 hashSet,若不相同,会使其加入到其他的位置。如果没有其他对象 hashCode 与之相同的,那么这个对象必定是一个新对象,这样就减少了 equals 的执行次数、先用 hashCode 去比较,从而大大提高了速度
将 String 转换成 int int guess = Integer.parseInt(StringGuess)
ArrayList
Array 数组和 ArrayList 区别? 首先,ArrayList 是基于数组实现的,他存储的是引用类型 ArrayList 是接口 List 的实现类,而且 java 为其提供了丰富的增删改查等方法,使用起来较为较为方便。 数组,只能存储单一的数据类型,一旦数组的长度给定无法改变 扩展:ArrayList 不是线程安全的,只能用在单线程环境下, 多线程环境下可以考虑用 Collections.synchronizedList(List l)方法返回一个线程安全的 ArrayList 类,也可以使用 concurrent 并发包下的 CopyOnWriteArrayList 类。
什么时候应该使用 Array 而不是 ArrayList? 对于基本类型数据,集合使用自动装箱来减少编码工作量。但是,当处理固定大小的基本数据类型的时 候,这种方式相对比较慢
在数组声明中包含数组长度永远是不合法的!如:int[l5] arr; 。因为,声明的时候并没有实例化任何对象,只有在实例化数组对象时,JVM 才分配空间,这时才与长度有关。在数组构造的时候必须指定长度,因为 JVM 要知道需要在堆上分配多少空间。数组不是集合,它只能保存同种类型的多个原始类型或者对象的引用
arraylist:建立在 heap 上 ArrayList
是一个特殊的数组—动态数组。来自于 System.Collections 命名空间;通过添加和删除元素,就可以动态改变数组的长度。
ArrayList arr = new ArrayList(3);//初始容量为3ArrayList<String> arr = new ArrayList<E>();ArrayList arr1 = new ArrayList(); //不初始化刚开始的数组容量,当数组容量满时数组会自动一当前数组容量的2倍扩容arr.add()arr.remove()arr.size() arr.get()boolean inIt = arr.constains(f)arr.isEmpty()JAVA library API
API(Application Programming Interface,应用程序编程接口)是一些预先定义的函数或类,目的是提供应用程序与开发人员基于某软件或硬件的以访问一组的能力,而又无需访问源码,或理解内部工作机制的细节。
超类:java.lang.Objectis the ultimate parent of EVERY class in java
import java.util.ArrayList; //We need to know what package the class is in
java.lang provides fundamental 自动部署
包括 Math.random()是令系统随机选取大于等于 0.0 且小于 1.0 [0,1)的伪随机 double 值
另一种方法
Math.abs(); Math.round();参数上加 0.5,然后进行下取整
Math.max(a,b);
//生成97-122的int型的整型int` `intValue=(``int``)(Math.random()*``26``+``97``);java.io: input output
java.awt: 画画 painting images, users interfaces
JDK Class Library
Lots of classes in the API are abstract
java.lang— Provides classes that are fundamental to the design of the Java programming language.
java.io— Provides for system input and output through data streams, serialization and the file system.
java.awt— Contains all of the classes for creating user interfaces and for painting graphics and images.
Main 函数 psvm
什么是public因为要在类外面调用main()所以是public为什么是static因为系统开始执行一个程序前,并没有创建main()方法所在类的实例对象,它只能通过类名类调用主方法main()作为程序入口,所以该方法是static为什么是void因为主方法没有返回值为什么main主方法名为什么是String args[]或者String[] args?这表示给主方法传一个字符串数组。String[] args是专门用来接收命令行参数的。并默认从args[0]开始接收,然后依次是args[1]、args[2]、args[3]…并且在命令行的输入的字符串中默认以“ ”为分隔符。 public static void main(String args[]){ String s1=args[0]; String s2=args[1]; String s3=args[2]; System.out.println(s3); } 打开cmd,运行指令 java E i love “China” 输出:China 当输入 ebu java program //ebu==args[0] java==args[1] 当输入 "ebu java program" // args[0] == ebu java programinterface 接口
interface 接口名称 [extends 其他的接口名] { // 声明变量 // 抽象方法,无内容 JDK1.8后可以定义方法by default static}public interface List<E> { public boolean add(E e); public E remove(int index); public void clear(); …}public class LoggingList<E> implements List<E> { private final List<E> list; public LoggingList<E>(List<E> list) { this.list = list; } public boolean add(E e) { System.out.println("Adding " + e); return list.add(e); } // 委托 public E remove(int index) { System.out.println("Removing at " + index); return list.remove(index); } …}有时必须从几个类中派生出一个子类,继承它们所有的属性和方法。但是,Java 不支持多重继承。有了接口,就可以得到多重继承的效果。接口定义的是多个类都要实现的操作,即“what to do”。类可以实现接口,从而覆盖接口中的方法,实现“how to do”。
vs. abstract class
两者的设计思想不同,接口是为了面向抽象特征自顶向下,抽象类是自底向上泛化共有部分. 开发者继承抽象类是为了使用抽象类的属性和行为; 开发者实现接口只是为了使用接口的行为.抽象类是从子类中发现公共部分,然后泛化成抽象类,子类继承该父类即可,但是接口不同。实现它的子类可以不存在任何关系,共同之处。例如猫、狗可以抽象成一个动物类抽象类,具备叫的方法。鸟、飞机可以实现飞 Fly 接口,具备飞的行为,这里我们总不能将鸟、飞机共用一个父类吧!所以说抽象类所体现的是一种继承关系,要想使得继承关系合理,父类和派生类之间必须存在”is-a” 关系,在概念本质上应该是相同的。对于接口则不然,并不要求接口的实现者和接口定义在概念本质上是一致的, 仅仅是实现了接口定义的规则而已。
接口(interface)是抽象方法和常量值的定义的集合。抽象类和接口是配合而非替代关系,它们经常一起使用,接口声明能力,抽象类提供默认实现,实现全部或部分方法,一个接口经常有一个对应的抽象类。
比如说,在 Java 类库中,有:
- Collection 接口和对应的 AbstractCollection 抽象类
- List 接口和对应的 AbstractList 抽象类
- Map 接口和对应的 AbstractMap 抽象类
对于需要实现接口的具体类而言,有两个选择,一个是实现接口,自己实现全部方法,另一个则是继承抽象类,然后根据需要重写方法。
从本质上讲,接口是一种特殊的抽象类,这种抽象类中只包含常量和方法的定义,而没有变量和方法的实现。 /*在 JAVA 中,一个类无法继承自多个类,但是可以实现多个接口,使用关键字 implements 多个接口之间使用“,”隔开 多个接口之间,没有先后顺序 这个类叫做实现类,这个类必须实现所有接口的所有方法 */接口与抽象类的区别:
接口里面不可以实现方法体,抽象类可以实现方法体注:JDK 1.8 以后,接口里可以有静态方法和方法体了。
注:JDK 1.8 以后,接口允许包含具体实现的方法,该方法称为”默认方法”,默认方法使用 default 关键字修饰。更多内容可参考 Java 8 默认方法。
注:JDK 1.9 以后,允许将方法定义为 private,使得某些复用的代码不会把方法暴露出去。更多内容可参考 Java 9 私有接口方法。
接口可以多继承接口,抽象类不可 接口需要被子类实现,抽象类是被子类继承(单一继承)
接口中只能有公有的方法和属性而且****必须赋初始值,抽象类中可以有私有方法和属性
接口中不能存在静态方法,但是属性可以是 final,抽象类中方法中可以有静态方法,属性也可以; 接口的所有的成员必须要 public
4)接口中所有的属性是隐式的 static 和 final 的
public class Bat
implements
Flyable,Bitable;
interface 与抽象类
Qustion:
1.为什么不直接在类里面写对应的方法, 而要多写 1 个接口(或抽象类)?
2.既然接口跟抽象类差不多, 什么情况下要用接口而不是抽象类.
3.为什么 interface 叫做接口呢? 跟一般范畴的接口例如 usb 接口, 显卡接口有什么联系呢?
1.为了使用多态,方便调用时重写 1 个对象方法 而不是重载多个
包装类 wrapper class
当需要存入集合时,将基础数据类型实例封装为 Java 对象。常用的包装类可以分为三类:Character、Number、Boolean
8 种对应 (Integer String Byte Short Long Boolean Double Float)
!https://pic3.zhimg.com/80/v2-7b1127ae4c80b9cae683e32c296da81e_1440w.jpg

自动装箱(Autoboxing):把一个基本类型的变量,直接赋值给对应的包装类变量,或者赋值给 Object 变量(Object 是所有类的父类,子类对象可以直接赋给父类变量----Java 的向上自动转型特性)如:
Integer i=3;或 Object j=4;
    Integer a = 127;当Integer对象封装的数据在1byte的取值范围内,多个对象共享同一个对象空间,即就是同一个对象
•    Integer a1 = 128;
•    Integer b = 127;
•    Integer b1 = 128;
•    System.out.println(a==b);//true•    System.out.println(a1==b1);//false
1 System.out.println(Integer.valueOf("1000")==Integer.valueOf("1000"));   --false2 System.out.println(Integer.valueOf("128")==Integer.valueOf("128"));    --false3 System.out.println(Integer.valueOf("127")==Integer.valueOf("127"));   --true4 System.out.println(Integer.valueOf("-128")==Integer.valueOf("-128"));   --true5 System.out.println(Integer.valueOf("-1000")==Integer.valueOf("-1000"));    --false
自动拆箱(AutoUnboxing):把一个包装类变量,直接赋值给一个基本类型的变量,如:
int a=i;
注意:int b=j;编译会报错,原因是:Java 有向上自动转型特性,但不能自动向下转型,想要转要加强制转换,如:
int b = (Integer)j;
Recursion vs. Iteration
递归(recursion)实际上不断地深层调用函数,直到函数有返回才会逐层的返回,因此,递归涉及到运行时的堆栈开销(参数必须压入堆栈保存,直到该层函数调用返回为止),所以有可能导致堆栈溢出的错误;但是递归编程所体现的思想正是人们追求简洁、将问题交给计算机,以及将大问题分解为相同小问题从而解决大问题的动机。
GUI
Swing 组件
如图所示:swing 组件主要可分为三个部分,后面会详细介绍
(1)顶层容器::常用有 JFrame(默认 size(0)and invisible),JDialog
(2)中间容器:JPanel,JOptionPane,JScrollPane,JLayeredPane 等,主要以 panel 结尾。
(3)基本组件:JLabel,JButton,JTextField,JPasswordField,JRadioButton 等。
java.awt(更慢) vs. javax.swing(more efficient, consistensy across system written by pure JAVA)
Frame 是 Window 的子类,一个 Frame 对象就是一个有标题有边界的顶层窗口。(默认BorderLayout)
Panel 是最简单的容器类,是 Container 的子类。(默认FlowLayout)一个 Panel 对象就是要给应用程序提供空间,用来添加组件,包括其它的 Panel 对象。
Component(Container 是 Component 的子类),Component 是基类
Swing 中使用 JTextField 类实现一个单行文本框,它允许用户输入单行的文本信息
Layout
flowlayout gridlayout borderLayout
myframe.add(button)
5.0 后允许我们可以省去调用getContentPane()而直接在容器内应用 add(),setLayout()和 remove()。然而,我们还是不能忽略了 ContentPane,即使我们可能将不会再使用 ContentPane 来添加部件到容器。
Exception
Using exception让 run-time error 在 compile time 被捕获,更有效
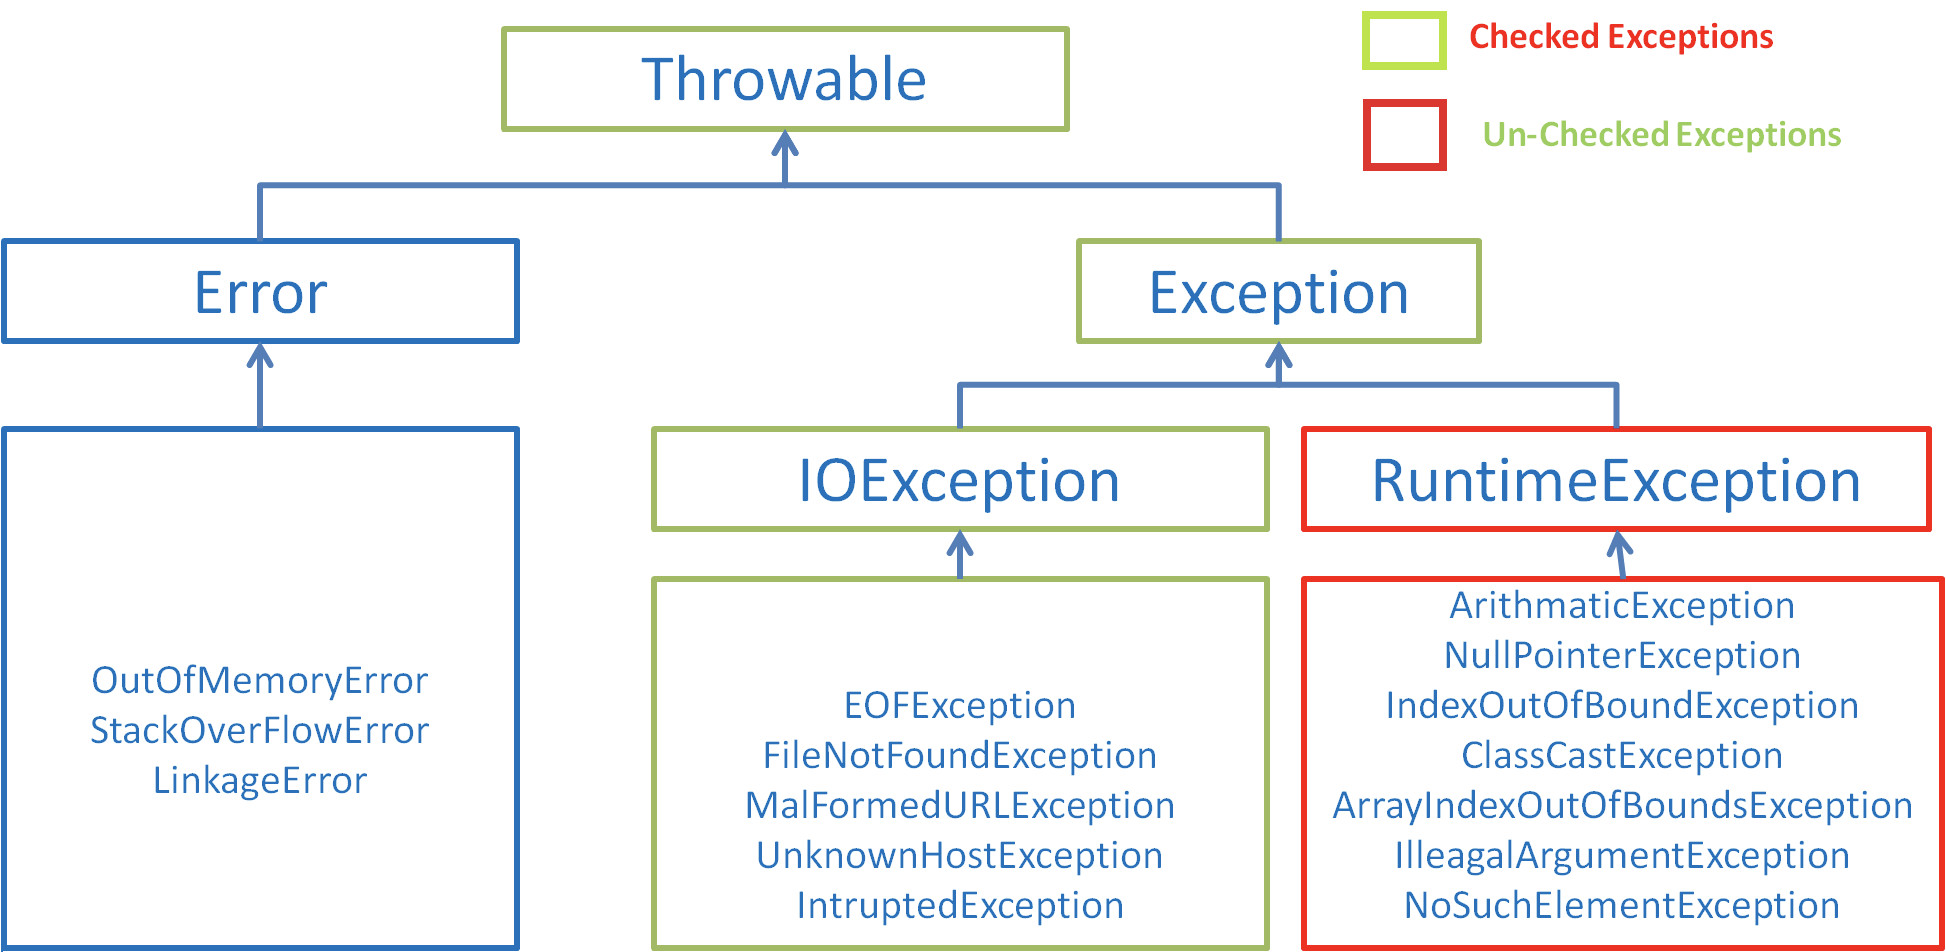
在 Java 中,所有的异常都有一个共同的祖先 java.lang 包中的 Throwable 类。Throwable 类有两个重要的子类 Exception(异常)和 Error(错误)。Exception 能被程序本身处理(try-catch), Error 是无法处理的(只能尽量避免)。
Exception 和 Error 二者都是 Java 异常处理的重要子类,各自都包含大量子类。
当 java 识别到runtime error ,an exception is thrown
-
Exception:程序本身可以处理的异常,可以通过catch来进行捕获。Exception又可以分为 受检查异常(必须处理) 和 不受检查异常(可以不处理)。 -
Error:Error属于程序无法处理的错误,大多数错误与代码编写者执行的操作无关,而表示代码运行时 JVM(Java 虚拟机)出现的问题 ,我们没办法通过catch来进行捕获 。例如,Java 虚拟机运行错误(Virtual MachineError)、虚拟机内存不够错误(OutOfMemoryError)、类定义错误(NoClassDefFoundError)等 。这些异常发生时,Java 虚拟机(JVM)一般会选择线程终止。eg: Exception in thread “main” java.lang.AssertionError:
try catch:自己处理异常
-
try { *可能出现异常的代码 *} catch(Exception e){
e.printStackTrace();
- 如果出现了异常类 A 类型的异常,那么执行该代码 *} …(catch 可以有多个)
-
finally { *最终肯定必须要执行的代码(例如释放资源的代码) *}
throw
throw new Exception(“What are u doing”);
(1)throws 用于方法头,表示的只是异常的申明,而 throw 用于方法内部,抛出的是异常对象。
(2)throws 可以一次性抛出多个异常,而 throw 只能一个 (3)throws 抛出异常时,它的上级(调用者)也要申明抛出异常或者捕获,不然编译报错。而 throw 的话,可以不申明或不捕获(这是非常不负责任的方式)但编译器不会报错。
Assertion
判断语句是否为真,假——》
Comparable sort
若一个类要实现 Comparator 接口:它一定要实现 compareTo(T o1,T o2) 函数,但可以不实现 equals(Object obj) 函数。 为什么可以不实现 equals(Object obj) 函数呢? 因为任何类,默认都是已经实现了 equals(Object obj)的。 Java中的一切类都是继承于 java.lang.Object,在 Object.java 中实现了 equals(Object obj)函数;所以,其它所有的类也相当于都实现了该函数。 (2) int compare(T o1, T o2) 是“比较 o1 和 o2 的大小”。返回“负数”,意味着“o1 比 o2 小”;返回“零”,意味着“o1 等于 o2”;返回“正数”,意味着“o1 大于 o2”。 (3) 这个排序算法是“经过调优的合并排序”算法 我们不难发现:Comparable 相当于“内部比较器”,而 Comparator 相当于“外部比较器”。 Comparator 中文译为比较器,它可以作为一个参数传递到 Collections.sort 和 Arrays.sort 方法来指定某个类对象的排序方式。同时它也能为 sorted set 和 sorted map 指定排序方式。 同 Comparable 类似,指定比较器的时候一般也要保证比较的结果与 equals 结果一致,不一致的话,对应的 sorted set 和 sorted map 的行为同样会变得怪异。推荐实现的比较器类同时实现 java.io.Serializable 接口,以拥有序列化能力,因为它可能会被用作序列化的数据结构(TreeSet、TreeMap)的排序方法。
总结:
一个类实现了 Comparable 接口,意味着该类的对象可以直接进行比较(排序),但比较(排序)的方式只有一种,很单一。
一个类如果想要保持原样(不 implements comparable,又需要进行不同方式的比较(排序),就可以定制比较器(实现 Comparator 接口)。
Comparable 接口在 java.lang 包下,而 Comparator 接口在 java.util 包下,算不上是亲兄弟,但可以称得上是表(堂)兄弟。
Collection
容器
Java 中容器主要分为两大类:Collection 和 Map
容器可以管理对象的生命周期、对象与对象之间的依赖关系,您可以使用一个配置文件(通常是XML),在上面定义好对象的名称、如何产生(Prototype 方式或 Singleton 方式)、哪个对象产生之后必须设定成为某个对象的属性等,在启动容器之后,所有的对象都可以直接取用,不用编写任何一行程序代码来产生对象,或是建立对象与对象之间的依赖关系。

包括 set,list,queue
Collection 中的集合,元素是孤立存在的(理解为单身),向集合中存储元素采用一个个元素的方式存储。
Map 中的集合,元素是成对存在的(理解为夫妻)。每个元素由键与值两部分组成,通过键可以找对所对应的值。
Collection 中的集合称为单列集合,Map 中的集合称为双列集合。
需要注意的是,Map 中的集合不能包含重复的键,值可以重复;每个键只能对应一个值。
Map 中常用的集合为 HashMap 集合、LinkedHashMap 集合。
List
List 必须按照插入的顺序保存元素,Set 不能有重复元素(通过比较 hashcode 和 equals 方法)但是也没有顺序,Queue 按照排队规则来确定对象产生的顺序(通常与它们被插入的顺序相同)。
ArrayList 是实现了基于动态数组的数据结构,LinkedList 是基于链表结构。 对于随机访问的 get 和 set 方法,ArrayList 要优于 LinkedList,因为 LinkedList 要移动指针。 对于新增和删除操作 add 和 remove,LinkedList 比较占优势,因为 ArrayList 要移动数据。
LinkedList 头尾操作的性能非常优良
Treemap
treemap 由红黑树实现,自动对 key 进行排序
1、HashMap 无序,TreeMap 有序。
2、HashMap 覆盖了 equals()方法和 hashcode()方法,这使得 HashMap 中两个相等的映射返回相同的哈希值;
TreeMap 则是实现了 SortedMap 接口,使其有序。
3、HashMap 的工作效率更高,而 TreeMap 则是基于树的增删查改。更推荐使用 HashMap。
4、HashMap 基于数组+链表+红黑树(jdk1.8 之后)实现,TreeMap 是基于红黑树实现。
5、两者都不是线性安全的。
Hashmap
An object that maps keys to values. A map cannot contain duplicate keys; each key can map to at most one value.
HashSet 底层是 HashMap,HashMap 的底层(数组+链表+红黑树)来实现的,它之所以有相当快的查询速度主要是因为它是通过计算散列码来决定存储的位置。HashMap 的底层是数组加链表 HashMap 是用哈希表来存储数据的 。哈希表的底层是数组,数组里面是entry 对象 。默认长度是 16 。 当像 哈希表里面添加一个对象的时候,会先调用 对象的 hashcode 算法,算出哈希码值 。根据哈希算法算出对应的数组的索引值,再根据索引值查找数组 ,数组中是否存在对象,如果不存在对象直接存进去 。如果数组中存在该对象,会调用对象的 equals 方法 ,比较 key 值是否相等 。如果相等 ,value 值 直接覆盖 。如果不相等 ,则形成链表结构
jdk1.7 先添加的往后移,后添加的排前面 。这种情况就叫哈希碰撞 。这种情况应该尽量避免 ,否则一个索引中 链表的数据量大时 ,该索引中再添加一个对象时 equals 比较会影响效率 。因此 hashmap 提出了加载因子 用来避免碰撞 。加载因子的默认值是 0.75 。当元素达到现有表的 75% 的时候 进行自动扩容 ,一旦扩容 就会重新排序,减少哈希碰撞 。就是说大小为 16 的 HashMap,到了第 13 个元素,就会扩容成 32。
JDK1.8 中,HashMap 在存储一个元素时,当对应链表长度大于 8 时,链表就转换为红黑树,这样又大大提高了查找的效率。
HashSet 允许有 null 值。HashSet 是无序的,即不会记录插入的顺序。
HashSet 不是线程安全的, 如果多个线程尝试同时修改 HashSet,则最终结果是不确定的。 您必须在多线程访问时显式同步对 HashSet 的并发访问。
HashMap 中,键值对的存储是通过 1. put(key,vlaue)
get 方法,传入 key,就可以查询到 value。 HashMap 的底层数组长度总是 2 的 n 次方,
Hashtable 是早期 Java 类库提供的一个哈希表实现,本身是同步的,不支持 null 键和值,由于同步导致的性能开销,所以已经很少被推荐使用。
解决 HashMap 的哈希碰撞? 闭散列也叫开放定址法 or 开散列 链地址法(开链法)
Java 中 HashMap 是利用“拉链法”处理 HashCode 的碰撞问题。在调用 HashMap 的 put 方法或 get 方法时,都会首先调用 hashcode 方法,去查找相关的 key,当有冲突时,再调用 equals 方法。hashMap 基于 hasing 原理,我们通过 put 和 get 方法存取对象。当我们将键值对传递给 put 方法时,他调用键对象的 hashCode()方法来计算 hashCode,然后找到 bucket(哈希桶)位置来存储对象。当获取对象时,通过键对象的 equals()方法找到正确的键值对,然后返回值对象。HashMap 使用链表来解决碰撞问题,当碰撞发生了,对象将会存储在链表的头节点。hashMap 在每个链表节点存储键值对对象。当两个不同的键却有相同的 hashCode 时,他们会存储在同一个 bucket 位置的链表中。
如果两个对象根据 equals() 方法相等,则它们的哈希码必须相同。
HashCode 是使用 Key 通过 Hash 函数计算出来的,由于不同的 Key,通过此 Hash 函数可能会算的同样的 HashCode,所以此时用了拉链法解决冲突,把 HashCode 相同的 Value 连成链表. 但是 get 的时候根据 Key 又去桶里找,如果是链表说明是冲突的,此时还需要检测 Key 是否相同
Hashmap 扩容:扩大数组长度,对原数组进行 rehash 操作,把原数组 copy 到新数组中 resize()
Map.Entry 是为了更方便的输出 map 键值对。一般情况下,要输出 Map 中的 key 和 value 是先得到 key 的集合 keySet(),然后再迭代(循环)由每个 key 得到每个 value。values()方法是获取集合中的所有值,不包含键,没有对应关系。而 Entry 可以一次性获得这两个值。
getOrDefault, computeIfAbsent, putIfAbsent 这三个方法都很像,都是对 map 中不存在 key 时的处理。 这三个函数在执行基于 map 的分组时会很常用,比如分组求和或者分组生成 list。 其中,get 的是只读处理,不会影响 map 的结构。语义是如果不存在返回指定的默认值,否则返回 key 对应的 value。 三者语义上的区别: getOrDefault:仅仅是返回值,如果不存在返回指定的默认值,不修改 map 的结构 putIfAbsent:key 不存在时,塞一个值,不应该关心返回值 computeIfAbsent:获取 key 对应的 value,不存在时塞一个并返回
private final Map<Integer, Node> keyToNode = new HashMap<>();
在 Java 中,**final关键字用于声明不可变的变量。当final关键字用于声明类成员变量时,表示这个成员变量的引用不能被修改,即不能再指向新的对象或实例。在示例中, 表示 keyToNode 成员变量在初始化后不能被重新赋值。虽然它所引用的HashMap对象本身可以修改(即向其中添加、删除键值对等操作),但是keyToNode所指向的实例不能再指向另一个HashMap**实例。
在给**Map<Integer, Node> keyToNode添加final关键字后,这个成员变量在被声明后就不能再指向其他的Map对象。一旦被初始化,keyToNode引用的HashMap对象不能被更改为另一个HashMap**对象。
主要的原因在于:
- 线程安全性:在多线程环境下,**
final**可以提供一定程度的线程安全,因为它保证了在初始化之后,引用不会发生变化,避免了引用指向其他对象带来的竞态条件和不确定性。 - 代码安全性:**
final关键字可以确保其他部分的代码不会无意间修改keyToNode**的引用,导致意外的行为。
手写get和put方法:public class MyHashMap{    private int getIndex(int key) {            int hash = Integer.hashCode(key);            hash ^= (hash >>> 16);//高16位不动;低16位与高16位做异或运算 为了增加了结果的随机性            return hash % CAPACITY;        }    public void put(int key, int value) {        int idx = getIndex(key);        Node now = nodes[idx], tmp = now;        if (tmp != null) {            Node prev = null;            while (tmp != null) {                if (tmp.key == key) {                    tmp.value = value;                    return;                }                prev = tmp;                tmp = tmp.next;            }            tmp = prev;        }
        Node node = new Node(key, value);        if (tmp != null) {            tmp.next = node;        } else {            nodes[idx] = node;        }    }    public int get(int key) {        int idx = getIndex(key);        Node now = nodes[idx];
        if (now != null) {            if (now.key == key) {                return now.value;            } else {                while (now != null) {                    if (now.key == key) {                        return now.value;                    }                    now = now.next;                }            }        }
return -1; }Queue
deque(double-ended queue,双端队列)是一种具有队列和栈的性质的数据结构。双端队列中的元素可以从两端弹出)。**虽然没有严格要求 Deque 实现禁止插入 null 元素,但强烈鼓励他们这样做。**强烈建议允许使用 null 元素的任何 Deque 实现的用户不要利用插入 null 的能力。这是因为 null 被各种方法用作特殊返回值来指示双端队列为空。
Queue 中 remove() 和 poll()都是用来从队列头部删除一个元素。 在队列元素为空的情况下,remove() 方法会抛出 NoSuchElementException 异常,poll() 方法只会返回 null 。
使用 java 的同学请注意,如果你使用 Stack 的方式来做这道题,会造成速度较慢; 原因的话是 Stack 继承了 Vector 接口,而 Vector 底层是一个 Object[]数组,那么就要考虑空间扩容和移位的问题了。 可以使用 LinkedList 来做 Stack 的容器,因为 LinkedList 实现了 Deque 接口,所以 Stack 能做的事 LinkedList 都能做,其本身结构是个双向链表,扩容消耗少。 但是我的意思不是像 100% 代码那样直接使用一个 LinkedList 当做队列,那确实是快,但是不符题意。 贴上代码,这样的优化之后,效率提高了 40%,超过 97%。
Vector 类实现了一个动态数组。和 ArrayList 很相似,但是两者是不同的:
- Vector 是同步访问的。
- Vector 包含了许多传统的方法,这些方法不属于集合框架。
使用场景
1.需要线程同步
使用 Collections 工具类中 synchronizedXxx()将线程不同步的 ArrayDeque 以及 LinkedList 转换成线程同步。
2.频繁的插入、删除操作:LinkedList
3.频繁的随机访问操作:ArrayDeque
4.未知的初始数据量:LinkedList
list.add() list.remove()
PriorityQueue
PriorityQueue和Queue的区别在于,它的出队顺序与元素的优先级有关,对PriorityQueue调用remove()或poll()方法,返回的总是优先级最高的元素。e.g. 我们放入的顺序是”apple”、“pear”、“banana”,但是取出的顺序却是”apple”、“banana”、“pear”,这是因为从字符串的排序看,“apple”排在最前面,“pear”排在最后面。
因此,放入 PriorityQueue 的元素,必须实现 Comparable 接口,PriorityQueue 会根据元素的排序顺序决定出队的优先级。
优先队列默认结构为二叉小顶堆(层序遍历) 弹出最小元素 小顶堆:每个结点的值都小于或等于其左右孩子结点的值 大顶堆:每个结点的值都大于或等于其左右孩子结点的值
(升序–》大根堆,降序–》小根堆)
不清楚优先队列的同学建议先看一下这位 dalao 的博客
**升序下的小顶堆(默认情况)**queue.offer(1); queue.offer(9); queue.offer(5); queue.offer(6); queue.offer(8);
return [1,6,5,9,8]
(1)add:插入一个元素,不成功会抛出异常
public boolean add(E e) { return offer(e);}
我们看到 add 方法其实是通过调用 offer 方法实现的。我们直接看 offer 方法
(2)offer:插入一个元素,不能被立即执行的情况下会返回一个特殊的值(true 或者 false)
Stream
Java 8 是一个非常成功的版本,这个版本新增的 Stream,配合同版本出现的 Lambda 闭包 ,给我们操作集合(Collection)提供了极大的便利。Stream 流是 JDK8 新增的成员,允许以声明性方式处理数据集合,可以把 Stream 流看作是遍历数据集合的一个高级迭代器。Stream 是 Java8 中处理集合的关键抽象概念,它可以指定你希望对集合进行的操作,可以执行非常复杂的查找/筛选/过滤、排序、聚合和映射数据等操作。使用 Stream API 对集合数据进行操作,就类似于使用 SQL 执行的数据库查询。也可以使用 Stream API 来并行执行操作。简而言之,Stream API 提供了一种高效且易于使用的处理数据的方式。 ————————————————
流是什么? 从支持数据处理操作的源生成元素序列.数据源可以是集合,数组或 IO 资源。
从操作角度来看,流与集合是不同的. 流不存储数据值; 流的目的是处理数据,它是关于算法与计算的。
如果把集合作为流的数据源,创建流时不会导致数据流动; 如果流的终止操作需要值时,流会从集合中获取值; 流只使用一次。
流中心思想是延迟计算,流直到需要时才计算值。
1、Streams
新增的 Stream API(java.util.stream)将函数式编程引入了 Java 库中。这是目前为止最大的一次对 Java 库的完善,以便开发者能够写出更加有效、更加简洁和紧凑的代码。Steam API 极大的简化了集合操作(后面我们会看到不止是集合)。
Stream 概述
- 非主流式定义: 像写 SQL 一样来处理集合;
- 理解类定义: 流式处理;
- 流式处理学习路线: 创建,操作(中间操作,终止操作);
Stream 创建
- Collection 等集合接口实现的 stream()方法和 parallelStream()方法;
- Arrays 提供的数组流;
- Stream 类提供的静态创建方法 of();
创建 Stream 流的三种方式
Stream 中间操作
- 过滤::filter;
- 切片 & 分页:sklip , limit;
- 去重:distinct(去重的对象需要实现 hashCode 和 equals);
- 映射:map, flatMap;
- 排序:sort;
Stream 终止操作
- 匹配
- allMatch:检查是否匹配所有元素;
- anyMatch:检查是否匹配至少一个元素;
- noneMatch:检查是否没有匹配所有元素
- 查找
- findFirst:查找找到的第一个元素;
- findAny:查找找到的任意一个元素
- 计算流中元素个数:count();
- 计算流中元素的最大/最小值:max() , min();
- 内部迭代:forEach;
- 收集:collect;
File Stream
1 处理的数据单位不同,可分为:字符流,字节流
2.数据流方向不同,可分为:输入流,输出流
3.功能不同,可分为:节点流,处理流。
过滤流就是对节点流进行一系列的包装。例如 BufferedInputStream 和 BufferedOutputStream,使用已经存在的节点流来构造,提供带缓冲的读写,提高了读写的效率,以及 DataInputStream 和 DataOutputStream,使用已经存在的节点流来构造,提供了读写 Java 中的基本数据类型的功能。他们都属于过滤流。bytestream characterstream
out 就是 System 里面的一个静态数据成员,而且这个成员是 java.io.PrintStream 类的引用。如下图,被关键字 static 修饰的成员可以直接通过”类名.成员名”来引用,而无需创建类的实例。所以 System.out 是调用了 System 类的静态数据成员 out。
OutputStreamWriter 是从字符流到字节流的桥接怎么理解?
 1、字符的输出需要通过字符流来操作,但是本质最后还是通过字节流输出到计算机上进行存储的
 2、 因此OutputStreamWriter流的作用就是利用字节流作为底层输出流然后构建字符输出流,字符输出流输出字符到流中,然后通过指定的字符集把流中的字符编码成字节输出到字节流中,其作用就是一个桥梁,使得双方链接起来
OutputStream 需要封装在 PrintWriter 中以使用 println.
在 try and catch 中写 read and write
FileReader fr = new FileReader()
BufferedReader in = new BufferedReader(new InputStreamReader(socket.getInputStream()));
PrintWriter out = new PrintWriter(new BufferedWriter(new OutputStreamWriter(socket.getOutputStream())), true);
Java web 生态
RPC 的全称是 Remote Procedure Call 是一种进程间通信方式。它允许程序调用另一个地址空间(通常是共享网络的另一台机器上)的过程或函数,而不用程序员显式编码这个远程调用的细节。即无论是调用本地接口/服务的还是远程的接口/服务,本质上编写的调用代码基本相同。
RPC 会隐藏底层的通讯细节(不需要直接处理 Socket 通讯或 Http 通讯)
RPC 是一个请求响应模型。客户端发起请求,服务器返回响应(类似于 Http 的工作方式)
RPC 在使用形式上像调用本地函数(或方法)一样去调用远程的函数(或方法)。
Spring
Spring 是一个轻量级的IoC 和 AOP容器框架。是为 Java 应用程序提供基础性服务的一套框架,目的是用于简化企业应用程序的开发,它使得开发者只需要关心业务需求。
IOC,Inversion of Control,控制反转,指将对象的控制权转移给 Spring 框架,由 Spring 来负责控制对象的生命周期(比如创建、销毁)和对象间的依赖关系。
最直观的表达就是,以前创建对象的时机和主动权都是由自己把控的,如果在一个对象中使用另外的对象,就必须主动通过 new 指令去创建依赖对象,使用完后还需要销毁(比如 Connection 等),对象始终会和其他接口或类耦合起来。而 IOC 则是由专门的容器来帮忙创建对象,将所有的类都在 Spring 容器中登记,当需要某个对象时,不再需要自己主动去 new 了,只需告诉 Spring 容器,然后 Spring 就会在系统运行到适当的时机,把你想要的对象主动给你。也就是说,对于某个具体的对象而言,以前是由自己控制它所引用对象的生命周期,而在 IOC 中,所有的对象都被 Spring 控制,控制对象生命周期的不再是引用它的对象,而是 Spring 容器,由 Spring 容器帮我们创建、查找及注入依赖对象,而引用对象只是被动的接受依赖对象,所以这叫控制反转。
(2)什么是 DI: IoC 的一个重点就是在程序运行时,动态的向某个对象提供它所需要的其他对象,这一点是通过 DI(Dependency Injection,依赖注入)来实现的,即应用程序在运行时依赖 IoC 容器来动态注入对象所需要的外部依赖。而 Spring 的 DI 具体就是通过反射实现注入的,反射允许程序在运行的时候动态的生成对象、执行对象的方法、改变对象的属性
AOP
面向切面编程(AOP)常用于在一个访问过程中纵向切开,插入控制访问。但是 AOP 编程不会影响正常的执行流程,仅仅是在正常执行流程关键点进行切入编程。举个例子:公司有个人力资源管理系统已经上线,但是系统运行不稳定,有时运行很慢。为了检测系统哪里出了问题,同时又不能破坏原有系统,开发人员想要监控每个方法的执行时间,再根据这些执行时间判断问题所在。当问题解决后,再把这些监控移除。由于系统目前已经运行,如果手动修改系统中成千上万个方法,工作量非常大并且对原系统侵入太深,而且后续移除又很麻烦。
这时,在系统运行过程中动态添加代码,以相同代码检测每一个方法的执行,这就是采用面向切面编程。Spring 框架对于 AOP 提供了很好的支持。在 AOP 中,有一些常见的概念首先介绍给大家:
①Joinpoint(连接点):类中可以被增强的方法被称为链接点。例如,想修改哪个方法的功能,那么该方法就是一个连接点。
②Pointcut(切入点):对 Joinpoint 进行拦截的定义即为切入点。例如,拦截所有以 insert 开始的方法,这个定义即为切入点。
③Advice(通知):拦截到 Joinpoint 后要做的事就是通知。例如,打印日志监控,通知分为前置通知、后置通知、异常通知、最终通知和环绕通知。
④Aspect(切面):Pointcut 和 Advice 结合就是一个切面。
⑤Target(对象):要增强的类被称为 Target。
工厂设计模式 : Spring 使用工厂模式通过 BeanFactory、ApplicationContext 创建 bean 对象。 代理设计模式 : Spring AOP 功能的实现。 单例设计模式 : Spring 中的 Bean 默认都是单例的。 模板方法模式 : Spring 中 jdbcTemplate、hibernateTemplate 等以 Template 结尾的对数据库操作的类,它们就使用到了模板模式。 包装器设计模式 : 我们的项目需要连接多个数据库,而且不同的客户在每次访问中根据需要会去访问不同的数据库。这种模式让我们可以根据客户的需求能够动态切换不同的数据源。 观察者模式: Spring 事件驱动模型就是观察者模式很经典的一个应用。 适配器模式 :Spring AOP 的增强或通知(Advice)使用到了适配器模式、spring MVC 中也是用到了适配器模式适配 Controller。

- 发起请求到中央调度器 DispatcherServlet。
- 中央调度器接收到请求后,调用 HandlerMapping 映射器查找 Handler。
- HandlerMapping 映射器根据 xml 配置、注解进行查找具体的处理器 Handler,生成处理器对象及连接器一并向中央调度器返回 Handler。
- 中央调度器调用 HandlerAdapter 设配器执行 Handler。
- HandlerAdapter 适配器经过适配调用具体的处理器(Controller 也称:控制器)进行业务逻辑操作。
- Handler 执行完成给适配器返回 ModelAndView。
- HandlerAdapter 将 Handler 执行结果 ModelAndView 返回给中央调度器(ModelAndView 是 springmvc 框架的一个底层对象,包括 Model 和 view)。
- 中央调度器将 ModelAndView 传给 ViewResolver 视图解析器进行视图解析,根据逻辑视图名解析成真正的视图(jsp)。
- ViewResolver 视图解析器向中央调度器返回 View。
- 中央调度器进行视图渲染,视图渲染将模型数据(在 ModelAndView 对象中)填充到 request 域。
- 前端控制器向用户响应结果。
vs. springboot
springboot 可以创建独立的 Spring 应用、嵌入式 Tomact、Jetty、Undertow 容器、提供 starters 简化构建配置、尽可能自动配置 spring 应用、提供生产指标、完全没有代码生成和 XML 配置要求
区别 1、Maven 依赖 SpringBoot 只需要一个依赖(spring-boot-starter-web)就能启动和运行 Web 应用程序,但是 Spring 却最少需要两个依赖。 2、测试库 我们测试库常用到的 SpringTest、JUnit、Hamcres 和 Mockito 库,在 SpringBoot 中只需要添加 spring-boot-starter-test 依赖就可以自动包含上面这些库了,但是在 Spring 中就需要将上面所有的库都要添加到依赖上。 3、MVC 配置 当我们创建 JSPWeb 应用程序时,Spring 需要定义调度程序 servlet,映射和其他支持配置,对此我们可以使用 web.xml 文件或 Inirializer 类来做这件事。但是 SpringBoot 只需要在 application 配置文件中配置几个属性就可以代替 Spring 的那些操作 4、ThyMeleaf 模板引擎配置 在 SpringBoot1X 只需要 spring-boot-starter-thymeleaf 的依赖项来启用 Web 应用程序中的 Thymeleaf 支持。但是由于 Thymeleaf3.0 中的新功能,我们必须将 thymeleaf-layout-dialect 添加为 SpringBoot2XWeb 应用程序中的依赖项。配置好依赖,我们就可以将模板添加到 src/main/resources/templates 文件夹中, SpringBoot 将自动显示它们。 5、引导配置 我们用 SpringBoot 它程序的入口是 SpringAppliaction 注释的类,但是 Spring 就比较麻烦了,它支持传统的 web.xml 引导方式和最新的 Servlet3+方法。
JQuery 和 BootStrap 是前端开发的两个重要框架,其中 JQuery 主要提供 JavaScript 框架,而 BootStrap 提供 CSS 排版框架。在 SpringBoot 开发中,引入 JQuery 和 BootStrap 有两种方法。AJAX——核心 XMLHttpRequest 对象,而 JQuery 也对 Ajax 异步操作进行了封装,这里看一下几种常用的方式。 .post, .getJSON。
Ajax(Asynchronous JavaScript And XML)是一种异步交互模式,实现异步页面刷新。JQuery 自带 Ajax 功能,可以基于 JQuery 实现 Ajax。XMLHttpRequest(XHR) 用于在后台与服务器交换数据。这意味着可以在不重新加载整个网页的情况下,对网页的某部分进行更新。
| open(method,url,async) | 规定请求的类型、URL 以及是否异步处理请求。method:请求的类型;GET 或 POSTurl:文件在服务器上的位置 async:true(异步)或 false(同步) |
|---|---|
| send(string) |
每当 readyState 改变时,就会触发 onreadystatechange 事件。
readyState 属性存有 XMLHttpRequest 的状态信息
xmlhttp.onreadystatechange=function() {
if (xmlhttp.readyState==4 && xmlhttp.status==200) { document.getElementById("myDiv").innerHTML=xmlhttp.responseText; } }
Serialization
序列化 (Serialization)是将对象的状态信息转换为可以存储或传输的形式的过程。在序列化期间,对象将其当前状态写入到临时或持久性存储区。以后,可以通过从存储区中读取或反序列化对象的状态,重新创建该对象。
序列化使其他代码可以查看或修改,那些不序列化便无法访问的对象实例数据。确切地说,代码执行序列化需要特殊的权限:即指定了 SerializationFormatter 标志的 SecurityPermission。在默认策略下,通过 Internet 下载的代码或 Internet 代码不会授予该权限;只有本地计算机上的代码才被授予该权限。
**Serializable 接口:**一个对象序列化的接口,一个类只有实现了 Serializable 接口,它的对象才能被序列化。一般用在实体类中
Serializable 接口其实是给 jvm 看的,通知 jvm,我不对这个类做序列化了,你(jvm)帮我序列化就好了。Serializable 接口就是 Java 提供用来进行高效率的异地共享实例对象的机制,实现这个接口即可。
实现了 Serializable 接口的类可以被 ObjectOutputStream 转换为字节流,同时也可以通过 ObjectInputStream 再将其解析为对象。
底层 IO 操作都是以字节流的方式进行的,所以写操作都涉及将编程语言数据类型转换为字节流,而读操作则又涉及将字节流转化为编程语言类型的特定数据类型。而 Java 作为一门面向对象的编程语言,对象作为其主要数据的类型载体,为了完成对象数据的读写操作,也就需要一种方式来让 JVM 知道在进行 IO 操作时如何将对象数据转换为字节流,以及如何将字节流数据转换为特定的对象,而 Serializable 接口就承担了这样一个角色。
目的
1、以某种存储形式使自定义对象持久化; 2、将对象从一个地方传递到另一个地方。 3、使程序更具维护性。
Thread 并发
Java5 开始,在 Java.util.concurrent 包下提供了大量支持高效并发访问的集合接口和实现类
N threads over M cores: 1. N<=M 真并行处理 2. N>M pseudo parallel 只有 runnable 到 running 时才会占用 cpu 时间片
3 特性:安全性,可见性,有序性。
1 线程安全是程式设计中的术语,指某个函数、函数库在多线程环境中被调用时,能够正确地处理多个线程之间的共享变量,使程序功能正确完成。
2 可见性,JVM 提供了 Volatile 和 Synchronized。通过 volatile、synchronized、Lock 手段达到有序性。
线程是并行的最小单位,一个线程实现一个功能
守护线程
在 Java 中有两类线程:User Thread(用户线程)、Daemon Thread(守护线程)
Atomicity
cannot be interrupted, and once it starts is always completes.
JLS 定义了线程对主存的操作指令:lock,unlock,read,load,use,assign,store,write。这些行为是不可分解的原子操作,在使用上相互依赖,read-load 从主内存复制变量到当前工作内存,use-assign 执行代码改变共享变量值,store-write 用工作内存数据刷新主存相关内容。
- read(读取):作用于主内存变量,把一个变量值从主内存传到线程的工作内存中,以便随后的 load 动作使用;
- load(载入):作用于工作内存的变量,它把 read 操作从主内存中得到的变量值放入工作内存的变量副本中。
- use(使用):作用于工作内存的变量,把工作内存中的一个变量值传递给执行引擎,每当虚拟机遇到一个需要使用变量的值的字节码指令时将会执行这个操作。
- assign(赋值):作用于工作内存的变量,它把一个从执行引擎接收到的值赋值给工作内存的变量,每当虚拟机遇到一个给变量赋值的字节码指令时执行这个操作。
- store(存储):作用于工作内存的变量,把工作内存中的一个变量的值传送到主内存中,以便随后的 write 的操作。
- write(写入):作用于主内存的变量,它把 store 操作从工作内存中一个变量的值传送到主内存的变量中。
采用继承 Thread 类方式:(1)优点:编写简单,直接使用 this 便可访问当前线程,无需使用 Thread.currentThread()方法。(2)缺点:JAVA 中不支持多重继承,所以线程类继承 Thread 类后便不能再继承其他父类。
采用实现 Runnable 接口方式: (1)优点:可实现多个接口,还可以继承其他的类。可多个线程共享同一个目标对象,适合用于多个相同线程处理同一份资源,从而将 CPU 代码和数据分开,形成清晰的模型,较好地体现面向对象的思想。 (2)缺点:编程稍微复杂,访问当前线程,必须使用**Thread.currentThread()**方法。
1.**start()方法来启动线程,真正实现了多线程运行。**这时无需等待 run 方法体代码执行完毕,可以直接继续执行下面的代码;通过调用 Thread 类的 start()方法来启动一个线程, 这时此线程是处于就绪状态, 并没有运行。 然后通过此 Thread 类调用方法 run()来完成其运行操作的, 这里方法 run()称为线程体,它包含了要执行的这个线程的内容, Run 方法运行结束, 此线程终止。然后 CPU 再调度其它线程。在 main 线程中 create a new thread 2.**run()方法当作普通方法的方式调用。**程序还是要顺序执行,要等待 run 方法体执行完毕后,才可继续执行下面的代码; 程序中只有主线程——这一个线程, 其程序执行路径还是只有一条, 这样就没有达到写线程的目的。
每当使用 Java 命令执行一个类时,实际上都会启动一个 JVM,
每一个 JVM 实际上就是在操作系统中启动一个线程
,Java 本身具备了垃圾的收集机制。所以在 Java 运行时至少会启动两个线程,一个是 main 线程,另外一个是垃圾收集线程。
!https://img2018.cnblogs.com/blog/1655301/201909/1655301-20190928151648653-69670221.png
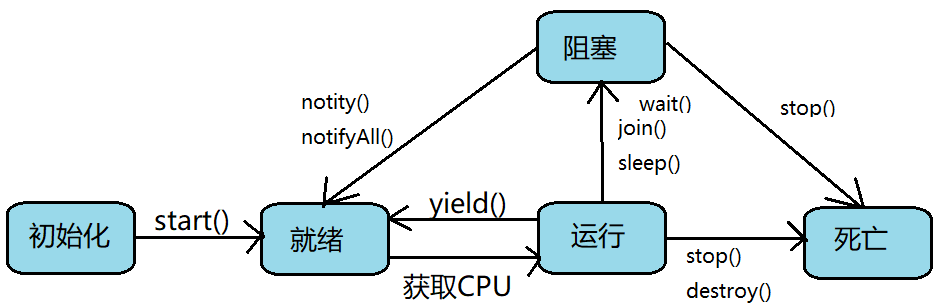
OS: 假如线程正在运行中,程序向硬盘发送访问请求然后等待,这时 CPU 空转,所以线程进入阻塞状态,CPU 执行其他线程。
sleep 相当于让线程睡眠,交出 CPU,让 CPU 去执行其他的任务。但是有一点要非常注意,sleep 方法不会释放锁,
直接调用 interrupt 方法不能中断正在运行中的线程。但是如果配合 isInterrupted()能够中断正在运行的线程,因为调用 interrupt 方法相当于将中断标志位置为 true
!https://images2015.cnblogs.com/blog/682616/201611/682616-20161115184256092-1439402886.jpg
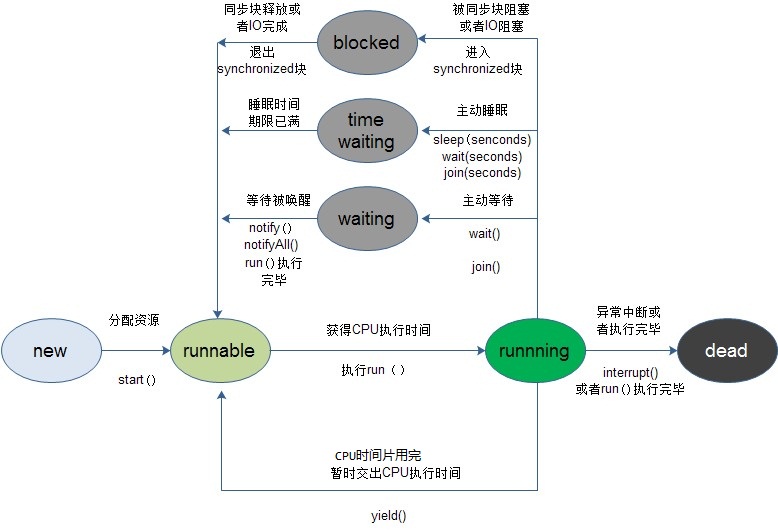
sleep() yield() join()
① sleep()方法给其他线程运行机会时不考虑线程的优先级,因此会给低优先级的线程以运行的机会;yield()方法只会给相同优先级或更高优先级的线程以运行的机会; 因此,Thread.Sleep(0)的作用,就是“触发操作系统立刻重新进行一次 CPU 竞争”。睡眠 1 毫秒。这也是我们在大循环里面经常会写一句 Thread.Sleep(0) ,因为这样就给了其他线程比如 Paint 线程获得 CPU 控制权的权力,这样界面就不会假死在那里。 ② 线程执行 sleep()方法后转入 TIMED_WAITING 状态,而执行 yield()方法后转入就绪(ready)状态; ③ sleep()方法声明抛出 InterruptedException,而 yield()方法没有声明任何异常;
yield()方法并不会让线程进入阻塞状态,而是让线程重回就绪状态,它只需要等待重新获取 CPU 执行时间,所以执行 yield()的线程有可能在进入到可执行状态后马上又被执行。还有一点和 sleep 不同的是 yield 方法只能使同优先级或更高优先级的线程有执行的机会
join()方法阻塞正在运行的线程,在线程 B 中调用了线程 A 的 Join()方法**(B 暂停 wait(),直到线程 A 执行完毕后(B notify(),才会继续执行线程 B。如果调用此方法的线程没有执行完毕,程序不会往下继续执行)**,也就是等到该方法的线程执行完毕后程序再往下继续执行。注意该方法也需要捕捉异常。
wait()、notify()
wait 方法是属于 Object 类中的,wait 过程中线程会释放 Condition 对象锁,只有当其他线程调用 notify 才能唤醒此线程。
只有当 notify/notifyAll() 被执行时候,才会唤醒一个或多个正处于等待状态的线程,然后继续往下执行,直到执行完 synchronized 代码块的代码或是中途遇到 wait() ,再次释放锁。
也就是说,notify/notifyAll() 的执行只是唤醒沉睡的线程,而不会立即释放锁,锁的释放要看代码块的具体执行情况。所以在编程中,尽量在使用了 notify/notifyAll() 后立即退出临界区,以唤醒其他线程让其获得锁
4、wait() 需要被try catch包围,以便发生异常中断也可以使 wait 等待的线程唤醒。
synchronized (obj) { System.out.println("thread1 start"); try { obj.wait(); } catch (InterruptedException e) { e.printStackTrace();Interrupt
对一个线程,调用 interrupt() 时, ① 如果线程处于被阻塞状态(例如处于 sleep, wait, join 等状态),那么线程将立即退出被阻塞状态,并抛出一个 InterruptedException 异常。仅此而已。 ② 如果线程处于正常活动状态,那么会将该线程的中断标志设置为 true,仅此而已。被设置中断标志的线程将继续正常运行,不受影响。
interrupt() 并不能真正的中断线程,需要被调用的线程自己进行配合才行。 也就是说,一个线程如果有被中断的需求,那么就可以这样做。 ① 在正常运行任务时,经常检查本线程的中断标志位,如果被设置了中断标志就自行停止线程。
每一个线程都有一个 boolean 类型的标志,此标志意思是当前的请求是否请求中断,默认为 false。当一个线程 A 调用了线程 B 的 interrupt 方法时,那么线程 B 的是否请求的中断标志变为 true。而线程 B 可以调用方法检测到此标志的变化。
- 阻塞方法:如果线程 B 调用了阻塞方法(wait,sleep,join),如果是否请求中断标志变为了 true,那么它会抛出 InterruptedException 异常。抛出异常的同时它会将线程 B 的是否请求中断标志置为 false
- **非阻塞方法:**可以通过线程 B 的 isInterrupted 方法进行检测是否请求中断标志为 true 还是 false,另外还有一个静态的方法 interrupted 方法也可以检测标志。但是静态方法它检测完以后会自动的将是否请求中断标志位置为 false。例如线程 A 调用了线程 B 的 interrupt 的方法,那么如果此时线程 B 中用静态 interrupted 方法进行检测标志位的变化的话,那么第一次为 true,第二次就为 false。
sleep、wait 和 join 这些方法的内部会不断的检查中断状态的值,从而自己抛出 InterruptEdException。
public void run() {    try {        // 1. isInterrupted()保证,只要中断标记为true就终止线程。        while (!isInterrupted()) {            // 执行任务...        }    } catch (InterruptedException e) {             // Restore the interrupted status             Thread.currentThread().interrupt();         }    //,因为你的程序是实现了Runnable接口,然后在重写Runnable接口的run方法的时候,那么子类抛出的异常要小于等于父类的异常。而在Runnable中run方法是没有抛异常的。所以此时是不能抛出InterruptedException异常。如果此时你只是记录日志的话,那么就是一个不负责任的做法,因为在捕获InterruptedException异常的时候自动的将是否请求中断标志置为了false。至少在捕获了InterruptedException异常之后,如果你什么也不想做,那么就将标志重新置为true,以便栈中更高层的代码能知道中断,并且对中断作出响应。
}
static boolean interrupted() 测试当前线程(正在执行这一命令的线程)是否被中断。这一调用会将当前线程的中断状态重置为 false
boolean isInterrupted() 更好 测试线程是否被终止。不像静态的中断方法,这一调用不改变线程的中断状态
一个 while 循环中使用 Thread.interrupted()作为条件,则在循环中断之后,您不知道是否终止,因为 Thread.interrupted()返回 true 或其他一些条件已更改或一个休息声明跑了所以在这种情况下,使用 Thread.currentThread().isInterrupted()真的是你唯一的选择.
synchronized 和 Lock
Java 中存在两种锁机制:synchronized 和 Lock,Lock 接口及其实现类是 JDK5 增加的内容
synchronized: Java 的关键字,在 jvm 层面上 Lock: 是一个接口
用法
synchronized: 在需要同步的对象中加入此控制,synchronized 可以加在方法上,也可以加在特定代码块中,括号中表示需要锁的对象。
Lock: 一般使用ReentrantLock类做为锁。在加锁和解锁处需要通过 lock()和 unlock()显示指出。所以一定要在 finally 块中写 unlock()以防死锁。
锁的释放
synchronized: 1、以获取锁的线程执行完同步代码,释放锁 2、线程执行发生异常,jvm 会让线程释放锁。在发生异常时候会自动释放占有的锁,因此不会出现死锁
Lock: 在 finally 中必须释放锁,不然容易造成线程死锁。必须手动 unlock 来释放锁,可能引起死锁的发生
锁的获取
synchronized: 假设 A 线程获得锁,B 线程等待。如果 A 线程阻塞,B 线程会一直等待
Lock: 分情况而定,Lock 有多个锁获取的方式,大致就是可以尝试获得锁,线程可以不用一直等待(可以通过 tryLock 判断有没有锁)
锁的状态 synchronized: 无法判断 Lock: 可以判断
性能
synchronized: 少量同步
Lock: 大量同步
- Lock 可以提高多个线程进行读操作的效率。(可以通过 readwritelock 实现读写分离)
- 在资源竞争不是很激烈的情况下,Synchronized 的性能要优于 ReetrantLock,但是在资源竞争很激烈的情况下,Synchronized 的性能会下降几十倍,但是 ReetrantLock 的性能能维持常态;
- ReentrantLock 提供了多样化的同步,比如有时间限制的同步,可以被 Interrupt 的同步(synchronized 的同步是不能 Interrupt 的)等。在资源竞争不激烈的情形下,性能稍微比 synchronized 差点点。但是当同步非常激烈的时候,synchronized 的性能一下子能下降好几十倍。而 ReentrantLock 确还能维持常态。公平锁机制。什么叫公平锁呢?也就是在锁上等待时间最长的线程将获得锁的使用权。通俗的理解就是谁排队时间最长谁先执行获取锁。

② 是否可手动释放 synchronized 不需要用户去手动释放锁,synchronized 代码执行完后系统会自动让线程释放对锁的占用; ReentrantLock 则需要用户去手动释放锁,如果没有手动释放锁,就可能导致死锁现象。一般通过 lock()和 unlock()方法配合 try/finally 语句块来完成,使用释放更加灵活。
③ 是否可中断 synchronized 是不可中断类型的锁,除非加锁的代码中出现异常或正常执行完成; ReentrantLock 则可以中断,可通过 trylock(long timeout,TimeUnit unit)设置超时方法或者将 lockInterruptibly()放到代码块中,调用 interrupt 方法进行中断。
④ 是否公平锁 synchronized 为非公平锁 ReentrantLock 则即可以选公平锁也可以选非公平锁,通过构造方法 new ReentrantLock 时传入 boolean 值进行选择,为空默认 false 非公平锁,true 为公平锁。
可重入锁是指同一个线程如果首次获得了这把锁,那么因为它是这把锁的拥有者,因此 有权利再次获取这把锁
公平锁是等待锁的线程不会饿死。缺点是整体吞吐效率相对非公平锁要低,等待队列中除第一个线程以外的所有线程都会阻塞,CPU 唤醒阻塞线程的开销比非公平锁大。
非公平锁的优点是可以减少唤起线程的开销,整体的吞吐效率高,因为线程有几率不阻塞直接获得锁,CPU 不必唤醒所有线程。缺点是处于等待队列中的线程可能会饿死,或者等很久才会获得锁。
调度
synchronized: 使用 Object 对象本身的 wait 、notify、notifyAll 调度机制
Lock: 可以使用 Condition 进行线程之间的调度
底层实现
synchronized: 底层使用指令码方式来控制锁的,映射成字节码指令就是增加来两个指令:monitorenter 和 monitorexit。当线程执行遇到 monitorenter 指令时会尝试获取内置锁,如果获取锁则锁计数器+1,如果没有获取锁则阻塞;当遇到 monitorexit 指令时锁计数器-1,如果计数器为 0 则释放锁。
Lock: 底层是 CAS 乐观锁,依赖 AbstractQueuedSynchronizer 类,把所有的请求线程构成一个 CLH 队列。而对该队列的操作均通过 Lock-Free(CAS)操作。每次去拿数据的时候都认为别人不会修改,所以不会上锁,但是在更新的时候会判断一下在此期间别人有没有去更新这个数据,可以使用版本号等机制。乐观锁适用于多读的应用类型,这样可以提高吞吐量,像数据库如果提供类似于 write_condition 机制的其实都是提供的乐观锁。
独占锁是一种悲观锁每次去拿数据的时候都认为别人会修改,所以每次在拿数据的时候都会上锁,这样别人想拿这个数据就会 block 直到它拿到锁。,synchronized 就是一种独占锁;它假设最坏的情况,并且只有在确保其它线程不会造成干扰的情况下执行,会导致其它所有需要锁的线程挂起直到持有锁的线程释放锁。
所谓乐观锁就是每次不加锁,假设没有冲突而去完成某项操作;如果发生冲突了那就去重试,直到成功为止。
CAS(Compare And Swap)是一种有名的无锁算法 CPU 层面。CAS 算法是乐观锁的一种实现。CAS 有 3 个操作数,内存值 V,旧的预期值 A,要修改的新值 B。当且仅当预期值 A 和内存值 V 相同时,将内存值 V 修改为 B 并返回 true,否则返回 false。
注:synchronized 和 ReentrantLock 都是悲观锁。ReentrantLock 是悲观锁。ReentrantLock 一上来调用 lock 方法,就直接锁住了,其他获取不到锁的线程都会被加入到 AQS 的同步等待队列中,这还能叫乐观锁?CAS 是乐观的,不代表基于 CAS 实现的 ReentrantLock 是乐观的。
public void test () throw Exception { // 1.初始化选择公平锁、非公平锁 ReentrantLock lock = new ReentrantLock(true); // 2.可用于代码块 lock.lock(); try { try { // 3.支持多种加锁方式,比较灵活; 具有可重入特性 if(lock.tryLock(100, TimeUnit.MILLISECONDS)){ } } finally { // 4.手动释放锁 lock.unlock() } } finally { lock.unlock(); }注:什么时候使用悲观锁效率更高、什么使用使用乐观锁效率更高?
实际生产环境里边,如果并发量不大,完全可以使用悲观锁定的方法,这种方法使用起来非常方便和简单。 但是如果系统的并发非常大的话,悲观锁定会带来非常大的性能问题,所以就要选择乐观锁定的方法。
-
synchronized 修饰一个代码块,被修饰的代码块称为同步语句块,其作用的范围是大括号{}括起来的代码,作用的对象是调用这个代码块的对象; this.notifyAll()会自动执行 解锁对象
-
修饰一个方法,被修饰的方法称为同步方法,其作用的范围是整个方法,作用的对象是调用这个方法的对象;
-
修改一个静态的方法,其作用的范围是整个静态方法,作用的对象是这个类的所有对象;
-
修改一个类,其作用的范围是 synchronized 后面括号括起来的部分,作用主的对象是这个类的所有对象。*
同步锁
一个线程访问一个对象中的synchronized(this)同步代码块时,其他试图访问该对象的线程将被阻塞。当两个并发线程(thread1 和 thread2)访问同一个对象(syncThread)中的 synchronized 代码块时,在同一时刻只能有一个线程得到执行,另一个线程受阻塞,必须等待当前线程执行完这个代码块以后才能执行该代码块。 synchronized 是对类的当前实例进行加锁,防止其他线程同时访问该类的该实例的所有 synchronized 块,注意这里是“ 类的当前实例 ”,类的两个不同实例就没有这种约束了。那么static synchronized 恰好就是要控制类的所有实例的访问了.synchronized 相当于 this.synchronized,而 staticsynchronized 相当于类名.synchronized.
当一个线程访问对象的一个 synchronized(this)同步代码块时,另一个线程仍然可以访问该对象中的非 synchronized(this)同步代码块。
线程池
线程池顾名思义就是事先创建若干个可执行的线程放入一个池中(容器),需要的时候从池中获取线程不用自行创建,使用完毕不需要销毁线程而是放回池中,从而减少创建和销毁线程对象的开销。任何池化技术都是减低资源消耗、解决资源分配,例如我们常用的 数据库连接池。https://tech.meituan.com/2020/04/02/java-pooling-pratice-in-meituan.html
- 内存池(Memory Pooling):预先申请内存,提升申请内存速度,减少内存碎片。
- 连接池(Connection Pooling):预先申请数据库连接,提升申请连接的速度,降低系统的开销。
- 实例池(Object Pooling):循环使用对象,减少资源在初始化和释放时的昂贵损耗。
第 2 个问题: 为什么要用线程池?
1 降低资源消耗 2 提高响应速度 3 提高线程的可管理性
(减少分配和释放现成的开销和控制线程数量),向下进一步解为什么要用多线程(可以并发工作),以及什么是线程(OS 对任务执行的抽象),OS 大概是如何调度的等(抢占式/协作式等)。
而向上就能可以理解如何去管理一组资源(用列表/集合/树),如何去“borrow”和“return”一个资源(锁/CAS),线程的创建释放策略(比如固定数量,定义最小最大数量,根据请求负载和某种算法做自适应等),还有一些设计模式上的考虑(池的实现可以切换而不改变接口;核心代码可以抽象为管理“池”而不仅仅是线程池;能够模拟为异步不阻塞的操作等),以及一些性能上的考量。
如何运行
ThreadPoolExecutor 线程池在内部实际上构建了一个生产者消费者模型,将线程和任务两者解耦,并不直接关联,从而良好的缓冲任务,复用线程。线程池的运行主要分成两部分:任务管理、线程管理。
任务管理部分充当生产者的角色,当任务提交后,线程池会判断该任务后续的流转:(1)直接申请线程执行该任务;(2)缓冲到队列中等待线程执行;(3)拒绝该任务。线程管理部分是消费者,它们被统一维护在线程池内,根据任务请求进行线程的分配,当线程执行完任务后则会继续获取新的任务去执行,最终当线程获取不到任务的时候,线程就会被回收。
参数:
1.corePoolSize:核心池的大小;创建了线程池之后,默认情况下,线程池中没有线程,而是等待任务来了之后,创建线程执行任务,当线程的个数达到核心池大小后,后来的任务就会放在缓存队列中。 2.maximumPoolSize:线程池最大线程数,线程池所能容纳的线程。 3.keepAliveTime:多余的线程没有任务执行之后,线程在线程池中最多待多久的时间才销毁,直到只剩下 corePoolSize 个线程为止。 4.TimeUnit:参数 keepAliveTime 的时间单位,一共 7 种取值
线程的同步与互斥: 互斥:当一个公共资源同一时刻只能被一个进程或线程使用,多个进程或线程不能同时使用公共资源。如:当线程 A 在使用打印机时,其他线程都需要等待。 同步:两个或两个以上的进程或线程在运行过程中协同步调,按预定的先后次序运行。如:A 任务的运行依赖 B 任务产生的数据。 同步保证了线程运行的顺序性,互斥保证了线程运行的安全性。
互斥具有唯一性和排它性,访问是无序的。 由于线程共享进程的资源和地址空间,所以在访问到他们的公共资源的时候,一定会出现线程的同步和互斥现象,多线程访问一个数据的次序一定是杂乱无章的,所以我们引入互斥锁保证在某一端时间内只有一个线程在执行某些代码,条件变量完成同步过程。 实现线程同步互斥的四种方式: 1.临界区:适合一个进程内的多线程访问公共区域或代码段使用 2.互斥量:适合不同进程内多线程访问公共区域或代码段使用,与临界区相似 3.事件:通过线程间触发事件实现同步互斥 4.信号量:与临界区和互斥量不同,可以实现多个线程同时访问公共区域数据,原理与操作系统中的 PV 操作类似,先设置一个访问公共区域的线程最大连接数,每有一个线程访问共享区资源数就减 1,直到资源数小于等于 0。
Deadlock,starvation,race conditon
A deadlock is a state in which each member of a group of actions, is waiting for some other member to release a lock. A livelock on the other hand is almost similar to a deadlock, except that the states of the processes involved in a livelock constantly keep on changing with regard to one another, none progressing. Thus Livelock is a special case of resource starvation, as stated from the general definition, the process is not progressing.
只有具备全部的 4 个条件时,才会出现死锁
互斥:共享资源 X 和 Y 只能被一个线程占用; 占有且等待:线程 T1 已经取得共享资源 X,在等待共享资源 Y 的时候,不释放共享资源 X; 不可抢占:其他线程不能强行抢占线程 T1 占有的资源; 循环等待:线程 T1 等待线程 T2 占有的资源,线程 T2 等待线程 T1 占有的资源,就是循环等待。
如何去避免死锁:思路就是打破产生死锁的四个条件,因为锁本身就是通过互斥来解决线程安全问题的,所以不可打破,所以要打破其余 3 个条件,(1)打破占有且等待,一次性申请所有资源;(2)打破不可抢占,占有部分资源的线程,进一步申请其他资源时,如果申请不到,主动释放占有的资源;(3)打破循环等待,按序申请资源,指资源是有线性顺序的,申请的时候可以先申请资源序号小的,再申请资源序号大的。
Linux 的锁机制: 互斥锁:mutex,用于保证在任何时刻,都只能有一个线程访问该对象。当获取锁操作失败时,线程会进入睡眠,等待锁释放时被唤醒
读写锁:rwlock,分为读锁和写锁。处于读操作时,可以允许多个线程同时获得读操作。但是同一时刻只能有一个线程可以获得写锁。其它获取写锁失败的线程都会进入睡眠状态,直到写锁释放时被唤醒。 注意:写锁会阻塞其它读写锁。当有一个线程获得写锁在写时,读锁也不能被其它线程获取;写者优先于读者(一旦有写者,则后续读者必须等待,唤醒时优先考虑写者)。适用于读取数据的频率远远大于写数据的频率的场合。
Starvation: 饥饿是一个与活锁和死锁密切相关的问题。在动态系统中,对资源的请求不断发生。因此,需要一些策略来决定谁何时获得资源。这个过程是合理的,可能会导致一些进程永远不会得到服务,即使它们没有死锁。 导致队列增长两次然后它 可以消费,从而导致计算不足 }
当“贪婪”线程使共享资源长时间不可用时,就会发生饥饿。例如,假设一个对象提供了一个通常需要很长时间才能返回的同步方法。如果一个线程频繁调用这个方法,其他同样需要频繁同步访问同一对象的线程也会经常被阻塞。
避免 race condition
1.避免使用共享变量 在多线程环境中,race condtion 的出现往往伴随着共享变量,如上面例子中的账户余额和 count 变量,都可以被多个线程读取操作,那么避免问题发生最简单直接的办法就是避免使用共享变量。可以使用不可变对象或者线程本地对象(例如 java 中的 threadlocal)。 2.使用同步或者原子操作 使用同步可以避免 race condition 的问题,但是线程同步往往伴随很多同步的性能开销,还可能导致死锁。两个办法是使用原子操作,例如 java 中的提供的原子类。
monitor
featrures: 1. mutual exclusion(supported by synchronized)
2.cooperation(supported by wait() and notify()) 线程协调工作
在不同的锁状态下,Mark word 会存储不同的信息,这也是为了节约内存常用的设计。当锁状态为重量级锁(锁标识位=10)时,Mark word 中会记录指向
Monitor 对象
的指针,这个 Monitor 对象也称为
管程或监视器锁。
synchronzied 需要关联一个对象,而这个对象就是 monitor object。
monitor 的机制中,
monitor
object 充当着维护 mutex 以及定义 wait/signal API 来管理线程的阻塞和唤醒的角色。 Java 语言中的 java.lang.Object 类,便是满足这个要求的对象,任何一个 Java 对象都可以作为 monitor 机制的 monitor object。 Java 对象存储在内存中,分别分为三个部分,即对象头、实例数据和对齐填充,而在其对象头中,保存了锁标识;同时,java.lang.Object 类定义了
wait(),notify(),notifyAll() 方法,这些方法的具体实现,依赖于一个叫 ObjectMonitor
模式的实现,这是 JVM 内部基于 C++ 实现的一套机制
(1)当多个线程同时访问一段同步代码时,首先会进入 _EntryList 队列中。
(2)当某个线程获取到对象的 Monitor 后进入临界区域,并把 Monitor 中的 _owner 变量设置为当前线程,同时 Monitor 中的计数器 _count 加 1。即获得对象锁。
(3)若持有 Monitor 的线程调用 wait() 方法,将释放当前持有的 Monitor,*owner 变量恢复为 null,*count 自减 1,同时该线程进入 _WaitSet 集合中等待被唤醒。
(4)在WaitSet 集合中的线程会被再次放到EntryList 队列中,重新竞争获取锁。
(5)若当前线程执行完毕也将释放 Monitor 并复位变量的值,以便其他线程进入获取锁。
线程争抢锁的过程要比上面展示得更加复杂。除了_EntryList 这个双向链表用来保存竞争的线程,ObjectMonitor 中还有另外一个单向链表 _cxq,由两个队列来共同管理并发的线程。
isAlive()<join()常用 3ways to terminate a thread:
volatile
volatile 总是与优化有关,被 volatile 修饰的变量可以禁止指令重排序优化。volatile 的本意是“易变的” 因为访问寄存器要比访问内存单元快的多,所以编译器一般都会作减少存取内存的优化,但有可能会读脏数据。当要求使用 volatile 声明变量值的时候,系统总是重新从它所在的内存读取数据,即使它前面的指令刚刚从该处读取过数据。精确地说就是,遇到这个关键字声明的变量,编译器对访问该变量的代码就不再进行优化,从而可以提供对特殊地址的稳定访问
Java 提供了 volatile 关键字来保证可见性。当一个共享变量被 volatile 修饰时,它会保证修改的值会立即被更新到主存,当有其他线程需要读取时,它会去**内存中读取新值。关闭缓存(从 Load 到 Store)**是不安全的,中间如果其他的 CPU 修改了值将会丢失。下面的测试代码可以实际测试 voaltile 的自增没有原子性(原子性:即一个操作或者多个操作 要么全部执行并且执行的过程不会被任何因素打断,要么就都不执行。Java 内存模型只保证了基本读取和赋值是原子性操作,如果要实现更大范围操作的原子性,可以通过 synchronized 和 Lock 来实现。
内存屏障(memory barrier)和 volatile 什么关系?上面的虚拟机指令里面有提到,如果你的字段是 volatile,Java 内存模型将在写操作后插入一个写屏障指令,在读操作前插入一个读屏障指令。这意味着如果你对一个 volatile 字段进行写操作,你必须知道:1、一旦你完成写入,任何访问这个字段的线程将会得到最新的值。2、在你写入前,会保证所有之前发生的事已经发生,并且任何更新过的数据值也是可见的,因为内存屏障会把之前的写入值都刷新到缓存。
DCL(双端检锁)机制不一定线程安全,原因是有指令重排序的存在,加入 volatile 可以禁止指令重排
volatile 在并发情况下是线程不安全的,意味着其他线程拿到的值可能不是最新的。because
volatile 变量在各个线程中的确是一致的,但由于 Java 程序中的一条语句映射到物理机器上可能(或者说是基本上)会被转化成若干条本地机器码,也就是说它并不具有原子性,因此线程中变量的一致性并不能得出在并发运行时是线程安全的这一结论(即变量运算的过程中,内存中的变量可能就已经被其它线程修改了)
eg. a++ b= a+1
- final fields cannot use volatile
- accessed by 1thread cannot use volatile
- complex operations cannot use volatile
而普通的共享变量不能保证可见性,因为普通共享变量被修改之后,什么时候被写入主存是不确定的,当其他线程去读取时,此时内存中可能还是原来的旧值,因此无法保证可见性。 另外,通过 synchronized 和 Lock 也能够保证可见性,synchronized 和 Lock 能保证同一时刻只有一个线程获取锁然后执行同步代码,并且在释放锁之前会将对变量的修改刷新到主存当中。因此可以保证可见性。
保证按线程顺序执行的两种方法:
- Thread 类的 join 方法:使宿主线程阻塞指定时间或者直到寄生线程执行完毕
- CountDownLatch 类:指定计数器,当计数器清零即取消阻塞
指令重排序
我们所编写的代码在执行的时候,并不一定是按照我们所编写的顺序一行行的执行的,它们的执行顺序可能是经过重排序的。
3.1 流水线机制 也许有人会纳闷,好好的代码为什么要对它进行重排序呢?这就涉及到了 CPU 的流水线机制,现代 CPU 几乎都采用流水线机制加快指令的处理速度,那么什么是流水线机制呢?这里用一个经典的洗衣机与干衣机的例子进行说明:
首先假设洗衣机洗衣服需要花费 1 个小时,干衣机烘干衣物需要半小时; 正常情况下,一个人先洗衣在干衣需要 1.5 个小时,但我们注意到,在洗衣机运转的时候干衣机是空闲的,反之亦然,这种利用效率无疑是很低的; 现在我们这么做,一个人洗好衣服后,进行干衣的时候,就让下一个人去洗衣服,这样一轮洗衣+干衣的时间就被压缩到了 1 小时(由耗时最长的操作决定); 为进一步提升效率,可以再购置台洗衣机,并让它们有序的运行(两台洗衣机洗衣机结束的时间相差半小时,并和干衣机正确的衔接),这样一轮洗衣+干衣的时间就被压缩到了半小时。 这就是流水线的思想,当然上述例子只涉及两个操作,当有多个操作的时候利用多级的流水线,也可以达到上面类似的效果。 通过指令重排序,可以根据流水线的需求,合理的修改语句的执行顺序,在保证执行结果正确的前提下(当然这里指的是串行的情况下),尽可能的减少流水线中的空操作,大大的提升了执行效率。
3.2 指令重排序带来的问题 虽然指令重排序看上去很美好,但在并行的环境中就有可能会出现问题。
假设在线程 A 中有一段初始化方法,方法在初始化结束之后,会修改变量 A 的值(用于判断是否初始化结束); 由于在串行语义中,只是在方法中对变量 A 进行了赋值,并没有其它与其相关联的操作,因此赋值操作很可能会被重排序(初始化还未完成时就被置位); 这时候另一个线程需要判断初始化是否结束,就去查询了变量 A 的值,由于指令重排序,此线程可能会在初始化还未结束的时候,就得到一个标识着初始化结束含义的变量的值,那么线程后续的操作必然会受到影响。 而利用关键字 volatile 就可以避免这种情况的发生,被 volatile 修饰的变量可以禁止指令重排序优化。
Socket
servlet 不建立连接,仅仅是处理 http 请求的内容。 所有的输入输入输出电文都由 applicationserver 进行处理。到 servlet 时,已经转换成对象了。属于应用层的东西。
socket(套接字)是网络通信的接口,通过接口的 TCP/Ip/UDP 通信, 需要自己建立连接,自己分析输入电文构造输出电文,属于 transport 层。 Socket 套接字是通信的基石,是支持 TCP/IP 协议的网络通信的基本操作单元。它是网络通信过程中端点的抽象表示,包含进行网络通信必须的五种信息:连接使用的协议,本地主机的 IP 地址,本地进程的协议端口,远地主机的 IP 地址,远地进程的协议端口。Socket 本质是编程接口(API),对 TCP/IP 的封装,TCP/IP 也要提供可供程序员做网络开发所用的接口,这就是 Socket 编程接口;HTTP 是轿车,提供了封装或者显示数据的具体形式;Socket 是发动机,提供了网络通信的能力。
ServerSocke.accept()用于等待 socket 连接, socket 是 server 与客户端通信
java Socket
client socket(需要 IP 和 port number) vs. server socket(只需要 port number 返回 service)
Accept() listen
accept()函数 creates a new Socket object,系统调用 accept() 会有点古怪的地方的!你可以想象发生 这样的事情:有人从很远的地方通过一个你在侦听 (listen()) 的端口连接 (connect()) 到你的机器。它的连接将加入到等待接受 (accept()) 的队列 中。你调用 accept() 告诉它你有空闲的连接。它将返回一个新的套接字文 件描述符!这样你就有两个套接字了,原来的一个还在侦听你的那个端口, 新的在准备发送 (send()) 和接收 ( recv()) 数据。这就是这个过程!
session
Javaweb 开发中的监听器,是用于监听 web 常见对象 HttpServletRequest HttpSession ServletContext
为了接受连接,先用socket()创建一个套接口的描述字,然后用 listen()创建套接口并为申请进入的连接建立一个后备日志,然后便可用accept()接受连接了。listen()仅适用于支持连接的套接口
API = 一堆 classes associated with
HttpSession session = request.getSession();
Servlet
A servlet is a Java Programming language class that is used to extend the capabilities of servers that host applications accessed by means of a request-response programming model. Although servlets can respond to any type of request, they are commonly used to extend the applications hosted by web servers. It is also a web component that is deployed on the server to create a dynamic web page. 动态地扩展 Server 的能力,并采用请求-响应模式提供 Web 服务
Servlet 没有 main 方法,不能独立运行,它必须被部署到 Servlet 容器中,由容器来实例化和调用 Servlet 的方法(如 doGet()和 doPost()),Servlet 容器在 Servlet 的生命周期内包容和管理 Servlet。在 JSP 技术 推出后,管理和运行 Servlet/JSP 的容器也称为 Web 容器。
五个方法,最难的地方在于形参,
然而 Tomcat 会事先把形参对象封装好传给我…除此以外,既不需要我写 TCP 连接数据库,也不需要我解析 HTTP 请求,更不需要我把结果转成 HTTP 响应,request 对象和 response 对象帮我搞定了。
那么如何是 Servlet 线程安全呢?答案是不要使用实例变量或类变量。当然你也能够使用 synchronized 同步方法或使用单线程模型,但这样效率不高。暂时变量是不会影响线程安全的,由于他们是在栈上分配空间,并且每一个线程都有自己私有的栈空间.
JSP 同步也一样。由于 jsp 会被编译成 servlet。在 jsp 中<%! String unsafeVar; %>声明的变量事实上是 servlet 的实例变量,而<% String safevar %>变量声明是局部变量。
tomcat
Tomcat运行在 JVM 之上,是 servlet JSp 的 web容器,它和 HTTP 服务器一样,绑定 IP 地址并监听 TCP 端口,同时还包含以下职责:
- 管理 Servlet 程序的生命周期
- 将 URL 映射到指定的 Servlet 进行处理
- 与 Servlet 程序合作处理 HTTP 请求——根据 HTTP 请求生成 HttpServletRequest 对象并传递给 Servlet 进行处理,将 Servlet 中的 HttpServletResponse 对象生成的内容返回给浏览器.
虽然 Tomcat 也可以认为是 HTTP 服务器,但通常它仍然会和 Nginx 配合在一起使用:
-
动静态资源分离——运用 Nginx 的反向代理功能分发请求:所有动态资源的请求交给 Tomcat,而静态资源的请求(例如图片、视频、CSS、JavaScript 文件等)则直接由 Nginx 返回到浏览器,这样能大大减轻 Tomcat 的压力。
-
负载均衡,当业务压力增大时,可能一个 Tomcat 的实例不足以处理,那么这时可以启动多个 Tomcat 实例进行水平扩展,而 Nginx 的负载均衡功能可以把请求通过算法分发到各个不同的实例进行处理
PrintWriter out=response.getWriter() 1,从 HttpServletResponse 中 get 一个 PrintWriter;,
2,打个通俗的比方就是通过 HttpServletResponse 对象得到一支笔,然后 out 是输出字符流,即 servlet 接受到 request 请求后,servlet 使用 out 来返回结果,不管客户端是什么(浏览器或者 httpclient 或者别的 serlvet 等等),它都和客户端建立一个流输出管道,然后把字符流输出给请求端。
out.print(""); out.print(“任何内容”); out.print("");
3,通过 PrintWrite,以流方式输出 html,返回给客户端,显示在 IE 上。
4,取一个响应客户端的流对象
5,获取 PrintWriter 流,用来在客户端输出
HTTP REQUEST HEADER
HTTP2.0 focus on reduce payload time. Using SPDY multiplex,universal encryption,server push
JSP
JSP 全称 Java Server Pages,是一种动态网页开发技术。它使用 JSP 标签在 static HTML 网页中插入 dynamic Java servlet 代码。标签通常以<% 开头以%>结束。
JSP 是一种 Java servlet,主要用于实现 Java web 应用程序的用户界面部分。网页开发者们通过结合 HTML 代码、XHTML 代码、XML 元素以及嵌入 JSP 操作和命令来编写 JSP。JSP 通过网页表单获取用户输入数据、访问数据库及其他数据源,然后动态地创建网页. JSP 标签有多种功能,比如访问数据库、记录用户选择信息、访问 JavaBeans 组件等,还可以在不同的网页中传递控制信息和共享信息。
Scriptlet
<% %>称作 jsp 表达式,用于将已经声明的变量或者表达式输出到网页上面。
<%! %> JSP 声明中定义的变量、方法和类是全局性的,在 JSP 页面中的任何地方都能够使用。
注意 2:JSP 声明中不能使用 out.print()系列方法做 输出操作。
<%— —%> 服务器端注释,解析时将跳过这些代码,从而在客户端是查看源代码是看不到这些注释的。
客户端注释,是查看源代码是可以看到这些注释的。directive
jsp 常用的编译指令有 3 个:include 指令、page 指令、taglib 指令。
page 指令不能作用于动态的包含文件,例如对使用 jsp:include 包含的文件,page 指令的设置是无效的。一般情况下,page 编译指令位于页面最上方,一个页面可以有多个编译配置指令。
2、语法格式:<%@page attribute1="value1" attribute2="value2"... %>
<% out.println("<script>" + "d=new Date(); document.write(d.toGMTString());" + "</script>"); %>
下表列出与 Page 指令相关的属性:
predefined variable
Action
JavaBeans
Simple java classes for storing and accessing information. 面向对象 A bean encapsulates many objects into one object so that we can access this object from multiple places. Moreover, it provides easy maintenance.JavaBean
主要用来传递数据,即把一组数据组合成一个 JavaBean 便于传输。此外,JavaBean 可以方便地被 IDE 工具分析,生成读写属性的代码,主要用在图形界面的可视化设计中。 很多 java class 都符合 javabean 需求
1、所有属性为 private must be packed 2、提供默认构造方法 no main() 3、提供 getter 和 setter 4、实现 serializable 接口
没有javabeans的话 jsp 页面直接和数据层进行交互,这样会使得代码的可维护性变很差,而且在 jsp 中出现大量的业务逻辑代码是很不好的。
jsp:useBean 标签可以在 JSP 中声明一个 JavaBean,然后使用。声明后,JavaBean 对象就成了脚本变量,可以通过脚本元素或其他自定义标签来访问。jsp:useBean 标签的语法格式如下:
<jsp:useBean id="bean 的名字" scope="bean 的作用域" typeSpec/>其中,根据具体情况,scope 的值可以是 page,request,session 或 application。id 值可任意只要不和同一 JSP 文件中其它 jsp:useBean 中 id 值一样就行了。
3.Session 是用户全局变量,在整个会话期间都有效。只要页面不关闭就一直有效(或者直到用户一直未活动导致会话过期,默认 session 过期时间为 30 分钟,或调用 HttpSession 的 invalidate()方法)。存放在 HttpSession 对象中
4.application 是程序全局变量,对每个用户每个页面都有效。存放在 ServletContext 对象中。它的存活时间是最长的,如果不进行手工删除,它们就一直可以使用
总结:当数据只需要在下一个 forward 有用时,用 request 就够了; 若数据不只是在下一个 forward 有用时,就用 session。 上下文,环境信息之类的,用 application。
MVC
渲染页面方面,大概有三种方式:
- 后端渲染 + 后端路由
- 前后端分离 + 前端渲染
- 前后端分离 + 前端渲染 + 前端路由
前后端分离
- 前后端分离(Frontend-Backend Separation):
- 在前后端分离的方式中,前端(浏览器端)和后端(服务器端)是独立的系统。
- 前端通常是一个单页应用(SPA),由 JavaScript 等技术在浏览器中运行。
- 前端通过接口(API)与后端通信,获取纯数据,然后使用这些数据在浏览器中动态渲染页面。
- 传递给浏览器的是数据,而非完整的 HTML 页面。
- 服务器端渲染(Server-Side Rendering,SSR):
- 在服务器端渲染的过程中,服务器负责将数据转换为完整的 HTML 页面,然后发送给浏览器。
- 浏览器收到的是已经渲染好的 HTML,而不仅仅是数据。这有助于更快地展示内容,因为不需要等待浏览器执行 JavaScript 来渲染页面。
- 这种方式通常被认为对搜索引擎友好,因为搜索引擎能够更容易地理解和索引 HTML 内容。
1.数据量:前后端分离中传递数据,所以传输量会小。
服务器端渲染,会传输更大的数据,而且,会有很多内容是重复的。
2 体验:前后端多了一个渲染数据的过程,服务器端省去了这个过程。这也是一直被提到的首屏渲染的问题。
3 解耦:前后端分离中,传输的是数据(只能由前端发送 ajax 请求,后端接受到 ajax 请求后,通过 response 返回数据,数据可以是规定数据结构,比如文本,json,xml,html 等,由前端 ajax 接受,但是如果 html 文件不在项目中,需要 jsonp 跨域请求))全部交给前端来处理,后端只负责提供数据。
服务器端渲染中,传输的是 Html,后端传给前端的 Model,通常是通过 Hidden 的 Input 来处理,或者是直接用模板技术生成(JSP,Velocity,freemak)等。
数据和展现并未分离,在过去,这被称之为套页面。
4 控制:网页之间有各种跳转交互,在前后端分离中,跳转的页面控制,全部是由前端来决定。跟后端完全没有关系。在服务器端渲染的方式中,大部分是由后端来决定,少部分是由前端来决定
5 SEO:前后端分离的方式,通常的载体是 SPA,所以拿到的是没有数据的空壳子,很多搜索引擎,不支持 SPA 方式的 SEO。
- 客户端渲染不利于 SEO 搜索引擎优化
- 服务端渲染是可以被爬虫抓取到的,客户端异步渲染是很难被爬虫抓取到的