JAVAWEB
目录
JAVAWEB
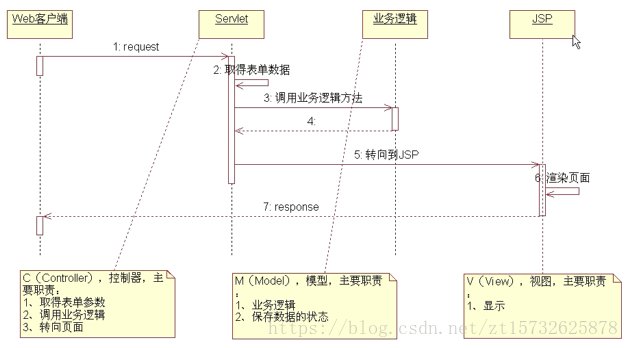
Spring
Spring 框架中用到了哪些设计模式? 关于下面一些设计模式的详细介绍,可以看笔主前段时间的原创文章《面试官:“谈谈 Spring 中都用到了那些设计模式?”。》 。
工厂设计模式 : Spring 使用工厂模式通过 BeanFactory、ApplicationContext 创建 bean 对象。 代理设计模式 : Spring AOP 功能的实现。 单例设计模式 : Spring 中的 Bean 默认都是单例的。 模板方法模式 : Spring 中 jdbcTemplate、hibernateTemplate 等以 Template 结尾的对数据库操作的类,它们就使用到了模板模式。 包装器设计模式 : 我们的项目需要连接多个数据库,而且不同的客户在每次访问中根据需要会去访问不同的数据库。这种模式让我们可以根据客户的需求能够动态切换不同的数据源。 观察者模式: Spring 事件驱动模型就是观察者模式很经典的一个应用。 适配器模式 :Spring AOP 的增强或通知(Advice)使用到了适配器模式、spring MVC 中也是用到了适配器模式适配 Controller。
Ajax
JQuery 和 BootStrap 是前端开发的两个重要框架,其中 JQuery 主要提供 JavaScript 框架,而 BootStrap 提供 CSS 排版框架。在 SpringBoot 开发中,引入 JQuery 和 BootStrap 有两种方法。AJAX——核心 XMLHttpRequest 对象,而 JQuery 也对 Ajax 异步操作进行了封装,这里看一下几种常用的方式。 .post, .getJSON。
Ajax(Asynchronous JavaScript And XML)是一种异步交互模式,实现异步页面刷新。JQuery 自带 Ajax 功能,可以基于 JQuery 实现 Ajax。XMLHttpRequest(XHR) 用于在后台与服务器交换数据。这意味着可以在不重新加载整个网页的情况下,对网页的某部分进行更新。
| open(method,url,async) | 规定请求的类型、URL 以及是否异步处理请求。method:请求的类型;GET 或 POSTurl:文件在服务器上的位置async:true(异步)或 false(同步) |
|---|---|
| send(string) |
每当 readyState 改变时,就会触发 onreadystatechange 事件。
readyState 属性存有 XMLHttpRequest 的状态信息
xmlhttp.onreadystatechange=function() {
if (xmlhttp.readyState==4 && xmlhttp.status==200) { document.getElementById("myDiv").innerHTML=xmlhttp.responseText; } }
Serialization
序列化 (Serialization)是将对象的状态信息转换为可以存储或传输的形式的过程。在序列化期间,对象将其当前状态写入到临时或持久性存储区。以后,可以通过从存储区中读取或反序列化对象的状态,重新创建该对象。
序列化使其他代码可以查看或修改,那些不序列化便无法访问的对象实例数据。确切地说,代码执行序列化需要特殊的权限:即指定了 SerializationFormatter 标志的 SecurityPermission。在默认策略下,通过 Internet 下载的代码或 Internet 代码不会授予该权限;只有本地计算机上的代码才被授予该权限。
目的
1、以某种存储形式使自定义对象持久化; 2、将对象从一个地方传递到另一个地方。 3、使程序更具维护性。
Thread
图片缺失N threads over M cores: 1. N<=M 真并行处理 2. N>M pseudo parallel 只有 runnable 到 running 时才会占用 cpu 时间片
图片缺失线程是并行的最小单位,一个线程实现一个功能
守护线程
在 Java 中有两类线程:User Thread(用户线程)、Daemon Thread(守护线程)
Atomicity
cannot be interrupted, and once it starts is always completes.
JLS 定义了线程对主存的操作指令:lock,unlock,read,load,use,assign,store,write。这些行为是不可分解的原子操作,在使用上相互依赖,read-load 从主内存复制变量到当前工作内存,use-assign 执行代码改变共享变量值,store-write 用工作内存数据刷新主存相关内容。
- read(读取):作用于主内存变量,把一个变量值从主内存传到线程的工作内存中,以便随后的 load 动作使用;
- load(载入):作用于工作内存的变量,它把 read 操作从主内存中得到的变量值放入工作内存的变量副本中。
- use(使用):作用于工作内存的变量,把工作内存中的一个变量值传递给执行引擎,每当虚拟机遇到一个需要使用变量的值的字节码指令时将会执行这个操作。
- assign(赋值):作用于工作内存的变量,它把一个从执行引擎接收到的值赋值给工作内存的变量,每当虚拟机遇到一个给变量赋值的字节码指令时执行这个操作。
- store(存储):作用于工作内存的变量,把工作内存中的一个变量的值传送到主内存中,以便随后的 write 的操作。
- write(写入):作用于主内存的变量,它把 store 操作从工作内存中一个变量的值传送到主内存的变量中。
采用继承 Thread 类方式: (1)优点:编写简单,直接使用 this 便可访问当前线程,无需使用 Thread.currentThread()方法。 (2)缺点:JAVA 中不支持多重继承,所以线程类继承 Thread 类后便不能再继承其他父类。
采用实现 Runnable 接口方式: (1)优点:可实现多个接口,还可以继承其他的类。可多个线程共享同一个目标对象,适合用于多个相同线程处理同一份资源,从而将 CPU 代码和数据分开,形成清晰的模型,较好地体现面向对象的思想。 (2)缺点:编程稍微复杂,访问当前线程,必须使用**Thread.currentThread()**方法。
1.**start()方法来启动线程,真正实现了多线程运行。**这时无需等待 run 方法体代码执行完毕,可以直接继续执行下面的代码;通过调用 Thread 类的 start()方法来启动一个线程, 这时此线程是处于就绪状态, 并没有运行。 然后通过此 Thread 类调用方法 run()来完成其运行操作的, 这里方法 run()称为线程体,它包含了要执行的这个线程的内容, Run 方法运行结束, 此线程终止。然后 CPU 再调度其它线程。在 main 线程中 create a new thread 2.**run()方法当作普通方法的方式调用。**程序还是要顺序执行,要等待 run 方法体执行完毕后,才可继续执行下面的代码; 程序中只有主线程——这一个线程, 其程序执行路径还是只有一条, 这样就没有达到写线程的目的。
每当使用 Java 命令执行一个类时,实际上都会启动一个 JVM,每一个 JVM 实际上就是在操作系统中启动一个线程,Java 本身具备了垃圾的收集机制。所以在 Java 运行时至少会启动两个线程,一个是 main 线程,另外一个是垃圾收集线程。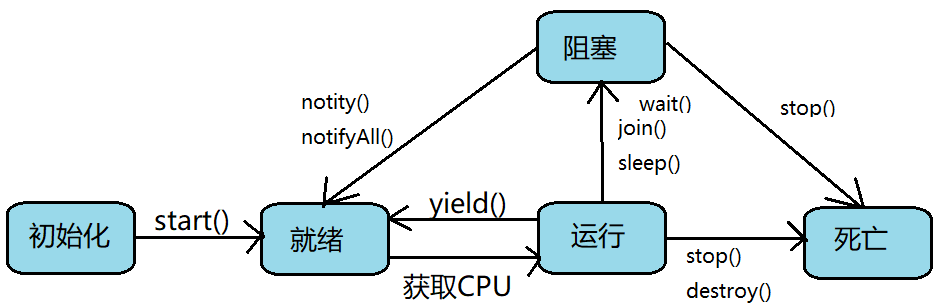
OS: 假如线程正在运行中,程序向硬盘发送访问请求然后等待,这时 CPU 空转,所以线程进入阻塞状态,CPU 执行其他线程。
sleep 相当于让线程睡眠,交出 CPU,让 CPU 去执行其他的任务。但是有一点要非常注意,sleep 方法不会释放锁,
直接调用 interrupt 方法不能中断正在运行中的线程。但是如果配合 isInterrupted()能够中断正在运行的线程,因为调用 interrupt 方法相当于将中断标志位置为 true
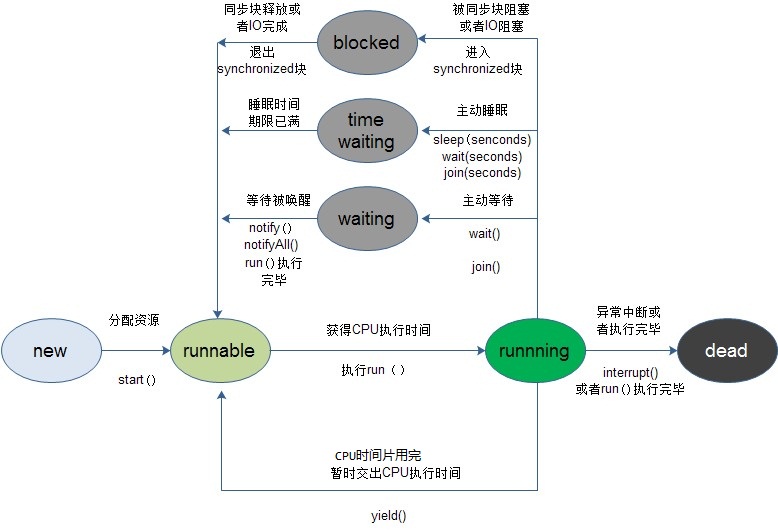
sleep() yield() join()
① sleep()方法给其他线程运行机会时不考虑线程的优先级,因此会给低优先级的线程以运行的机会;yield()方法只会给相同优先级或更高优先级的线程以运行的机会; 因此,Thread.Sleep(0)的作用,就是“触发操作系统立刻重新进行一次 CPU 竞争”。睡眠 1 毫秒。这也是我们在大循环里面经常会写一句 Thread.Sleep(0) ,因为这样就给了其他线程比如 Paint 线程获得 CPU 控制权的权力,这样界面就不会假死在那里。 ② 线程执行 sleep()方法后转入 TIMED_WAITING 状态,而执行 yield()方法后转入就绪(ready)状态; ③ sleep()方法声明抛出 InterruptedException,而 yield()方法没有声明任何异常;
yield()方法并****不会让线程进入阻塞状态*,而是让*线程重回就绪状态**,它只需要等待重新获取 CPU 执行时间,所以执行 yield()的线程有可能在进入到可执行状态后马上又被执行**。还有一点和 sleep 不同的是 *yield 方法只能使同优先级或更高优先级的线程有执行的机会*
join()方法阻塞正在运行的线程,在线程 B 中调用了线程 A 的 Join()方法**(B 暂停 wait(),直到线程 A 执行完毕后(B notify(),才会继续执行线程 B。如果调用此方法的线程没有执行完毕,程序不会往下继续执行)**,也就是等到该方法的线程执行完毕后程序再往下继续执行。注意该方法也需要捕捉异常。
wait()、notify()
wait 方法是属于 *Object* 类中的,wait 过程中线程会****释放对象锁****,只有当其他线程调用 *notify* 才能唤醒此线程。
只有当 notify/notifyAll() 被执行时候,才会唤醒一个或多个正处于等待状态的线程,然后继续往下执行,直到执行完 synchronized 代码块的代码或是中途遇到 wait() ,再次释放锁。
也就是说,notify/notifyAll() 的执行只是唤醒沉睡的线程,而不会立即释放锁,锁的释放要看代码块的具体执行情况。所以在编程中,尽量在使用了 notify/notifyAll() 后立即退出临界区,以唤醒其他线程让其获得锁
4、wait() 需要被try catch包围,以便发生异常中断也可以使 wait 等待的线程唤醒。
synchronized (obj) { System.out.println("thread1 start"); try { obj.wait(); } catch (InterruptedException e) { e.printStackTrace();Interrupt
对一个线程,调用 interrupt() 时, ① 如果线程处于被阻塞状态(例如处于 sleep, wait, join 等状态),那么线程将立即退出被阻塞状态,并抛出一个 InterruptedException 异常。仅此而已。 ② 如果线程处于正常活动状态,那么会将该线程的中断标志设置为 true,仅此而已。被设置中断标志的线程将继续正常运行,不受影响。
interrupt() 并不能真正的中断线程,需要被调用的线程自己进行配合才行。 也就是说,一个线程如果有被中断的需求,那么就可以这样做。 ① 在正常运行任务时,经常检查本线程的中断标志位,如果被设置了中断标志就自行停止线程。
每一个线程都有一个 boolean 类型的标志,此标志意思是当前的请求是否请求中断,默认为 false。当一个线程 A 调用了线程 B 的 interrupt 方法时,那么线程 B 的是否请求的中断标志变为 true。而线程 B 可以调用方法检测到此标志的变化。
- 阻塞方法:如果线程 B 调用了阻塞方法(wait,sleep,join),如果是否请求中断标志变为了 true,那么它会抛出 InterruptedException 异常。抛出异常的同时它会将线程 B 的是否请求中断标志置为 false
- **非阻塞方法:**可以通过线程 B 的 isInterrupted 方法进行检测是否请求中断标志为 true 还是 false,另外还有一个静态的方法 interrupted 方法也可以检测标志。但是静态方法它检测完以后会自动的将是否请求中断标志位置为 false。例如线程 A 调用了线程 B 的 interrupt 的方法,那么如果此时线程 B 中用静态 interrupted 方法进行检测标志位的变化的话,那么第一次为 true,第二次就为 false。
sleep、wait 和 join 这些方法的内部会不断的检查中断状态的值,从而自己抛出 InterruptEdException。
public void run() {    try {        // 1. isInterrupted()保证,只要中断标记为true就终止线程。        while (!isInterrupted()) {            // 执行任务...        }    } catch (InterruptedException e) {             // Restore the interrupted status             Thread.currentThread().interrupt();         }    //,因为你的程序是实现了Runnable接口,然后在重写Runnable接口的run方法的时候,那么子类抛出的异常要小于等于父类的异常。而在Runnable中run方法是没有抛异常的。所以此时是不能抛出InterruptedException异常。如果此时你只是记录日志的话,那么就是一个不负责任的做法,因为在捕获InterruptedException异常的时候自动的将是否请求中断标志置为了false。至少在捕获了InterruptedException异常之后,如果你什么也不想做,那么就将标志重新置为true,以便栈中更高层的代码能知道中断,并且对中断作出响应。
}
static boolean interrupted() 测试当前线程(正在执行这一命令的线程)是否被中断。这一调用会将当前线程的中断状态重置为 false
boolean isInterrupted() 更好 测试线程是否被终止。不像静态的中断方法,这一调用不改变线程的中断状态
一个 while 循环中使用 Thread.interrupted()作为条件,则在循环中断之后,您不知道是否终止,因为 Thread.interrupted()返回 true 或其他一些条件已更改或一个休息声明跑了所以在这种情况下,使用 Thread.currentThread().isInterrupted()真的是你唯一的选择.
synchronized 和 Lock
Java 中存在两种锁机制:synchronized 和 Lock,Lock 接口及其实现类是 JDK5 增加的内容
synchronized: Java 的关键字,在 jvm 层面上 Lock: 是一个接口
用法
synchronized: 在需要同步的对象中加入此控制,synchronized 可以加在方法上,也可以加在特定代码块中,括号中表示需要锁的对象。
Lock: 一般使用 ReentrantLock 类做为锁。在加锁和解锁处需要通过 lock()和 unlock()显示指出。所以一般会在 finally 块中写 unlock()以防死锁。
锁的释放
synchronized: 1、以获取锁的线程执行完同步代码,释放锁 2、线程执行发生异常,jvm 会让线程释放锁。在发生异常时候会自动释放占有的锁,因此不会出现死锁
Lock: 在 finally 中必须释放锁,不然容易造成线程死锁。必须手动 unlock 来释放锁,可能引起死锁的发生
锁的获取
synchronized: 假设 A 线程获得锁,B 线程等待。如果 A 线程阻塞,B 线程会一直等待
Lock: 分情况而定,Lock 有多个锁获取的方式,大致就是可以尝试获得锁,线程可以不用一直等待(可以通过 tryLock 判断有没有锁)
锁的状态
synchronized: 无法判断 Lock: 可以判断
性能
synchronized: 少量同步
Lock: 大量同步
- Lock 可以提高多个线程进行读操作的效率。(可以通过 readwritelock 实现读写分离)
- 在资源竞争不是很激烈的情况下,Synchronized 的性能要优于 ReetrantLock,但是在资源竞争很激烈的情况下,Synchronized 的性能会下降几十倍,但是 ReetrantLock 的性能能维持常态;
- ReentrantLock 提供了多样化的同步,比如有时间限制的同步,可以被 Interrupt 的同步(synchronized 的同步是不能 Interrupt 的)等。在资源竞争不激烈的情形下,性能稍微比 synchronized 差点点。但是当同步非常激烈的时候,synchronized 的性能一下子能下降好几十倍。而 ReentrantLock 确还能维持常态。公平锁机制。什么叫公平锁呢?也就是在锁上等待时间最长的线程将获得锁的使用权。通俗的理解就是谁排队时间最长谁先执行获取锁。
锁的类型
synchronized: 可重入 不可中断 非公平
Lock: 可重入 可判断 可公平(两者皆可)
调度
synchronized: 使用 Object 对象本身的 wait 、notify、notifyAll 调度机制
Lock: 可以使用 Condition 进行线程之间的调度
底层实现
synchronized: 底层使用指令码方式来控制锁的,映射成字节码指令就是增加来两个指令:monitorenter 和 monitorexit。当线程执行遇到monitorenter 指令时会尝试获取内置锁,如果获取锁则锁计数器+1,如果没有获取锁则阻塞;当遇到 monitorexit 指令时锁计数器-1,如果计数器为 0 则释放锁。
Lock: 底层是 CAS 乐观锁,依赖 AbstractQueuedSynchronizer 类,把所有的请求线程构成一个 CLH 队列。而对该队列的操作均通过 Lock-Free(CAS)操作。
独占锁是一种悲观锁,synchronized 就是一种独占锁;它假设最坏的情况,并且只有在确保其它线程不会造成干扰的情况下执行,会导致其它所有需要锁的线程挂起直到持有锁的线程释放锁。
所谓乐观锁就是每次不加锁,假设没有冲突而去完成某项操作;如果发生冲突了那就去重试,直到成功为止。
CAS(Compare And Swap)是一种有名的无锁算法。CAS 算法是乐观锁的一种实现。CAS 有 3 个操作数,内存值 V,旧的预期值 A,要修改的新值 B。当且仅当预期值 A 和内存值 V 相同时,将内存值 V 修改为 B 并返回 true,否则返回 false。
注:synchronized 和 ReentrantLock 都是悲观锁。
注:什么时候使用悲观锁效率更高、什么使用使用乐观锁效率更高,要根据实际情况来判断选择。
-
synchronized 修饰一个代码块,被修饰的代码块称为同步语句块,其作用的范围是大括号{}括起来的代码,作用的对象是调用这个代码块的对象; this.notifyAll()会自动执行 解锁对象
-
修饰一个方法,被修饰的方法称为同步方法,其作用的范围是整个方法,作用的对象是调用这个方法的对象;
-
修改一个静态的方法,其作用的范围是整个静态方法,作用的对象是这个类的所有对象;
-
修改一个类,其作用的范围是 synchronized 后面括号括起来的部分,作用主的对象是这个类的所有对象。**
同步锁
一个线程访问一个对象中的synchronized(this)同步代码块时,其他试图访问该对象的线程将被阻塞。当两个并发线程(thread1 和 thread2)访问同一个对象(syncThread)中的 synchronized 代码块时,在同一时刻只能有一个线程得到执行,另一个线程受阻塞,必须等待当前线程执行完这个代码块以后才能执行该代码块。 synchronized 是对类的当前实例进行加锁,防止其他线程同时访问该类的该实例的所有 synchronized 块,注意这里是“ 类的当前实例 ”,类的两个不同实例就没有这种约束了。那么static synchronized 恰好就是要控制类的所有实例的访问了.synchronized 相当于 this.synchronized,而 staticsynchronized 相当于类名.synchronized.
当一个线程访问对象的一个 synchronized(this)同步代码块时,另一个线程仍然可以访问该对象中的非 synchronized(this)同步代码块。
线程池
线程池顾名思义就是事先创建若干个可执行的线程放入一个池中(容器),需要的时候从池中获取线程不用自行创建,使用完毕不需要销毁线程而是放回池中,从而减少创建和销毁线程对象的开销。任何池化技术都是减低资源消耗,例如我们常用的 数据库连接池。
第 2 个问题: 为什么要用线程池?
1 降低资源消耗 2 提高响应速度 3 提高线程的可管理性
(减少分配和释放现成的开销和控制线程数量),向下进一步解为什么要用多线程(可以并发工作),以及什么是线程(OS 对任务执行的抽象),OS 大概是如何调度的等(抢占式/协作式等)。
而向上就能可以理解如何去管理一组资源(用列表/集合/树),如何去“borrow”和“return”一个资源(锁/CAS),线程的创建释放策略(比如固定数量,定义最小最大数量,根据请求负载和某种算法做自适应等),还有一些设计模式上的考虑(池的实现可以切换而不改变接口;核心代码可以抽象为管理“池”而不仅仅是线程池;能够模拟为异步不阻塞的操作等),以及一些性能上的考量。
Deadlock,starvation,race conditon
A deadlock is a state in which each member of a group of actions, is waiting for some other member to release a lock. A livelock on the other hand is almost similar to a deadlock, except that the states of the processes involved in a livelock constantly keep on changing with regard to one another, none progressing. Thus Livelock is a special case of resource starvation, as stated from the general definition, the process is not progressing.
Starvation: 饥饿是一个与活锁和死锁密切相关的问题。在动态系统中,对资源的请求不断发生。因此,需要一些策略来决定谁何时获得资源。这个过程是合理的,可能会导致一些进程永远不会得到服务,即使它们没有死锁。 导致队列增长两次然后它 可以消费,从而导致计算不足 }
当“贪婪”线程使共享资源长时间不可用时,就会发生饥饿。例如,假设一个对象提供了一个通常需要很长时间才能返回的同步方法。如果一个线程频繁调用这个方法,其他同样需要频繁同步访问同一对象的线程也会经常被阻塞。
monitor
featrures: 1. mutual exclusion(supported by synchronized)
2.cooperation(supported by wait() and notify()) 线程协调工作
在不同的锁状态下,Mark word 会存储不同的信息,这也是为了节约内存常用的设计。当锁状态为重量级锁(锁标识位=10)时,Mark word 中会记录指向Monitor 对象的指针,这个 Monitor 对象也称为管程或监视器锁。synchronzied 需要关联一个对象,而这个对象就是 monitor object。
monitor 的机制中,monitor object 充当着维护 mutex 以及定义 wait/signal API 来管理线程的阻塞和唤醒的角色。
Java 语言中的 java.lang.Object 类,便是满足这个要求的对象,任何一个 Java 对象都可以作为 monitor 机制的 monitor object。
Java 对象存储在内存中,分别分为三个部分,即对象头、实例数据和对齐填充,而在其对象头中,保存了锁标识;同时,java.lang.Object 类定义了 wait(),notify(),notifyAll() 方法,这些方法的具体实现,依赖于一个叫 ObjectMonitor 模式的实现,这是 JVM 内部基于 C++ 实现的一套机制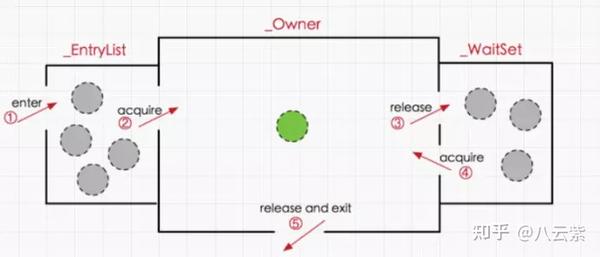
(1)当多个线程同时访问一段同步代码时,首先会进入 _EntryList 队列中。
(2)当某个线程获取到对象的 Monitor 后进入临界区域,并把 Monitor 中的 _owner 变量设置为当前线程,同时 Monitor 中的计数器 _count 加 1。即获得对象锁。
(3)若持有 Monitor 的线程调用 wait() 方法,将释放当前持有的 Monitor,_owner 变量恢复为 null,_count 自减 1,同时该线程进入 _WaitSet 集合中等待被唤醒。
(4)在_WaitSet 集合中的线程会被再次放到_EntryList 队列中,重新竞争获取锁。
(5)若当前线程执行完毕也将释放 Monitor 并复位变量的值,以便其他线程进入获取锁。
线程争抢锁的过程要比上面展示得更加复杂。除了_EntryList 这个双向链表用来保存竞争的线程,ObjectMonitor 中还有另外一个单向链表 _cxq,由两个队列来共同管理并发的线程。
isAlive()<join()常用 3ways to terminate a thread:
volatile
Java 提供了 volatile 关键字来保证可见性。当一个共享变量被 volatile 修饰时,它会保证修改的值会立即被更新到主存,当有其他线程需要读取时,它会去内存中读取新值。关闭缓存,但 (++,—)运算符不是原子性的不能用 volatile(原子性:即一个操作或者多个操作 要么全部执行并且执行的过程不会被任何因素打断,要么就都不执行。Java 内存模型只保证了基本读取和赋值是原子性操作,如果要实现更大范围操作的原子性,可以通过 synchronized 和 Lock 来实现。)
内存屏障(memory barrier)和 volatile 什么关系?上面的虚拟机指令里面有提到,如果你的字段是 volatile,Java 内存模型将在写操作后插入一个写屏障指令,在读操作前插入一个读屏障指令。这意味着如果你对一个 volatile 字段进行写操作,你必须知道:1、一旦你完成写入,任何访问这个字段的线程将会得到最新的值。2、在你写入前,会保证所有之前发生的事已经发生,并且任何更新过的数据值也是可见的,因为内存屏障会把之前的写入值都刷新到缓存。
volatile 在并发情况下是线程不安全的,意味着其他线程拿到的值可能不是最新的。eg. a++ b= a+1
- final fields cannot use volatile
- accessed by 1thread cannot use volatile
- complex operations cannot use volatile
而普通的共享变量不能保证可见性,因为普通共享变量被修改之后,什么时候被写入主存是不确定的,当其他线程去读取时,此时内存中可能还是原来的旧值,因此无法保证可见性。 另外,通过 synchronized 和 Lock 也能够保证可见性,synchronized 和 Lock 能保证同一时刻只有一个线程获取锁然后执行同步代码,并且在释放锁之前会将对变量的修改刷新到主存当中。因此可以保证可见性。
保证按线程顺序执行的两种方法:
- Thread 类的 join 方法:使宿主线程阻塞指定时间或者直到寄生线程执行完毕
- CountDownLatch 类:指定计数器,当计数器清零即取消阻塞
Socket
servlet 不建立连接,仅仅是处理 http 请求的内容。 所有的输入输入输出电文都由 applicationserver 进行处理。到 servlet 时,已经转换成对象了。属于应用层的东西。
socket(套接字)是网络通信的接口,通过接口的 TCP/Ip/UDP 通信, 需要自己建立连接,自己分析输入电文构造输出电文,属于 transport 层。 Socket 套接字是通信的基石,是支持 TCP/IP 协议的网络通信的基本操作单元。它是网络通信过程中端点的抽象表示,包含进行网络通信必须的五种信息:连接使用的协议,本地主机的 IP 地址,本地进程的协议端口,远地主机的 IP 地址,远地进程的协议端口。Socket 本质是编程接口(API),对 TCP/IP 的封装,TCP/IP 也要提供可供程序员做网络开发所用的接口,这就是 Socket 编程接口;HTTP 是轿车,提供了封装或者显示数据的具体形式;Socket 是发动机,提供了网络通信的能力。
ServerSocke.accept()用于等待 socket 连接, socket 是 server 与客户端通信
java Socket
client socket(需要 IP 和 port number) vs. server socket(只需要 port number 返回 service)
Accept() listen
accept()函数 creates a new Socket object,系统调用 accept() 会有点古怪的地方的!你可以想象发生 这样的事情:有人从很远的地方通过一个你在侦听 (listen()) 的端口连接 (connect()) 到你的机器。它的连接将加入到等待接受 (accept()) 的队列 中。你调用 accept() 告诉它你有空闲的连接。它将返回一个新的套接字文 件描述符!这样你就有两个套接字了,原来的一个还在侦听你的那个端口, 新的在准备发送 (send()) 和接收 ( recv()) 数据。这就是这个过程!
session
Javaweb 开发中的监听器,是用于监听 web 常见对象 HttpServletRequest HttpSession ServletContext
为了接受连接,先用socket()创建一个套接口的描述字,然后用 listen()创建套接口并为申请进入的连接建立一个后备日志,然后便可用accept()接受连接了。listen()仅适用于支持连接的套接口
API = 一堆 classes associated with
HttpSession session = request.getSession();
HTML
超文本标记语言(英语:HyperText Markup Language,简称:HTML)是一种用于创建网页的标准标记语言。
您可以使用 HTML 来建立自己的 WEB 站点,HTML 运行在浏览器上,由浏览器来解析。
1、HTML:是用于描述网页文档的一种标记语言。
2、HTTP:通常运行在 TCP 之上。它指定了客户端可能发送给服务器什么样的消息以及得到什么样的响应。请求和响应消息的头以 ASCII 码形式给出;而消息内容则具有一个类似 MIME 的格式。
图片缺失 必须在一个语法
Link
-
Use the
targetattribute to define where to open the linked document 打开新窗口 -
asd<form name= “input” action="" method = “get/post”
3、onclick 返回 true 或未处理 onclick ---->
4、触发 onsubmit 事件 ---->
5、onsubmit 未处理或返回 true ------>
6、提交表单. onsubmit 处理函数返回 false,onclick 函数返回 false,都不会引起表单提交
页面跳转:
方法 1:使用 onclick 事件
<``input` `type``=``"button"` `value``=``"按钮"``onclick``=``"javascrtpt:window.location.href='http://www.baidu.com/'"` `/>或者直接使用 button 标签
<``button` `onclick``=``"window.location.href = 'https://www.baidu.com/'"``>百度</``button``>方法 2:在 button 标签外套一个 a 标签
<``a` `href``=``"http://www.baidu.com/"``>`` ``<``button``>百度</``button``>``</``a``>或使用
<``a` `href``=``"http://www.baidu.com/"``><``input` `type``=``"button"` `value``=``'百度'``></``a``>方法 3:使用 JavaScript 函数
<``script``>``function jump(){`` ``window.location.href="http://www.baidu.com/";``}``</``script``>``<``input` `type``=``"button"` `value``=``"百度"` `onclick``=``javascrtpt``:jump() />``// 或者<``input` `type``=``"button"` `value``=``"百度"` `onclick``=``"jump()"` `/>``// 或者<``button` `onclick``=``"jump()"``>百度</``button``>HTML 中使用 css
- Inline - by using the
sytyleattribute inside HTML elements - Internal - by using a
<style>element in the<head>section - External - by using a
<link>element to link to an external CSS file
1、链接的标签
链接标签是将整个 CSS 文件包含到 HTML 页面中最常见的方式。这是使用外部样式表调用的。标签不需要关闭标签。这个标签应该放在页面的标签中。
在上面的标签简单地改变文件名。css 到您的 css 文件的名称。
2、样式标签
将 CSS 包含到 HTML 中的第二种方法是样式标签,它确实需要一个结束标签。这被称为内部样式。样式标记允许您在它们之间键入 CSS。这些可以放在你的页面的任何地方,但最好的做法是把它们放在你的内容或标题标签上面。
| ... | 标签必须放在 | |||
|---|---|---|---|---|
| 或 | 标签所定义的单元格 | ... | 标签将将建立一个单元格, | 标签必须放在 |
| 属性 | 描述 |
|---|---|
| buffer | 指定 out 对象使用缓冲区的大小 |
| autoFlush | 控制 out 对象的 缓存区 |
| contentType | 指定当前 JSP 页面的 MIME 类型和字符编码 |
| errorPage | 指定当 JSP 页面发生异常时需要转向的错误处理页面 |
| isErrorPage | 指定当前页面是否可以作为另一个 JSP 页面的错误处理页面 |
predefined variable
Action
| 语法 | 描述 |
|---|---|
| jsp:include | 在页面被请求的时候引入一个文件。 |
| jsp:useBean | 寻找或者实例化一个 JavaBean。 |
| jsp:setProperty | 设置 JavaBean 的属性。 |
| jsp:getProperty | 输出某个 JavaBean 的属性。 |
| jsp:forward | 把请求转到一个新的页面。 |
| jsp:plugin | 根据浏览器类型为 Java 插件生成 OBJECT 或 EMBED 标记。 |
| jsp:element | 定义动态 XML 元素 |
| jsp:attribute | 设置动态定义的 XML 元素属性。 |
| jsp:body | 设置动态定义的 XML 元素内容。 |
| jsp:text | 在 JSP 页面和文档中使用写入文本的模板 |
JavaBeans
Simple java classes for storing and accessing information. 面向对象 A bean encapsulates many objects into one object so that we can access this object from multiple places. Moreover, it provides easy maintenance.JavaBean
主要用来传递数据,即把一组数据组合成一个 JavaBean 便于传输。此外,JavaBean 可以方便地被 IDE 工具分析,生成读写属性的代码,主要用在图形界面的可视化设计中。 很多 java class 都符合 javabean 需求
1、所有属性为 private must be packed 2、提供默认构造方法 no main() 3、提供 getter 和 setter 4、实现 serializable 接口
没有javabeans的话 jsp 页面直接和数据层进行交互,这样会使得代码的可维护性变很差,而且在 jsp 中出现大量的业务逻辑代码是很不好的。
jsp:useBean 标签可以在 JSP 中声明一个 JavaBean,然后使用。声明后,JavaBean 对象就成了脚本变量,可以通过脚本元素或其他自定义标签来访问。jsp:useBean 标签的语法格式如下:
<jsp:useBean id="bean 的名字" scope="bean 的作用域" typeSpec/>其中,根据具体情况,scope 的值可以是 page,request,session 或 application。id 值可任意只要不和同一 JSP 文件中其它 jsp:useBean 中 id 值一样就行了。
3.Session 是用户全局变量,在整个会话期间都有效。只要页面不关闭就一直有效(或者直到用户一直未活动导致会话过期,默认 session 过期时间为 30 分钟,或调用 HttpSession 的 invalidate()方法)。存放在 HttpSession 对象中
4.application 是程序全局变量,对每个用户每个页面都有效。存放在 ServletContext 对象中。它的存活时间是最长的,如果不进行手工删除,它们就一直可以使用
总结:当数据只需要在下一个 forward 有用时,用 request 就够了; 若数据不只是在下一个 forward 有用时,就用 session。 上下文,环境信息之类的,用 application。
MVC
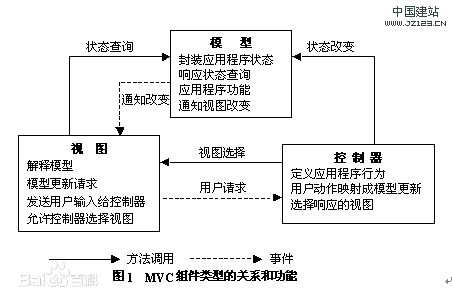
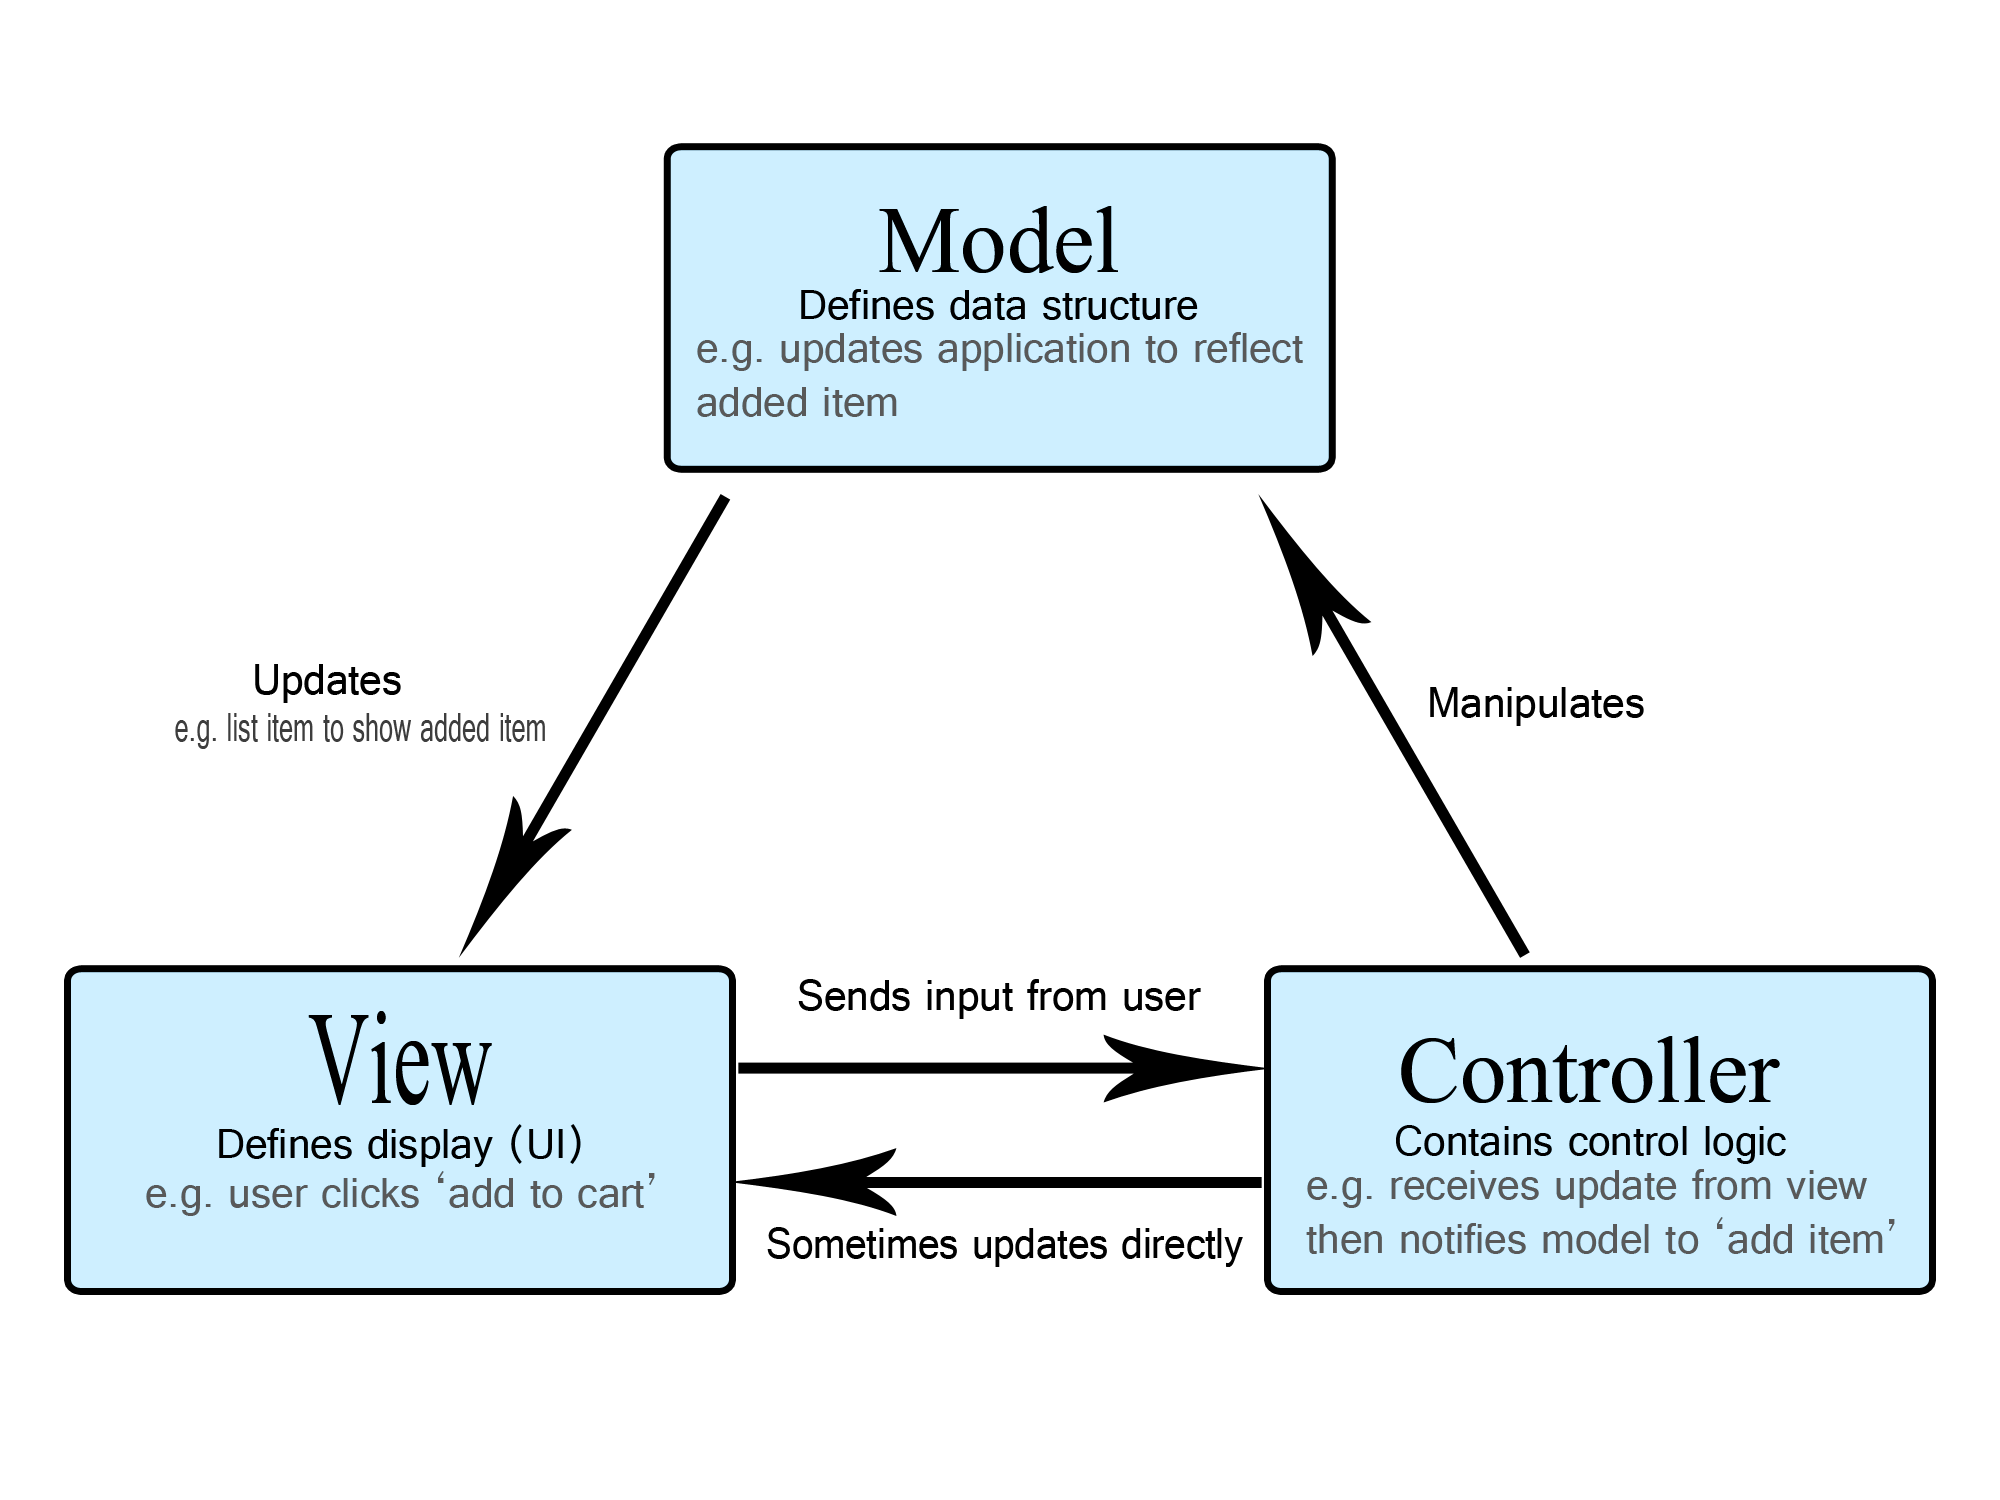
渲染页面方面,大概有三种方式:
- 后端渲染 + 后端路由
- 前后端分离 + 前端渲染
- 前后端分离 + 前端渲染 + 前端路由
前后端分离
只要你的 Html 网页的内容是在服务器端生成的,这就是服务器端渲染的方式。你用Openresty+lua没问题。
只要你的网页是在浏览器端,内容是通过接口从后端拿到的纯数据,这就是前后端分离。在前后端分离的方式,浏览器和服务端传递的是数据,而在服务器端渲染的过程中,传递的是 Html 网页。
1 数据量:前后端分离中传递数据,所以传输量会小。
服务器端渲染,会传输更大的数据,而且,会有很多内容是重复的。
2 体验:前后端多了一个渲染数据的过程,服务器端省去了这个过程。这也是一直被提到的首屏渲染的问题。
3 解耦:前后端分离中,传输的是数据(只能由前端发送 ajax 请求,后端接受到 ajax 请求后,通过 response 返回数据,数据可以是规定数据结构,比如文本,json,xml,html 等,由前端 ajax 接受,但是如果 html 文件不在项目中,需要 jsonp 跨域请求))全部交给前端来处理,后端只负责提供数据。
服务器端渲染中,传输的是 Html,后端传给前端的 Model,通常是通过 Hidden 的 Input 来处理,或者是直接用模板技术生成(JSP,Velocity,freemak)等。
数据和展现并未分离,在过去,这被称之为套页面。
4 控制:网页之间有各种跳转交互,在前后端分离中,跳转的页面控制,全部是由前端来决定。跟后端完全没有关系。在服务器端渲染的方式中,大部分是由后端来决定,少部分是由前端来决定
5 SEO:前后端分离的方式,通常的载体是 SPA,所以拿到的是没有数据的空壳子,很多搜索引擎,不支持 SPA 方式的 SEO。
- 客户端渲染不利于 SEO 搜索引擎优化
- 服务端渲染是可以被爬虫抓取到的,客户端异步渲染是很难被爬虫抓取到的
基本概念
Java only uses PASS-BY-VALUE:把引用变量的复制传给数组对象
jdk(develop kit)包含 jre 包含 jvm;JRE 是 java 运行时的环境,包含 jvm 和核心类库,JDK 是开发工具包
Race Condition(也叫做资源竞争),是多线程编程中比较头疼的问题。特别是 Java 多线程模型当中,经常会因为多个线程同时访问相同的共享数据,而造成数据的不一致性。为了解决这个问题,通常来说需要加上同步标志“synchronized”,来保证数据的串行访问。但是“synchronized”是个性能杀手,过多的使用会导致性能下降,特别是扩展性下降,使得你的系统不能使用多个 CPU 资源。without proper synchronization and their operation interleaves on each other.
注解
三类:自定义注解、JDK 内置注解、还有第三方框架提供的注解。
- 自定义注解就是我们自己写的注解,比如@UserLog
- JDK 内置注解,比如@Override 检验方法重写,@Deprecated 标识方法过期等
- 第三方框架定义的注解比如 SpringMVC 的@Controller 等
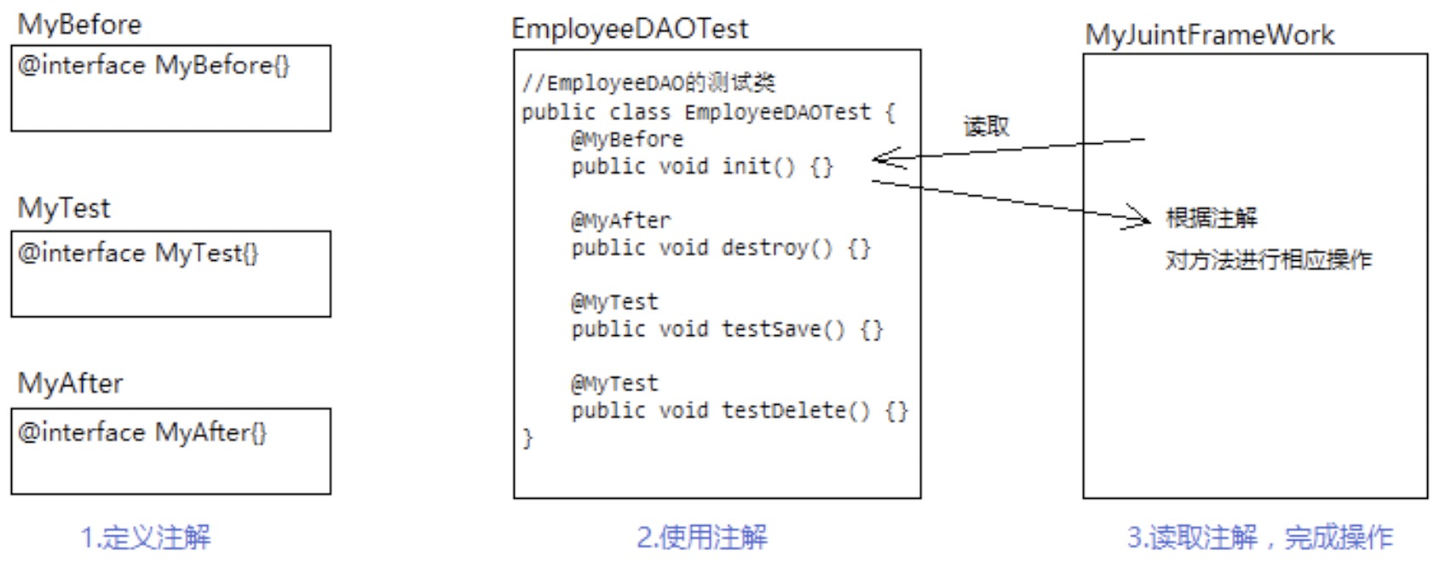
public @interface 注解名称{ 属性列表;}NoSQL
指非关系型数据库,与关系型数据库存在显著差异。其中最重要之处在于 NoSQL 数据库不适用 SQL 语言。其数据存储不需要固定的表格模式,一般都有水平可扩展性。NoSQL 数据库分为以下几类:
①Key/Value 键值存储。这种数据存储通常都无数据结构,被当作字符串或者二进制数据,但是数据加载快,典型应用于高并发和日志系统场景。如 Redis。
②列存储数据库。列存储数据库功能相对局限,但是查找速度快,易分布式扩展。一般用于分布式文件系统。如 Hbase、Cassandra
③文档型数据库。和键值对数据库类似,也没有严格数据格式。不需要预先创建表结构,数据格式更加灵活,一般用户 Web 应用。如 MongoDB。
④图形数据库。图形数据库专注于构建关系图谱,如社交网络、推荐系统等等。这类网络有 Neo4j、DEX。
NoSQL 种类繁多,Spring Boot 支持绝大多数。我们主要介绍常见的 Redis 和 MongoDB。
集群原理
在 Redis 集群中,所有 Redis 节点彼此互联,节点内部使用二进制协议优化传输速度和带宽。当一个节点宕机后,集群中超过半数节点检测失效才认为该节点失效。不同于 Tomcat 集群需要反向代理服务器,Redis 集群中任意节点都可以直接和 Java 客户端连接。Redis 集群上的数据分配采用哈希槽。Redis 集群中内置了 16384 个哈希槽,当有数据要存储时,Redis 会首先使用 CRC16 算法对 key 进行计算,将计算结果对 16384 取余,这样每个 key 都会对应一个取值在 16384 之间的哈希槽。开发者可根据每个 Redis 实例性能来调整每个 Redis 实例上哈希槽的分布范围。
负载均衡
是防止有的人干死了,有的人闲死了,来根据能力(CPU、IO)分配一下工作量
现有的负载均衡算法主要分为静态和动态两类。静态负载均衡算法以固定的概率分配任务,不考虑服务器的状态信息,如轮转算法、加权轮转算法等;动态负载均衡算法以服务器的实时负载状态信息来决定任务的分配,如最小连接法
Jvm
是运行不同 bytecode 的虚拟机。JVM 有针对不同系统的特定实现(Windows,Linux,macOS),目的是使用相同的字节码,它们都会给出相同的结果。可移植性高。字节码是 JVM 理解的代码(.class)。而且,由于字节码并不针对一种特定的机器,因此,Java 程序无须重新编译便可在多种不同操作系统的计算机上运行。
类加载过程 及 双亲委派
类从被加载到内存中开始,到卸载出内存,经历了加载、连接、初始化、使用5 个阶段,其中连接又包含了验证、准备、解析三个步骤。这些步骤总体上是按照图中顺序进行的

4、解析 虚拟机将用于标识引用的符号替换为实际指向的引用的地址。符号或符号引用只不过是个标识(描述符),而实际地址才是真正的目的内存位置。
解析动作主要针对:类或接口、字段(类成员变量)、类方法、接口方法等引用进行。
类或接口的解析:判断所要转化成的直接引用是对数组类型,还是对普通的对象类型的引用,从而进行不同的解析。 字段解析:对字段进行解析时,会先在本类中查找是否包含有简单名称和字段描述符都与目标相匹配的字段,如果有,则查找结束;如果没有,则会按照继承关系从上往下递归搜索该类所实现的各个接口和它们的父接口,还没有,则按照继承关系从上往下递归搜索其父类,直至查找结束,查找流程如下图所示:
最后需要注意:理论上是按照上述顺序进行搜索解析,但在实际应用中,虚拟机的编译器实现可能要比上述规范要求的更严格一些。如果有一个同名字段同时出现在该类的接口和父类中,或同时在自己或父类的接口中出现,编译器可能会拒绝编译。
类方法解析:对类方法的解析与对字段解析的搜索步骤差不多,只是多了判断该方法所处的是类还是接口的步骤,而且对类方法的匹配搜索,是先搜索父类,再搜索接口。 接口方法解析:与类方法解析步骤类似,由于接口不会有父类,因此,只递归向上搜索父接口就行了。
- 初始化
给类的静态变量初始化值,不同于准备阶段,此处是使用用于自定义的值进行赋值。
分为程序计数器、虚拟机栈、本地方法栈 3 个区域 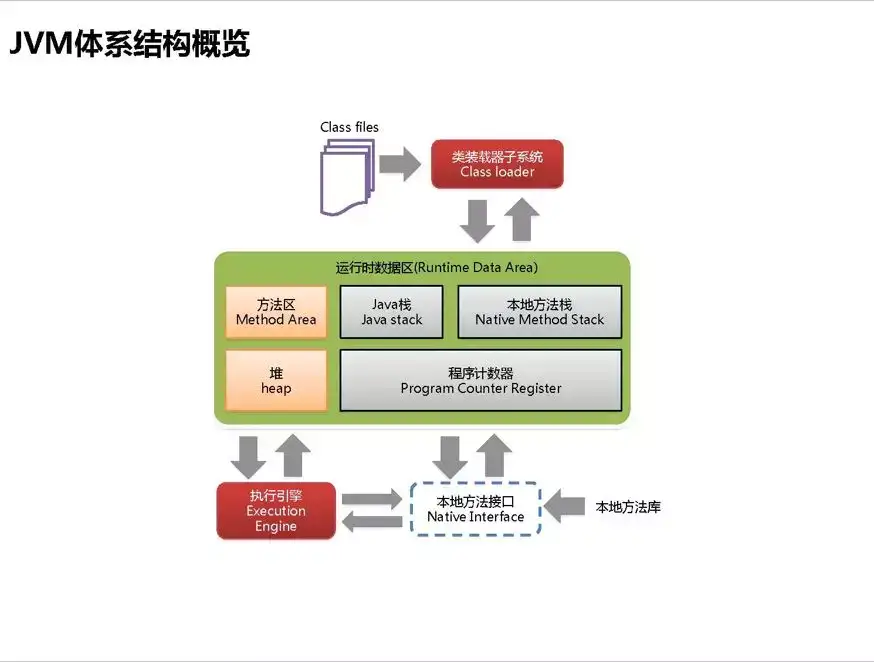
运行步骤: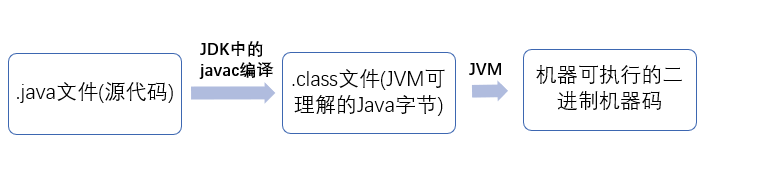
为什么说 java 解释和编译并存?
从.class 到机器码 Java 通过解释器逐行解释执行,后面引入的 JIT 编译器运行效率高。当 JIT 编译器完成第一次编译后,其会将字节码对应的机器码保存下来,下次可以直接使用。
解释性语言在运行程序的时候才翻译(java,Python),比如解释性 basic 语言,专门有一个解释器能够直接执行 basic 程序,每个语句都是执行的时候才翻译。这样解释性语言每执行一次就要翻译一次,效率比较低。编译型语言(C)写的程序执行之前,需要一个专门的编译过程,把程序编译成为机器语言的文件,比如 exe 文件,以后要运行的话就不用重新翻译了,直接使用编译的结果就行了(exe 文件),因为翻译只做了一次,运行时不需要翻译,所以编译型语言的程序执行效率高。
8 个二进制位为一个字节单位。一个英文字母(不分大小写)占一个字节的空间,一个中文汉字占两个字节的空间。英文标点占一个字节,中文标点占两个字节
泛型(generics)
Java 泛型(generics)是 JDK 5 中引入的一个新特性, 泛型提供了编译时类型安全检测机制,该机制允许程序员在编译时检测到非法的类型。泛型的本质是参数化类型,也就是说所操作的数据类型被指定为一个参数。
- 强化类型安全,由于泛型在编译期进行类型检查,从而保证类型安全,减少运行期的类型转换异常。
- 提高代码复用,泛型能减少重复逻辑,编写更简洁的代码。
- 类型依赖关系更加明确,接口定义更加优好,增强了代码和文档的易读性。
有两种限定通配符,⼀种是<? extends T>它通过确保类型必须是 T 的⼦类来设定类型的上界 用于灵活读取,
- 如果传入的类型不是 E 或者 E 的子类,编译不成功
另⼀种是<? super T>它通过确保类型必须是 T 的⽗类来设定类型的下界 用于灵活写入
下界: 用 super 进行声明,表示参数化的类型可能是所指定的类型,或者是此类型的父类型,直至 Object
泛型一般有三种使用方式:泛型类、泛型接口、泛型方法。
ArrayList<E>中的E称为类型变量或者类型形参整个ArrayList<Integer>称为参数化的类型数据类型
A servlet is deployed in a container. life cycle: init() service() destroy()
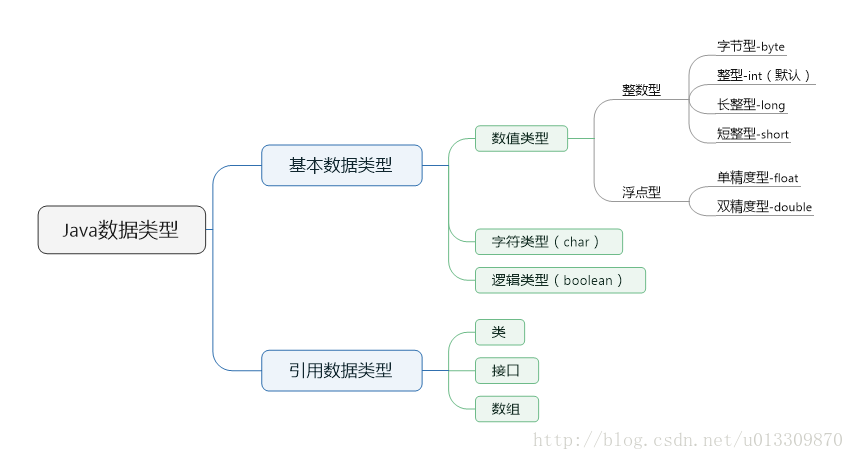
Java 中使用 final 关键字来修饰常量
图片缺失自动类型转换:
低 ------------------------------------> 高计算时低的类型转换为高的,然后运算byte,short,char—> int —> long—> float —> double强制类型转换
强制转换的格式是在需要转型的数据前加上“( )”,然后在括号内加入需要转化的数据类型。有的数据经过转型运算后,精度会丢失,而有的会更加精确,
- x = (int)34.56 + (int)11.2; // 丢失精度
- y = (double)x + (double)10 + 1; // 提高精度图片缺失
AOP
面向切面编程(AOP)常用于在一个访问过程中纵向切开,插入控制访问。但是 AOP 编程不会影响正常的执行流程,仅仅是在正常执行流程关键点进行切入编程。举个例子:公司有个人力资源管理系统已经上线,但是系统运行不稳定,有时运行很慢。为了检测系统哪里出了问题,同时又不能破坏原有系统,开发人员想要监控每个方法的执行时间,再根据这些执行时间判断问题所在。当问题解决后,再把这些监控移除。由于系统目前已经运行,如果手动修改系统中成千上万个方法,工作量非常大并且对原系统侵入太深,而且后续移除又很麻烦。
这时,在系统运行过程中动态添加代码,以相同代码检测每一个方法的执行,这就是采用面向切面编程。Spring 框架对于 AOP 提供了很好的支持。在 AOP 中,有一些常见的概念首先介绍给大家:
①Joinpoint(连接点):类中可以被增强的方法被称为链接点。例如,想修改哪个方法的功能,那么该方法就是一个连接点。
②Pointcut(切入点):对 Joinpoint 进行拦截的定义即为切入点。例如,拦截所有以 insert 开始的方法,这个定义即为切入点。
③Advice(通知):拦截到 Joinpoint 后要做的事就是通知。例如,打印日志监控,通知分为前置通知、后置通知、异常通知、最终通知和环绕通知。
④Aspect(切面):Pointcut 和 Advice 结合就是一个切面。
⑤Target(对象):要增强的类被称为 Target。
OO 面向对象
对象与类
class only exists at compile time; an object only exists at runtime
对象有 attributes(instance variable) and operations(methods)
local variable versus. instance variable
- 局部变量未被初始化 parameter is virtually the same as local variable
- 实例变量在类中 valid 被声明,且被初始化。多线程中,实例变量是多个线程共享资源,要注意同步访问时可能出现的问题
- 类变量用 static 声明,一个对象修改了变量,则所以对象中这个变量的值都会发生改变
实例化
Demo demo = new Demo();
1)右边的“new Demo”,是以 Demo 类为模板,在堆空间里创建一个 Demo 类对象(也简称为 Demo 对象)。
2)末尾的()意味着,在对象创建后,立即调用 Demo 类的构造函数,对刚生成的对象进行初始化。构造函数是肯定有的。如果你没写,Java 会给你补上一个默认的构造函数。
3)左边的“Demo demo”创建了一个 Demo 类引用变量。所谓 Demo 类引用,就是以后可以用来指向 Demo 对象的对象引用。
4)“=”操作符使对象引用指向刚创建的那个 Demo 对象。
3.实例化对象的语法:类名 引用变量名 = new 构造器名() ;
4.访问成员属性或成员方法一般语法是:引用成员变量名.成员名图片缺失
特性:继承、多态、封装
多态
(Polymorphism)按字面的意思就是“多种状态”。在 Java 中多态性是允许你将父对象设置成为和一个或更多的他的子对象相等的技术,赋值之后,父对象就可以根据当前赋值给它的子对象的特性以不同的方式运作。 父类引用指向子类对象
多态,指允许不同类的对象对同一消息做出响应。即同一消息可以根据发送对象的不同而采用多种不同的行为方式。(发送消息就是函数调用)简单的说,就是一句话:允许将子类类型的指针赋值给父类类型的指针(申明:Java 中并没有指针这一说法,但是有引用的地方就会有指针)。 **解说:**在一般的继承关系中,总是父类给予子类更多的财富,让子类拥有更多的功能,而多态讲的是子类对父类的孝敬。只要将子类类型的指针赋值给父类类型的指针,那么我们就可以把父类当做子类来看待,也就是说,我们可以通过父类来使用子类的方法。这就是所说的父子情深。
(2)作用
通过继承和多态,我们可以实例化一个父类对象,把各个子类当做父类的一个状态,当我们需要某个子类的时候,我们就借用指针,来得到相应子类的方法。经过这样处理,我们可以利用父类多态,方便的使用其所有子类的方法,从而使我们面对一个统一的对象(父类)来处理多种状态下的情况。
(3)体现
必要条件 要有继承; 要有重写; 父类引用指向子类对象。
继承与类
类和类之间的关系有三种:is-a、has-a 和 use-a 关系。
is-a 关系也叫继承 inheritance 或泛化,比如学生和人的关系、手机和电子产品的关系都属于继承关系。
has-a 关系通常称之为聚类(关联)aggregation,比如部门和员工的关系,汽车和引擎的关系都属于关联关系;关联关系如果是整体和部分的关联,那么我们称之为聚合关系;如果整体进一步负责了部分的生命周期(整体和部分是不可分割的,同时同在也同时消亡),那么这种就是最强的关联关系,我们称之为合成关系。 use-a 关系通常称之为依赖,比如司机有一个驾驶的行为(方法),其中(的参数)使用到了汽车,那么司机和汽车的关系就是依赖关系。
IS-A__Inheritance: via extends — superclass subclasses; Implements A,B 多重继承 ;
final 使得类不能被继承,方法不能被重写
图片缺失subclass 只有一个 parent
Private 方法不能继承且不能被子类 seen
封装 Encapsulation
封装是指把一个对象的状态信息(也就是属性)隐藏在对象内部,不允许外部对象直接访问对象的内部信息。但是可以提供一些可以被外界访问的方法来操作属性。就好像我们看不到挂在墙上的空调的内部的零件信息(也就是属性),但是可以通过遥控器(方法)来控制空调。如果属性不想被外界访问,我们大可不必提供方法给外界访问。但是如果一个类没有提供给外界访问的方法,那么这个类也没有什么意义了。就好像如果没有空调遥控器,那么我们就无法操控空凋制冷,空调本身就没有意义了(当然现在还有很多其他方法 ,这里只是为了举例子)。
Abstract class
抽象类,比如继承抽象类实现 car.run
- The compiler will not let you instantiate an abstract class ///abstractin terms of classesthat class must be extended, in order to be instantiated•abstractfor methodsthe method must be overridden in the child class
- 子类必须 implement superclass 的所有抽象方法,但父类可以没有抽象方法,有抽象方法的一定是抽象类。
- 抽象方法也不能用 static 修饰,试想一下,如果用 static 修饰了,那么我们可以直接通过类名调 用,抽象类不能被实例化.
- 抽象类中的抽象方法只是声明,不包含方法体,就是不给出方法的具体实现也就是方法的具体功能。
2、抽象方法不能用 private 修饰,因为抽象方法必须被子类实现(覆写),而 private 权限对于子类来 说是不能访问的,所以就会产生矛盾
3、 ADvantage:1、由于抽象类不能被实例化,最大的好处就是通过方法的覆盖来实现多态的属性。也就是运行期绑定 2、抽象类将事物的共性的东西提取出来,由子类继承去实现,代码易扩展、易维护。
子类继承父类执行顺序
SonTest.java
  public class SonTest extends FatherTest {
  // 然后再加入一个main函数  public static void main(String[] args) {  System.out.println("--子类主程序--");  FatherTest father = new FatherTest("父亲的名字");  father.speak();  SonTest son = new SonTest("儿子的名字");  son.speak();  }  }
1.先父再子,执行子类的重写方法
 2.静态代码块—主程序—非静态代码块—构造函数—一般方法
(Override)与(Overload)
重写是子类对父类的允许访问的方法的实现过程进行重新编写, 返回值和形参都不能改变。即外壳不变,核心重写!
重写的好处在于子类可以根据需要,定义特定于自己的行为。 也就是说子类能够根据需要实现父类的方法。
重写方法不能抛出新的检查异常或者比被重写方法申明更加宽泛的异常。例如: 父类的一个方法申明了一个检查异常 IOException,但是在重写这个方法的时候不能抛出 Exception 异常,因为 Exception 是 IOException 的父类,只能抛出 IOException 的子类异常。
在面向对象原则里,重写意味着可以重写任何现有方法。如下 方法 1.super
public class A { private String nameA="A"; public void getName() { System.out.println("父类"+nameA); } public static void main(String[] args) { }}public class B extends A{ private String nameB="B"; @Override //注解重写方法 public void getName() { System.out.println("子类"+nameB); super.getName(); } public static void main(String[] args) { B b=new B(); b.getName(); }}Output:子类B父类Akeyword : super. 调用父类方法、变量(非 private 修饰) super()调用父类构造器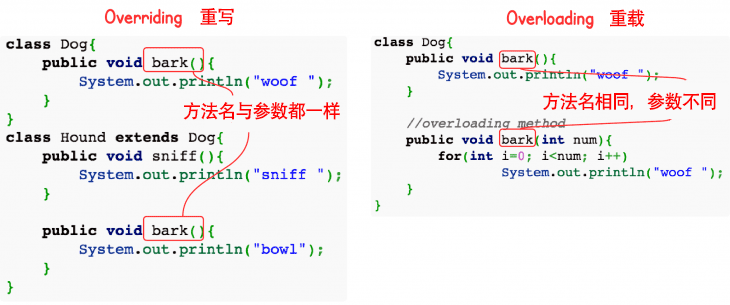
What is the relation between class and object?
变量初始化
三类:1.类的属性
对于第一种变量,Java 虚拟机会自动进行初始化。如果给出了初始值,则初始化为该初始值。如果没有给出,则把它初始化为该类型变量的默认初始值。
int 类型变量默认初始值为 0 **float 类型变量默认初始值为 0.0f double 类型变量默认初始值为 0.0
**boolean 类型变量默认初始值为 false char 类型变量默认初始值为 0(ASCII 码) long 类型变量默认初始值为 0 所有对象引用类型变量(String,Array)默认初始值为 null,即不指向任何对象。
注意数组本身也是对象,所以没有初始化的数组引用在自动初始化后其值也是 null。
2.method 内 local variable
必须进行初始化
3.method 内的参数
语法
高级 for()
int[] nums = {10,20,30,40,50};//方法一:通过数组下标进行遍历for(int i=0;i<nums.length;i++){int n = nums[i];System.out.println(n);}//方法二:使用for-each进行遍历 for(datatype x: nums) for(int i : index)的意思就是说,遍历index数组,每次遍历的对象用i 这个对象去接收。 相当于: int i=0; //用于接收index数组中的某一个对象 for(int j = 0;j<index.length;j++){ i = index[j]; }for(int n:nums){System.out.println(n);}length:
int i = Array.getLength(array);
a.length , s.length() //a 是 int 类数组, s 是 String
编译运行
类——对象——属性、方法
一个文件中只能有一个 public class,表示公开接口。虚拟机会找 public 类中的 main 方法
第 2、 public 类的名字必须和这个编译单元的文件名彻底相同,包括大小写。
对于一个 public 类,它是能够被项目中任何一个类所引用的,只需在使用它前 import 一下它所对应的 class 文件便可。将类名与文件名一一对应就能够方便虚拟机在相应的路径(包名)中找到相应的类的信息。若是不这么作的话,就很难去找,并且开销也会很大。
java 中的修饰符分为类修饰符,字段修饰符,方法修饰符。根据功能的不同,主要分为以下五种。
权限访问修饰符
public,protected,default,private,这四种级别的修饰符都可以用来修饰类、方法和字段。
public–publicinstance variables and methods are inherited•
protected–protectedinstance variables and methodsare inherited•
private– any privateinstance variables and methodsare not inherited and cannot be seen by the subclass
(一般实例变量用 private 修饰)

private int[] age; //private 封装了 class 中的 age 属性
非访问修饰符
抽象方法控制符 abstract 、静态方法控制符 static 、最终方法控制符 final 、本地方法控制符 native 、同步方法控制符 synchronized
(1)抽象方法控制符 abstract : 抽象类不能用来实例化对象,声明抽象类的唯一目的是为了将来对该类进行扩充。
一个类不能同时被 abstract 和 final 修饰。如果一个类包含抽象方法,那么该类一定要声明为抽象类,否则将出现编译错误。
抽象类可以包含抽象方法和非抽象方法。
(2)静态方法控制符 static :用修饰符 static 修饰的方法称为静态方法。静态方法是属于整个类的类方法;而不使用 static 修饰、限定的方法是属于某个具体类对象的方法。 由于 static 方法是属于整个类的,所以它不能操纵和处理属于某个对象的成员变量,而只能处理属于整个类的成员变量,即 static 方法只能处理 static 的域。
(3)最终方法控制符 final :final 类不能被继承;final 方法不能重写,可被继承;final 成员变量可以继承。
用修饰符 final 修饰的方法称为最终方法。最终方法是功能和内部语句不能更改的方法,即。final 固定了方法所具有的功能和操作,防止当前类的子类对父类关键方法的错误定义,保证了程序的安全性和正确性。所有被 private 修饰符限定为私有的方法,以及所有包含在 final 类 ( 最终类)不能被 extends
当变量是 final 时,通过将 final 局部变量”复制”一份,复制品直接作为局部内部中的数据成员.这样:当局部内部类访问局部变量 时,其实真正访问的是这个局部变量的”复制品”(即:这个复制品就代表了那个局部变量).因此:类内其他方法访问局部变量需要设置其为 final
(4)本地方法控制符 native :用修饰符 native 修饰的方法称为本地方法。为了提高程序的运行速度,需要用其它的高级语言书写程序的方法体,那么该方法可定义为本地方法用修饰符 native 来修饰。
(5)同步方法控制符 synchronized :该修饰符主要用于多线程程序中的协调和同步
Static keyword

static 静态成员变量:被类共享,无需初始化变量,方便调用
静态成员变量虽然独立于对象,但是不代表不可以通过对象去访问,所有的静态方法和静态变量都可以通过对象访问(只要访问权限足够)。 this 访问
this.方法名称
用来访问本类的成员方法
this(); //访问本类的构造方法
static final:定义常量
static 方法:可重写不能重载,隐藏,其中不能使用非静态方法(main 中不能直接调用非静态方法),不能使用非静态变量
instance method can invoke static method
想在不创建对象的情况下调用某个方法,就可以将这个方法设置为 static。我们最常见的 static 方法就是 main 方法,只能访问 static 变量。因为程序在执行 main 方法的时候没有创建任何对象,因此只有通过类名来访问。
import
-
单类型导入(single-type-import) (例:import java.util.ArrayList; )
-
按需类型导入(type-import-on-demand) (例:import java.util.*;)
java 以这样两种方式导入包中的任何一个 public 的类和接口
Method
函数声明的变量时候叫 Parameter,形参 函数调用的变量时候叫 Argument,实参
Java 语言中的“方法”(Method)在其他语言当中也可能被称为“函数”(Function)。{}框住
图片缺失java 中的 length 属性是针对数组说的,比如说你声明了一个数组,想知道这个数组的长度则用到了 length 这个属性。java 中的 length()方法是针对字符串 String 说的,如果想看这个字符串的长度则用到 length()这个方法
String
String 一般指 java.lang.String 类,作为字符串.是对象不是数据类型
对字符串常量池进行总结:
当用 new 关键字创建字符串对象时, 不会查询字符串常量池; 当用双引号直接声明字符串对象时, 虚拟机将会查询字符串常量池. 说白了就是: 字符串常量池提供了字符串的复用功能, 除非我们要显式创建新的字符串对象, 否则对同一个字符串虚拟机只会维护一份拷贝。
StringBuffer and StringBuilder
- 操作少量的数据: 适用 String
- 单线程操作字符串缓冲区下操作大量数据: 适用 StringBuilder are mutable
- 多线程操作字符串缓冲区下操作大量数据: 适用 StringBuffer are mutable
    String a = "hello2";    String b = "hello";    String c = b + 2;    System.out.println((a == c));    输出结果为:false。由于有符号引用的存在,所以  String c = b + 2;不会在编译期间被优化,不会把b+2当做字面常量来处理的
    String a = "hello2";    final String b = "hello";    String c = b + 2;    System.out.println((a == c));    输出结果为:true。对于被final修饰的变量,会在class文件常量池中保存一个副本,也就是说不会通过连接而进行访问
String <—> 包装类
String —> Integer: Integer i1 = new Integer(“12”); 或者 Integer i1 = Integer.valueOf(“12”) 包装类 —> String: String str = 任何对象.toString();
Stringbuffer(synchronisation) vs. new StringBuilder(“cat”); 5.0 后新方法
Scanner class
1.把 word 当成 delimiter myScanner.next()
2.读取 primitive type values
3.Reading console input : new Scanner(System.in)
equals ==区别
对于基本数据类型来说,==比较的是值。对于引用数据类型来说,==比较的是对象的内存地址。
因为 Java 只有值传递,所以,对于 == 来说,不管是比较基本数据类型,还是引用数据类型的变量,其本质比较的都是值,只是引用类型变量存的值是对象的地址。
equals() 作用不能用于判断基本数据类型的变量,只能用来判断两个对象是否相等。equals()方法存在于Object类中,而Object类是所有类的直接或间接父类。
“equals()` 方法存在两种使用情况:
- 类没有覆盖
equals()方法 :通过equals()比较该类的两个对象时,等价于通过“==”比较这两个对象,使用的默认是Object类equals()方法。 - 类覆盖了
equals()方法 :一般我们都覆盖equals()方法来比较两个对象中的属性(值)是否相等;若它们的属性(值)相等,则返回 true(即,认为这两个对象相等)。
举个例子:
public class test1 { public static void main(String[] args) { String a = new String("ab"); // a 为一个引用 String b = new String("ab"); // b为另一个引用,对象的内容一样 String aa = "ab"; // 放在常量池中 String bb = "ab"; // 从常量池中查找 if (aa == bb) // true System.out.println("aa==bb"); if (a == b) // false,非同一对象 System.out.println("a==b"); if (a.equals(b)) // true System.out.println("aEQb"); if (42 == 42.0) { // true System.out.println("true"); } }}Copy to clipboardErrorCopied说明:
String中的equals方法是被重写过的,String的equals方法比较的是对象的值。- 当创建
String类型的对象时,虚拟机会在常量池中查找有没有已经存在的值和要创建的值相同的对象,如果有就把它赋给当前引用。如果没有就在常量池中重新创建一个String对象。
一、equeals 相等,那么 hashCode 一定相等
二、hashCode 相等,那么 equals 不一定返回 true
三、hashCode 不相等,那么 equals 一定不相等
为什么有了 equals 这样有效的方法还需要 hashCode 呢?
因为:
在 HashSet(特性:不含有重复的内容),有新对象加入时,会先计算对象的 HashCode 值来判断对象加入的位置,同时于已有的对象 hashCode 作比较,如果有相同的,再用 equals 去比较,若相同那么则不加入 hashSet,若不相同,会使其加入到其他的位置。如果没有其他对象 hashCode 与之相同的,那么这个对象必定是一个新对象,这样就减少了 equals 的执行次数、先用 hashCode 去比较,从而大大提高了速度
将 String 转换成 int int guess = Integer.parseInt(StringGuess)
ArrayListandArray
array
在数组声明中包含数组长度永远是不合法的!如:int[5] arr; 。因为,声明的时候并没有实例化任何对象,只有在实例化数组对象时,JVM 才分配空间,这时才与长度有关。在数组构造的时候必须指定长度,因为 JVM 要知道需要在堆上分配多少空间。数组不是集合,它只能保存同种类型的多个原始类型或者对象的引用
arraylist:建立在 heap 上 ArrayList
是一个特殊的数组—动态数组。来自于 System.Collections 命名空间;通过添加和删除元素,就可以动态改变数组的长度。
ArrayList arr = new ArrayList(3);//初始容量为3ArrayList<String> arr = new ArrayList<E>();ArrayList arr1 = new ArrayList(); //不初始化刚开始的数组容量,当数组容量满时数组会自动一当前数组容量的2倍扩容arr.add()arr.remove()arr.size() arr.get()boolean inIt = arr.constains(f)arr.isEmpty()boolean[] hitsArray = new boolean[2]
二维数组 int a【3】【4】//3 行 4 列
JAVA library API
API(Application Programming Interface,应用程序编程接口)是一些预先定义的函数或类,目的是提供应用程序与开发人员基于某软件或硬件的以访问一组的能力,而又无需访问源码,或理解内部工作机制的细节。
超类:java.lang.Objectis the ultimate parent of EVERY class in java
import java.util.ArrayList; //We need to know what package the class is in
java.lang provides fundamental 自动部署
包括 Math.random()是令系统随机选取大于等于 0.0 且小于 1.0 [0,1)的伪随机 double 值
图片缺失另一种方法
Math.abs(); Math.round();参数上加 0.5,然后进行下取整
Math.max(a,b);
//生成97-122的int型的整型int` `intValue=(``int``)(Math.random()*``26``+``97``);java.io: input output
java.awt: 画画 painting images, users interfaces
JDK Class Library
Lots of classes in the API are abstract
java.lang— Provides classes that are fundamental to the design of the Java programming language.
java.io— Provides for system input and output through data streams, serialization and the file system.
java.awt— Contains all of the classes for creating user interfaces and for painting graphics and images.
Main 函数 psvm
什么是public因为要在类外面调用main()所以是public为什么是static因为系统开始执行一个程序前,并没有创建main()方法所在类的实例对象,它只能通过类名类调用主方法main()作为程序入口,所以该方法是static为什么是void因为主方法没有返回值为什么main主方法名为什么是String args[]或者String[] args?这表示给主方法传一个字符串数组。String[] args是专门用来接收命令行参数的。并默认从args[0]开始接收,然后依次是args[1]、args[2]、args[3]…并且在命令行的输入的字符串中默认以“ ”为分隔符。 public static void main(String args[]){ String s1=args[0]; String s2=args[1]; String s3=args[2]; System.out.println(s3); } 打开cmd,运行指令 java E i love “China” 输出:China 当输入 ebu java program //ebu==args[0] java==args[1] 当输入 "ebu java program" // args[0] == ebu java programinterface 接口
interface 接口名称 [extends 其他的接口名] { // 声明变量 // 抽象方法,无内容 JDK1.8后可以定义方法by default static}有时必须从几个类中派生出一个子类,继承它们所有的属性和方法。但是,Java 不支持多重继承。有了接口,就可以得到多重继承的效果。
接口(interface)是抽象方法和常量值的定义的集合。
从本质上讲,接口是一种特殊的抽象类,这种抽象类中只包含常量和方法的定义,而没有变量和方法的实现。 /*在 JAVA 中,一个类无法继承自多个类,但是可以实现多个接口,使用关键字 implements 多个接口之间使用“,”隔开 多个接口之间,没有先后顺序 这个类叫做实现类,这个类必须实现所有接口的所有方法 */接口与抽象类的区别:
接口里面不可以实现方法体,抽象类可以实现方法体
接口可以多继承接口,抽象类不可以
接口需要被子类实现,抽象类是被子类继承(单一继承)
接口中只能有公有的方法和属性而且****必须赋初始值,抽象类中可以有私有方法和属性
接口中不能存在静态方法,但是属性可以是 final,抽象类中方法中可以有静态方法,属性也可以; 接口的所有的成员必须要 public
4)接口中所有的属性是隐式的 static 和 final 的
public class Bat implements Flyable,Bitable;图片缺失interface 与抽象类
Qustion:
1.为什么不直接在类里面写对应的方法, 而要多写 1 个接口(或抽象类)?
2.既然接口跟抽象类差不多, 什么情况下要用接口而不是抽象类.
3.为什么 interface 叫做接口呢? 跟一般范畴的接口例如 usb 接口, 显卡接口有什么联系呢?
1.为了使用多态,方便调用时重写 1 个对象方法 而不是重载多个
garbage collection
Stack****(local variable and methods)***
Heap****(objects and array)****实例变量在对象中,可被垃圾收集
**在 Java 虚拟机中,对象是在 Java 堆中分配内存的,这是一个普遍的常识。**但是,有一种特殊情况,那就是如果经过逃逸分析后发现,一个对象并没有逃逸出方法的话,那么就可能被优化成栈上分配。这样就无需在堆上分配内存,也无须进行垃圾回收了。
object 的 life 取决于 references
Class variable ,methods use:STATIC
static{ } //set static final 常量
static final 变量在静态存储空间,被所有线程共享。static final 变量可以在定义时初始化。static final 变量可以在静态代码块中初始化。 final 成员变量存储在对象中,不同对象有不同的值。 final 变量可以在定义时初始化。 final 变量可以在构造函数中初始化。
包装类 wrapper class
8 种对应 (Integer String Byte Short Long Boolean Double Float)
自动装箱(Autoboxing):把一个基本类型的变量,直接赋值给对应的包装类变量,或者赋值给 Object 变量(Object 是所有类的父类,子类对象可以直接赋给父类变量----Java 的向上自动转型特性)如:
Integer i=3;或 Object j=4;
自动拆箱(AutoUnboxing):把一个包装类变量,直接赋值给一个基本类型的变量,如:
int a=i;
注意:int b=j;编译会报错,原因是:Java 有向上自动转型特性,但不能自动向下转型,想要转要加强制转换,如:
int b = (Integer)j;
Recursion vs. Iteration
递归(recursion)实际上不断地深层调用函数,直到函数有返回才会逐层的返回,因此,递归涉及到运行时的堆栈开销(参数必须压入堆栈保存,直到该层函数调用返回为止),所以有可能导致堆栈溢出的错误;但是递归编程所体现的思想正是人们追求简洁、将问题交给计算机,以及将大问题分解为相同小问题从而解决大问题的动机。
GUI
Swing 组件
如图所示:swing 组件主要可分为三个部分,后面会详细介绍
(1)顶层容器::常用有 JFrame(默认 size(0)and invisible),JDialog
(2)中间容器:JPanel,JOptionPane,JScrollPane,JLayeredPane 等,主要以 panel 结尾。
(3)基本组件:JLabel,JButton,JTextField,JPasswordField,JRadioButton 等。
java.awt(更慢) vs. javax.swing(more efficient, consistensy across system written by pure JAVA)
Frame 是 Window 的子类,一个 Frame 对象就是一个有标题有边界的顶层窗口。(默认BorderLayout)
Panel 是最简单的容器类,是 Container 的子类。(默认FlowLayout)一个 Panel 对象就是要给应用程序提供空间,用来添加组件,包括其它的 Panel 对象。
Component(Container 是 Component 的子类),Component 是基类
Swing 中使用 JTextField 类实现一个单行文本框,它允许用户输入单行的文本信息
Layout
flowlayout gridlayout borderLayout
myframe.add(button)
5.0 后允许我们可以省去调用getContentPane()而直接在容器内应用 add(),setLayout()和 remove()。然而,我们还是不能忽略了 ContentPane,即使我们可能将不会再使用 ContentPane 来添加部件到容器。
Exception
Using exception让 run-time error 在 compile time 被捕获,更有效
 图片缺失:image-20210920151056607
图片缺失
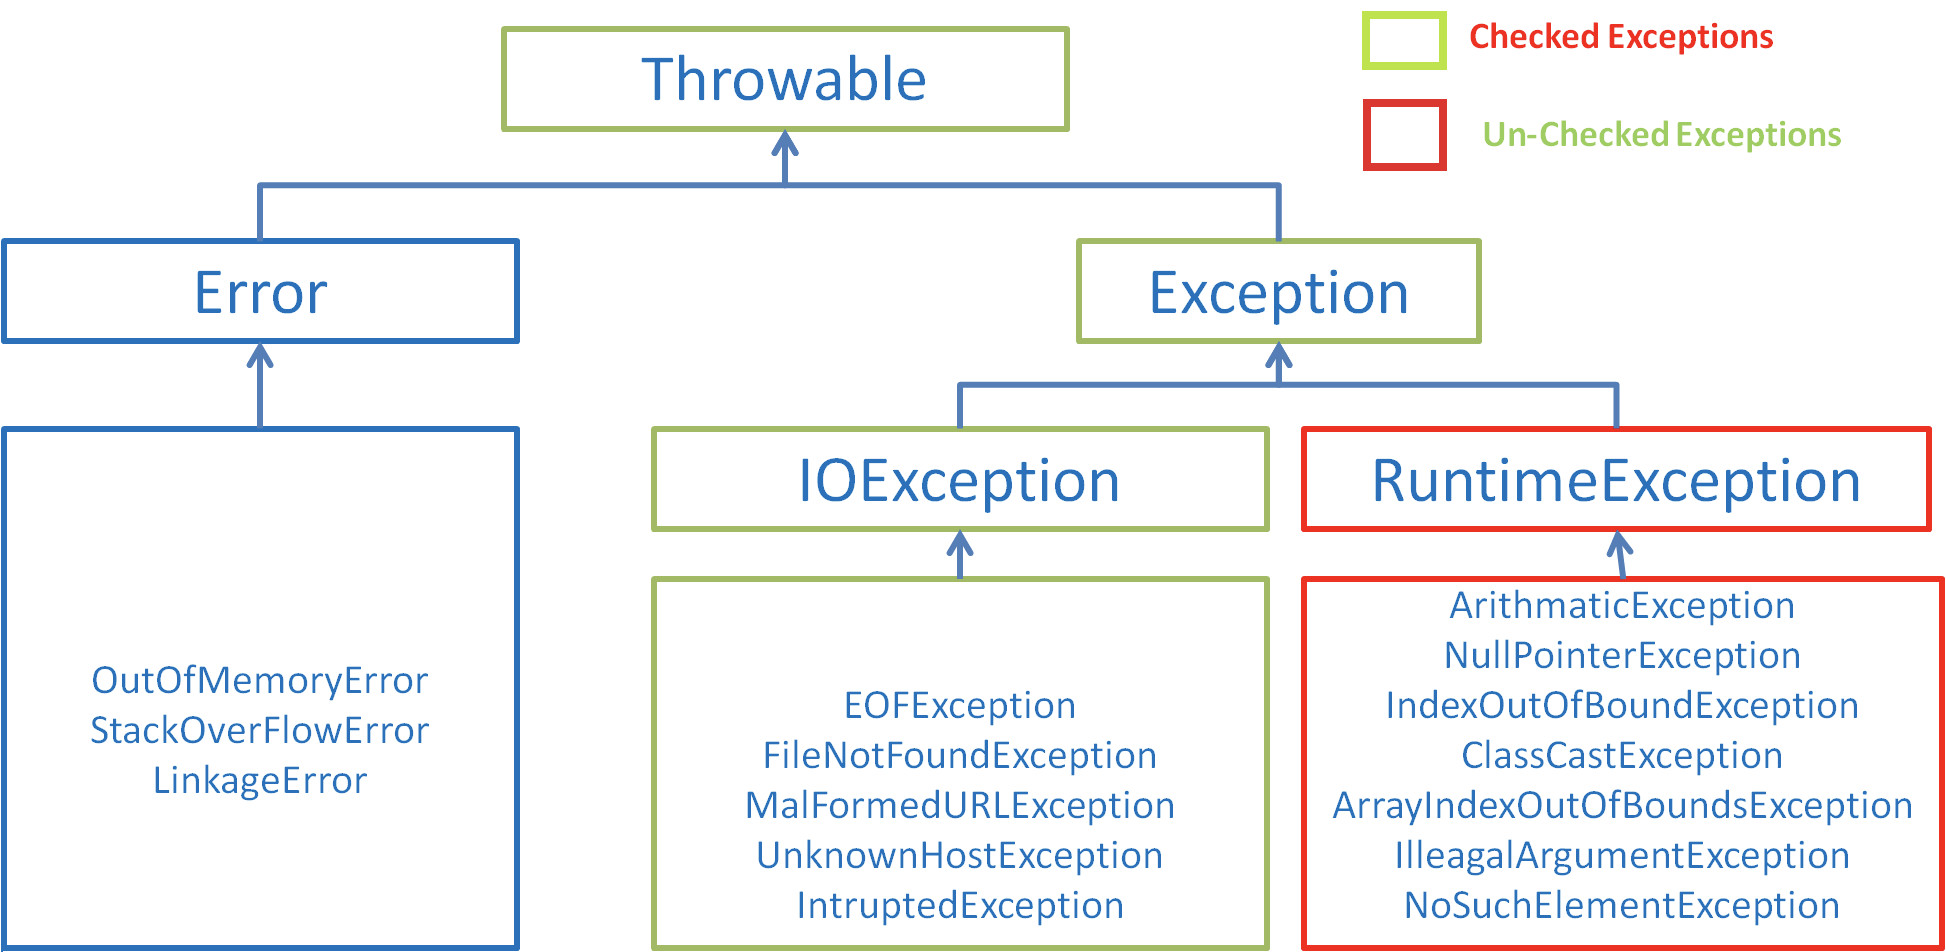
在 Java 中,所有的异常都有一个共同的祖先 java.lang 包中的 Throwable 类。Throwable 类有两个重要的子类 Exception(异常)和 Error(错误)。Exception 能被程序本身处理(try-catch), Error 是无法处理的(只能尽量避免)。
Exception 和 Error 二者都是 Java 异常处理的重要子类,各自都包含大量子类。
当 java 识别到runtime error ,an exception is thrown
-
Exception:程序本身可以处理的异常,可以通过catch来进行捕获。Exception又可以分为 受检查异常(必须处理) 和 不受检查异常(可以不处理)。 -
Error:Error属于程序无法处理的错误,大多数错误与代码编写者执行的操作无关,而表示代码运行时 JVM(Java 虚拟机)出现的问题 ,我们没办法通过catch来进行捕获 。例如,Java 虚拟机运行错误(Virtual MachineError)、虚拟机内存不够错误(OutOfMemoryError)、类定义错误(NoClassDefFoundError)等 。这些异常发生时,Java 虚拟机(JVM)一般会选择线程终止。eg: Exception in thread “main” java.lang.AssertionError:
try catch:自己处理异常
-
try { *可能出现异常的代码 *} catch(Exception e){
e.printStackTrace();
*如果出现了异常类 A 类型的异常,那么执行该代码 *} …(catch 可以有多个)
-
finally { *最终肯定必须要执行的代码(例如释放资源的代码) *}
throw
throw new Exception(“What are u doing”);
(1)throws 用于方法头,表示的只是异常的申明,而 throw 用于方法内部,抛出的是异常对象。
(2)throws 可以一次性抛出多个异常,而 throw 只能一个 (3)throws 抛出异常时,它的上级(调用者)也要申明抛出异常或者捕获,不然编译报错。而 throw 的话,可以不申明或不捕获(这是非常不负责任的方式)但编译器不会报错。
Assertion
判断语句是否为真,假——》
Sort
若一个类要实现 Comparator 接口:它一定要实现 compareTo(T o1,T o2) 函数,但可以不实现 equals(Object obj) 函数。 为什么可以不实现 equals(Object obj) 函数呢? 因为任何类,默认都是已经实现了 equals(Object obj)的。 Java中的一切类都是继承于 java.lang.Object,在 Object.java 中实现了 equals(Object obj)函数;所以,其它所有的类也相当于都实现了该函数。 (2) int compare(T o1, T o2) 是“比较 o1 和 o2 的大小”。返回“负数”,意味着“o1 比 o2 小”;返回“零”,意味着“o1 等于 o2”;返回“正数”,意味着“o1 大于 o2”。 (3) 这个排序算法是“经过调优的合并排序”算法 我们不难发现:Comparable 相当于“内部比较器”,而 Comparator 相当于“外部比较器”。
Collection

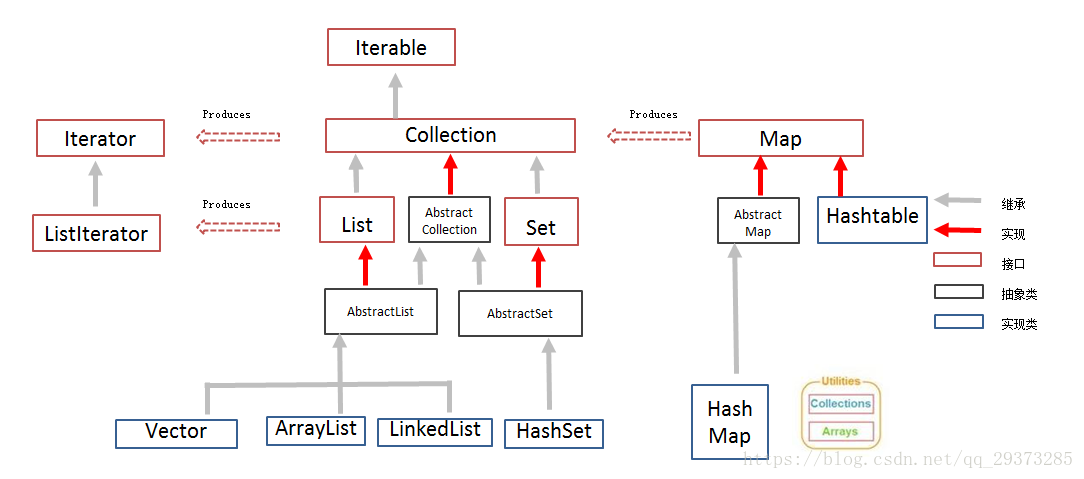
Collection 中的集合,元素是孤立存在的(理解为单身),向集合中存储元素采用一个个元素的方式存储。
Map 中的集合,元素是成对存在的(理解为夫妻)。每个元素由键与值两部分组成,通过键可以找对所对应的值。
Collection 中的集合称为单列集合,Map 中的集合称为双列集合。
需要注意的是,Map 中的集合不能包含重复的键,值可以重复;每个键只能对应一个值。
Map 中常用的集合为 HashMap 集合、LinkedHashMap 集合。
容器
Java 中容器主要分为两大类:Collection 和 Map
容器可以管理对象的生命周期、对象与对象之间的依赖关系,您可以使用一个配置文件(通常是XML),在上面定义好对象的名称、如何产生(Prototype 方式或 Singleton 方式)、哪个对象产生之后必须设定成为某个对象的属性等,在启动容器之后,所有的对象都可以直接取用,不用编写任何一行程序代码来产生对象,或是建立对象与对象之间的依赖关系。
List
图片缺失Hashmap
HashSet 底层是 HashMap,HashMap 的底层(数组+链表+红黑树)来实现的,它之所以有相当快的查询速度主要是因为它是通过计算散列码来决定存储的位置。
HashMap 中,键值对的存储是通过 1. put(key,vlaue)
get 方法,传入 key,就可以查询到 value。 HashMap 的底层数组长度总是 2 的 n 次方,
HashTable,不同的是:key 和 value 的值均不允许为 null;它支持线程的同步,即任一时刻只有一个线程能写 Hashtable,因此也导致了 Hashtale 在写入时会比较慢。
解决 HashMap 的哈希碰撞?
Java 中 HashMap 是利用“拉链法”处理 HashCode 的碰撞问题。在调用 HashMap 的 put 方法或 get 方法时,都会首先调用 hashcode 方法,去查找相关的 key,当有冲突时,再调用 equals 方法。hashMap 基于 hasing 原理,我们通过 put 和 get 方法存取对象。当我们将键值对传递给 put 方法时,他调用键对象的 hashCode()方法来计算 hashCode,然后找到 bucket(哈希桶)位置来存储对象。当获取对象时,通过键对象的 equals()方法找到正确的键值对,然后返回值对象。HashMap 使用链表来解决碰撞问题,当碰撞发生了,对象将会存储在链表的头节点。hashMap 在每个链表节点存储键值对对象。当两个不同的键却有相同的 hashCode 时,他们会存储在同一个 bucket 位置的链表中。键对象的 equals()来找到键值对
HashCode 是使用 Key 通过 Hash 函数计算出来的,由于不同的 Key,通过此 Hash 函数可能会算的同样的 HashCode,所以此时用了拉链法解决冲突,把 HashCode 相同的 Value 连成链表. 但是 get 的时候根据 Key 又去桶里找,如果是链表说明是冲突的,此时还需要检测 Key 是否相同
Hashmap 扩容:扩大数组长度,对原数组进行 rehash 操作,把原数组 copy 到新数组中 resize()
deque(double-ended queue,双端队列)是一种具有队列和栈的性质的数据结构。双端队列中的元素可以从两端弹出)。**虽然没有严格要求 Deque 实现禁止插入 null 元素,但强烈鼓励他们这样做。**强烈建议允许使用 null 元素的任何 Deque 实现的用户不要利用插入 null 的能力。这是因为 null 被各种方法用作特殊返回值来指示双端队列为空。
Queue 中 remove() 和 poll()都是用来从队列头部删除一个元素。 在队列元素为空的情况下,remove() 方法会抛出 NoSuchElementException 异常,poll() 方法只会返回 null 。
使用 java 的同学请注意,如果你使用 Stack 的方式来做这道题,会造成速度较慢; 原因的话是 Stack 继承了 Vector 接口,而 Vector 底层是一个 Object[]数组,那么就要考虑空间扩容和移位的问题了。 可以使用 LinkedList 来做 Stack 的容器,因为 LinkedList 实现了 Deque 接口,所以 Stack 能做的事 LinkedList 都能做,其本身结构是个双向链表,扩容消耗少。 但是我的意思不是像 100% 代码那样直接使用一个 LinkedList 当做队列,那确实是快,但是不符题意。 贴上代码,这样的优化之后,效率提高了 40%,超过 97%。
Vector 类实现了一个动态数组。和 ArrayList 很相似,但是两者是不同的:
- Vector 是同步访问的。
- Vector 包含了许多传统的方法,这些方法不属于集合框架。
使用场景
1.需要线程同步
使用 Collections 工具类中 synchronizedXxx()将线程不同步的 ArrayDeque 以及 LinkedList 转换成线程同步。
2.频繁的插入、删除操作:LinkedList
3.频繁的随机访问操作:ArrayDeque
4.未知的初始数据量:LinkedList
list.add() list.remove()
PriorityQueue 中常用的方法很多。来看几个常用的。
(1)add:插入一个元素,不成功会抛出异常
public boolean add(E e) { return offer(e);}
我们看到 add 方法其实是通过调用 offer 方法实现的。我们直接看 offer 方法
(2)offer:插入一个元素,不能被立即执行的情况下会返回一个特殊的值(true 或者 false)
File
Stream
1 处理的数据单位不同,可分为:字符流,字节流
2.数据流方向不同,可分为:输入流,输出流
3.功能不同,可分为:节点流,处理流。图片缺失
过滤流就是对节点流进行一系列的包装。例如 BufferedInputStream 和 BufferedOutputStream,使用已经存在的节点流来构造,提供带缓冲的读写,提高了读写的效率,以及 DataInputStream 和 DataOutputStream,使用已经存在的节点流来构造,提供了读写 Java 中的基本数据类型的功能。他们都属于过滤流。bytestream characterstream
out 就是 System 里面的一个静态数据成员,而且这个成员是 java.io.PrintStream 类的引用。如下图,被关键字 static 修饰的成员可以直接通过”类名.成员名”来引用,而无需创建类的实例。所以 System.out 是调用了 System 类的静态数据成员 out。
OutputStreamWriter 是从字符流到字节流的桥接怎么理解?
 1、字符的输出需要通过字符流来操作,但是本质最后还是通过字节流输出到计算机上进行存储的
 2、 因此OutputStreamWriter流的作用就是利用字节流作为底层输出流然后构建字符输出流,字符输出流输出字符到流中,然后通过指定的字符集把流中的字符编码成字节输出到字节流中,其作用就是一个桥梁,使得双方链接起来
OutputStream 需要封装在 PrintWriter 中以使用 println.
在 try and catch 中写 read and write
FileReader fr = new FileReader()
BufferedReader in = new BufferedReader(new InputStreamReader(socket.getInputStream()));
PrintWriter out = new PrintWriter(new BufferedWriter(new OutputStreamWriter(socket.getOutputStream())), true);
Questions
只要是客户端通过访问服务器调取计算或者存储资源的,统统都是 C/S 架构。所谓的 Browser-Server 架构其实是 C/S 架构的一种特殊的实现形式,而不是其对立面。
float i =1; java 方法总是以小写开头
println(i) //1.0 println 在结尾加上换行符,将输出光标定位在下一行的开始
错误
runtime or compile time
- java.lang.NullPointerException
- OutOfBounds
java 需要标识符
(1)类的内部不能直接写代码,但可以定义变量,代码只能写在方法内部,作为方法体。main是很特殊的方法。(2)出错往往是不仔细,导致花括号{或}位置往前或往后,或者是多,也可能是少加花括号,导致语句被排除在方法之外,直接处在类当中。(3)也可能是类当中直接忘记写方法。而深复制则不同,它不仅将原对象的各个属性逐个复制出去,而且将原对象各个属性所包含的对象也依次采用深复制的方法递归复制到新对象上。
补充

单核 cpu 同一时间只能运行一个线程
区别:进程是操作系统分配资源的基本单位,线程是任务调度和执行的
1.CPU 角度来看:
我们以 Intel 的 Core i5-8250U 为例来举例,它是四核八线程的 CPU ,
我认为是一个 CPU 集成了 4 个核心,一般来说一个核心对应一个线程,Intel 通过超线程技术来实现一个核心对应 2 个线程,所以它是四核 8 线程.
线程数:是同一时刻设备能并行执行的程序个数,这里说的线程是 CPU 级别的,不是 java 里的线程.
2.操作系统角度:
在操作系统中,进程是最小的资源分配单位,在一个进程中可以有多个线程.如下
我们可以看到这个任务管理器的图,我电脑是 4 核 8 线程的 CPU,我的电脑四核八线程,是采用超线程技术将一个物理处理核心模拟成两个逻辑处理核心.
我认为,一个逻辑处理器核心同一时间点只能执行一个进程,那理论上最多应该同时执行 8 个进程啊.
我的电脑同时开启了 213 个进程,2900 个线程,那它是怎么处理的呢?我找了下资料
原来操作系统是采用的是时间片轮转的抢占式调度方式,每个进程有各自独立的一块内存,使得各个进程之间内存地址相互隔离,
由于 CPU 的执行效率非常高,时间片非常短,在各个任务之间快速地切换,给人的感觉就是多个任务在“同时进行”.