NOTES
目录
- NOTES
- Crypto
- 求模运算的规律
- MIS
- Questions
- 高并发解决
- System Design
- 第二步,Service 服务
- 第三步,Storage 存储
- 操作系统 OS
- 并发
- 进程间通信
- 什么是虚拟内存
- pointer
- 软工
- Testing
- 设计模式
- SOLID 原则
- leetcode
- 位运算
- 树和二叉树
- 平方根
- 滑动窗口
- 复杂度
- WEB 开发
- Restful 规范
- springboot
- Database
- 负载均衡
- 数据库系统
- 信息检索
- 索引
- 分布式
- 微服务
- Linux
- linux 网络
- 面向对象语言(OO)知识点:
- PYTHON
- 爬虫
- 回车、换行的区别
- 基础数据类型
- Golang
- 函数
- 指针
- Slice 切片
- 并发
- Web 搜索
- Markov
- RNN
- C 程序语言设计:
- 结构体
- 循环
- 基础
- 函数:
- 指针 (*,&运算符)
- 字符串
- 文件 i/o
- 错误
- 物理实验:
- Law
NOTES
Crypto
double DES has the security level of a 57-bit key. AES only supports a 128-bit block size
MITM:
When the sender sends their public key, the attacker substitutes their own public key. • The receiver believes that public key belongs to the sender and encrypts using it.
For example, if you want to establish an encrypted connection with someone over the internet, you need a way to verify that the public key you are using to establish the connection actually belongs to the person you think it does. Without a certificate, you might be vulnerable to a man-in-the-middle attack, where an attacker intercepts your connection and provides you with their own public key, pretending to be the person you are trying to connect with. With a certificate, you can verify the identity of the person you are communicating with by checking the certificate against a trusted list of CA’s.
Prevention:
A certificate (X.509) contains a public key. It is signed with
the private key of the “trusted” authority
Playfair:
首先该密码需要秘钥,与,然后由秘钥制作相应的密码表。秘钥去重后,将秘钥依次填入 5x5 表格(先填纵列),剩下的格子友 a-z 依次填入,如果前面遇到秘钥中的字母就跳过,将 i 和 j 放在同一个格子。如:秘钥是 linux, 填成的密码表为:
l a f o t i/j b g p v n c h q w u d l r y x e m s z 在构建好密码表后,将待加密的明文分为两个一组,同时要保证每组的两个字符不相同,如果相同,则在其中间插入一个 x 获取 q,在进行分组。如果最后还有一个字符单着,则添加一个 x。
分好组后,依次拿出每个组,根据密码表对其加密,加密规则如下:
如果该组的两个字符在密码表的同一行,则密文分别是其紧靠着的右边这个字符。其中第一列被看做是最后一列的右方。 如果该组的两个字符在密码表的同一列,则密文分别是其紧靠着的下边这个字符。之中第一行被看做是最后一行的下方。 如果该组的两个字符即不再同一行,又不在同一类,则密文是其组成的长方形的另外两个顶点(至于横向替换还是纵向替换,这需要双方沟通好)。
Diffie 和 Hellman 虽然提出了公钥密码体制的概念,但是很遗憾,他们没有提出一种公钥加密算法 ,而是提出一种密钥协商协议,史称 Diffie-Hellman密钥协商协议.
Here is an example of the Diffie Hellman protocol, with non-secret values in blue, and secret values in red.

RSA 算法的安全性在于,我们有一个大合数 n = pq,其中 p 和 q 都是特别大的质数(现在要求差不多 150 位十进制),如果只给定这个大合数 n 的话,人们还没找到一个比较高效的算法,在只知道 n 的条件下,算出 n 到底是哪两个质数相乘得来的。
如果两个质数选的满足了一定的条·件,那么很可能你自己实现的 RSA 就容易被破解。
谁知道私钥 d,谁就能分解整数 n。所以我们不能对不同的用户使用相同的 n,否则这两个用户可以分别互相算出对方的私钥。
| ECC | RSA | |
|---|---|---|
| Key length | ||
| 256 bit | 2048 bit | |
| CPU&Memory usage | low | high |
| Network consumption | ||
| low | high | |
| Cracking difficulty | ||
| difficult to crack | difficult to crack, but easier than ECC in theory | |
| Anti aggression | ||
| strong | average | |
| Encryption efficiency | ||
| high | average |
t
在数论中,对正整数n,欧拉函数φ(n)是小于或等于n的正整数中与n互质的数的数目。此函数以其首名研究者欧拉命名,它又称为φ函数(由高斯所命名)或是欧拉总计函数(totient function,由西尔维斯特所命名)。
例如φ(8) = 4


快速幂

求模运算的规律
(a + b) % p = (a % p + b % p) % p(a - b) % p = (a % p - b % p + p) % p(a * b) % p = (a % p * b % p) % p a ^ b % p = ((a % p)^b) % pHave an Authentication Server (AS) – Users initially negotiate with AS to identify self – AS provides a non-corruptible authentication credential (ticket granting ticket TGT)
• Have a Ticket Granting server (TGS) – Users subsequently request access to other services from TGS on basis of users TGT

MD5 的作用是让大容量信息在用数字签名软件签署私人密钥前被”压缩”成一种保密的格式(就是把一个任意长度的字节串变换成一定长的十六进制数字串)。 MD5 其实在我们生活中是很常用的,似乎你并没有注意到,当你下载了一个镜像之后,你会发现下载页面还提供了一组 MD5 值,那么这组 MD5 值是用来做什么的呢?了解了 MD5 的作用之后,你就不难想到,MD5 是用来验证文件的一致性的,当你下载好镜像之后,你需要对该镜像做一次 MD5 的校验,得到的 MD5 值与下载页面提供的 MD5 值进行对比,以此来验证该镜像是否被篡改。 MD5 算法,可以用来保存用户的密码信息。为了更好的保存,可以在保存的过程中,加入盐。/在保存用户密码的时候,盐可以利用生成的随机数。可以将密码结合 MD5 加盐,生成的数据摘要和盐保存起来 。以便于下次用户验证使用。在用户表里面,也保存 salt。 SSL 的最终版本(3.0)与 TLS 的第一版本之间并无明显差异,应用名称更改只是表示所有权改变。
MIS
3 main types of metadata: descriptive, administrative, and use
- Descriptive metadata enables discovery, identification, and selection of resources. It can include elements such as title, author, and subjects.
- Administrative metadata facilities the management of resources. It can include elements such as technical, preservation, rights, and use.
- Use metadata, generally used in machine processing, describes relationships among various parts of a resource, such as chapters in a book.Data exhaust is the data generated as a byproduct of people’s online actions and choices. Data exhaust consists of the various files generated by web browsers and their plug-ins such as cookies, log files, temporary internet files and and . sol files (flash cookies).
Security Concerns with JSON
JSON.parse()只会将标准的 Json 字符串(key 和 value 都由双引号引起来,最外面用单引号括住)转为 JSON 对象。
eval()在转换字符串的时候是比较松的,即使不是标准的 Json 字符串也会被转换成 Json 对象。更重要的是 eval()方法会执行要解析的字符串中的代码,这一点是十分危险的。
XML
Rule= element names must NOT have a space
<1>banned</1> – Rule=tags cannot start with a number ◆
XML Schema Definition,通常简称为 XSD,是一种精确描述 XML 语言的方法。 XSD 根据相应 XML 语言的语法规则检查 XML 文档的结构和词汇的有效性。 //更多请阅读:https://www.yiibai.com/xsd/xsd_overview.html
这是相应的简易元素定义:
<xs:element name=“lastname” type=“xs:string”/>
<xs:element name=“age” type=“xs:integer” default=””/>
<xs:element name=“dateborn” type=“xs:date”/>
兰伯特在论文《The Byzantine Generals Problem》中提到的口信消息型拜占庭问题之解:如果叛将人数为 m,将军人数不能少于 3m + 1 ,那么拜占庭将军问题就能解决了。
拜占庭将军问题描述的是最困难的,也是最复杂的一种分布式故障场景,除了存在故障行为,还存在恶意行为的一个场景。你要注意,在存在恶意节点行为的场景中(比如在数字货币的区块链技术中),必须使用拜占庭容错算法(Byzantine Fault Tolerance,BFT)。除了故事中提到两种算法,常用的拜占庭容错算法还有:PBFT 算法,PoW 算法。
计算机分布式系统中,最常用的是非拜占庭容错算法,即故障容错算法(Crash Fault Tolerance,CFT)。CFT 解决的是分布式的系统中存在故障,但不存在恶意节点的场景下的共识问题。 也就是说,这个场景可能会丢失消息,或者有消息重复,但不存在错误消息,或者伪造消息的情况。常见的算法有 Paxos 算法、Raft 算法、ZAB 协议。
在 Paxos 算法中,有三种角色:
Proposer:提案 Proposal 提出者 Acceptor:决策者,可以批准议案 Learner:最终决策的学习者 Paxos 算法安全性前提如下:
只有被提出的 value 才能被选定。 只有一个 value 被选定,并且如果某个进程认为某个 value 被选定了,那么这个 value 必须是真的被选定的那个。 Paxos 算法类似于两阶段提提交 ———————————————— Raft makes several guarantees to the user – only one will be discussed here. • Election safety: at most one leader can be elected in a given term. • Uses a “heartbeat” mechanism: All nodes continually receive messages from the leader
哲学家就餐问题(英语:Dining philosophers problem)是在计算机科学中的一个经典问题,用来演示在并发计算中多线程同步(Synchronization)时产生的问题。
服务生解法[编辑]
一个简单的解法是引入一个餐厅服务生,哲学家必须经过他的允许才能拿起餐叉。因为服务生知道哪只餐叉正在使用,所以他能够作出判断避免死锁。
为了演示这种解法,假设哲学家依次标号为 A 至 E。如果 A 和 C 在吃东西,则有四只餐叉在使用中。B 坐在 A 和 C 之间,所以两只餐叉都无法使用,而 D 和 E 之间有一只空余的餐叉。假设这时 D 想要吃东西。如果他拿起了第五只餐叉,就有可能发生死锁。相反,如果他征求服务生同意,服务生会让他等待。这样,我们就能保证下次当两把餐叉空余出来时,一定有一位哲学家可以成功的得到一对餐叉,从而避免了死锁。
资源分级解法[编辑]
另一个简单的解法是为资源(这里是餐叉)分配一个偏序或者分级的关系,并约定所有资源都按照这种顺序获取,按相反顺序释放,而且保证不会有两个无关资源同时被同一项工作所需要。在哲学家就餐问题中,资源(餐叉)按照某种规则编号为 1 至 5,每一个工作单元(哲学家)总是先拿起左右两边编号较低的餐叉,再拿编号较高的。用完餐叉后,他总是先放下编号较高的餐叉,再放下编号较低的。在这种情况下,当四位哲学家同时拿起他们手边编号较低的餐叉时,只有编号最高的餐叉留在桌上,从而第五位哲学家就不能使用任何一只餐叉了。而且,只有一位哲学家能使用最高编号的餐叉,所以他能使用两只餐叉用餐。当他吃完后,他会先放下编号最高的餐叉,再放下编号较低的餐叉,从而让另一位哲学家拿起后边的这只开始吃东西。
尽管资源分级能避免死锁,但这种策略并不总是实用的,特别是当所需资源的列表并不是事先知道的时候。例如,假设一个工作单元拿着资源 3 和 5,并决定需要资源 2,则必须先要释放 5,之后释放 3,才能得到 2,之后必须重新按顺序获取 3 和 5。对需要访问大量数据库记录的计算机程序来说,如果需要先释放高编号的记录才能访问新的记录,那么运行效率就不会高,因此这种方法在这里并不实用。
Chandy/Misra 解法
,允许任意的用户争用任意数量的资源。与资源分级解法不同的是,这里编号可以是任意的。
WEb sec

A rainbow table is a precomputed table of passwords and their hashes,
彩虹表对包含大量盐的单向哈希无效。例如,考虑使用以下函数生成的密码哈希(其中“ + ”是串联运算符):
saltedhash(password) = hash(password + salt)
要么
saltedhash(password) = hash(hash(password) + salt)
salt 值不是秘密的,可以随机生成并与密码哈希一起存储。大盐值通过确保每个用户的密码被唯一地散列来防止预计算攻击,包括彩虹表。这意味着具有相同密码的两个用户将具有不同的密码哈希值(假设使用不同的盐)。为了成功,攻击者需要为每个可能的盐值预先计算表。salt 必须足够大,否则攻击者可以为每个 salt 值制作一个表。对于使用 12 位盐的旧Unix 密码,这将需要 4096 个表,这会显着增加攻击者的成本,但对于 TB 硬盘驱动器来说并非不切实际。SHA2-crypt和bcrypt方法——用于Linux、BSD Unixes 和Solaris — 有 128 位的盐。[4]这些较大的盐值使得针对这些系统的预计算攻击对于几乎任何长度的密码都不可行。即使攻击者可以每秒生成一百万张表,他们仍然需要数十亿年才能为所有可能的盐生成表。 Or by key strengthening
Injection— Could try to “sanitise” (clean/make safe) data input, but there is a better solution. • Do not create SQL (or similar statements) by adding together strings. • Can use special routines designed to produce these statements. • Languages designed for the web contain functions to help with this. • In Java, PreparedStatement is a class to do this. 34
Questions
Springboot 注解, 多线程池 锁 LOCK,synchronized, 多线程(同时启动 10 个线程 结束时 信号量)
mysql 隔离级别 redis
Array 与 ArrayList 的区别 LinkedList ArrayList O(n) HashMap , HashSet
+128 原码是 1000 0000,反码是 0111 1111,补码是 0111 1111+1=1000 0000 表示-128 整型 int -128 到 127
同时启动 10 个线程,如何保证子线程全部结束再去执行主线程
线程的同时启动,常见的有两种方式控制,在 jdk1.5 的版本下就有这两种控制类:CyclicBarrier 和 CountDownLatch。
ThreadPoolExecutor
1.thread.join,2. 信号量CountDownLatch 等等 3.线程池 ThreadPoolExecutor 的 shutdown 与 awaitTermination 方法
1.eg 大量外部数据排序怎么做, 堆排序、桶排序、归并排序的实现
桶排序如果到达极限情况n=m
时。就能确保避免桶内排序,将数值放到桶中不需要再排序达到 O(n)的排序效果,当然这种情况属于计数排序,后面再详解计数排序记得再回顾
大数据小内存排序问题,很经典,很常见,类似的还有比如 “如何对上百万考试的成绩进行排序” 等等。
三种方法:
- 数据库排序(对数据库设备要求较高)
- 分治法(常见思路)
- 位图法(Bitmap)
2.排序的稳定性是什么
3.协程和线程池,加不加锁
4.线程和进程,OS 的线程与 JVM 的线程一一对应,并行与并发
5.Servlet Springboot 关系
6.Java 的泛型,作用是什么?源码
7.反射和注解
8.数据库事务,索引是什么
9.解释 java 传递实参的引用时为什么是值传递?
JVM 内存模型, 储存在栈的对象引用指向堆中的对象;jVM 传形参时会在栈中创建一个新的对象,每当引用类型作为参数传递时,都会创建一个对象引用(实参)的副本(形参),该形参保存的地址和实参一样。Java 中其实还是值传递的,只不过对于对象参数,值的内容是对象的引用。
HTTPS 是如何保证安全传输的?
https 通过使⽤对称加密、 ⾮对称加密、 数字证书等⽅式来保证数据的安全传输。客户端向服务端发送数据之前,需要先建⽴TCP连接,所以需要先建⽴ TCP 连接,建⽴完 TCP 连接后, 服务端会先给客户端发送公钥,客户端拿到公钥后就可以⽤来加密数据了,服务端到时候接收到数据就可以⽤私钥解密数据,这种就是通过⾮对称加密来传输数据。Client 收到 server key exchange 公钥后发送 client key exchange(与主密钥)通过**⾮对称加密**的⽅式来传输对称加密的秘钥, 通信建立后使用对称加密传输数据减少开销
判断循环链表 原链表反向啊,构造双向链表,快慢指针
高并发解决
在操作系统中,是指一个时间段中有几个程序都处于已启动运行到运行完毕之间,且这几个程序都是在同一个处理机上运行。其中两种并发关系分别是同步和互斥
假如有 1 秒钟有 1 万个请求,我们的 apache 服务器的连接数 500,处理业务的时间为 100ms,4 台服务器的连接数 1 秒内能处理 500*4/0.1=2 万(QPS),完全满足这个要求了,但实际情况是随着请求数的增加,机器处于高负荷的状态,CPU 切换次数增大会严重影响处理时长,很有可能由 100ms 变成 500ms 甚至更长,此时 1 秒钟处理的连接数为 500**4/0.5=4000,这就会导致大量的请求阻塞.时间越长阻塞越大。根据用户的行为特征,越是阻塞就越会去点击请求这样就会雪上加霜,最终拖垮服务进程
二、解决方案
1、前后端分离
前端采用静态 html 页面,这样就不需要进行视图渲染了,减少性能开销。一些静态页面、css 样式、js 可以采用 CDN 加速。前后端分离可以独立发布,前端有问题,可以直接改好发布而不需要重启服务端,一些大型项目启动服务端会耗费很长时间,如果此时访问量很大的话就会出现阻塞现象。
2、服务端接口处理速度要快
1)引入缓存
就比如上面的场景,优化代码缩短处理时间也是可以解决的。像这种高并发的情况,能不查数据库就不查数据库,因为数据库的连接也是有限的,比如 mysql 连接 z 数好像在 500 左右,而且连接数据库也是耗时间的。这种情况可以想办法将数据放入缓存,比如 redis,redis 连接数在 5 万左右且查询速度远比数据库要快,会节省大量查询时间。还有些数据是基础数据一直都不会变的,可以加载到本地缓存比如谷歌的 guava
2)尽量使用乐观锁
悲观锁是互斥的,遇到加锁状态必须等待,这会增加阻塞的概率。而且高并发的情况下,有些线程可能永远都拿不到锁,对用户体验是非常差的。
乐观锁可以解决这个问题,不过乐观锁有时候会更新不到数据,此时就会去重试,增加系统开销,但相对悲观锁来说会好很多。可以使用 redis 的 watch 功能(redis 乐观锁)
3)拆分功能-微服务概念
比如一个系统里有会员信息、商品信息、交易信息,那么我们可以拆成 3 个微服务,图片、文件用专门的服务器存储,每个应用单独部署,且每个微服务部署集群,每个微服务有自己的数据库。这样就会用户请求跟数据交互都分流了。
这个会增加成本,不过既要性能高又要成本低不太现实,看实际情况了。如果高并发长时间才会搞一次,可以采取灵活部署的办法,平常可以一台服务器部署多个微服务,等活动开始的时候增加机器分开部署
4)削峰
削峰主要通过消息来处理,比如 rabbitMq、kafka,这种行为属于偷懒行为,对于实时性要求不高的场景是可以的。一般 QPS 为 1 万以上的推荐 kafka,实时性要求非常高的用 rabbitmq。
5)重启与过载保护
假如服务进程挂了,这样的高并发情况下,重启几乎是无效的,重启就会立马崩溃掉,此时需要加一个服务网关做限流控制,还有用到 redis 的需要预热操作
3、从用户行为上做控制
1)页面上不让用户重复点击,点击后置灰,别小看这个功能,可以减少 50% 的无效请求。
2)防作弊,有些用户可以通过技术手段绕过上面的限制,这样就需要在服务端做限制了。比如限流,配置一个用户一定时间内最多访问多少请求,可以用 redis 存储用户的请求次数,最好用 watch 功能,避免用户同时操作。有些黄牛可能有多个用户,那么就需要针对 IP 做限制了,比如增加验证码,当然也可以直接对 IP 做限流,不过可能会误伤部分用户。
3)有些黄牛会模拟真实场景,比如 12306 抢票,这样的话只能通过大数据分析了,根据用户行为筛选出哪些账户是僵尸账户,平常不动,高峰期就活跃了,这样可以有针对性的对这些用户做限制操作
4、考虑事务问题
高并发的情况下如果不做控制很容易出现数据错乱的问题,解决这个问题需要数据同步。
大致思路有:
1、悲观锁
比如 synchronized,lock,redis 分布式锁,悲观锁容易造成阻塞
2、同步队列
请求全部进入一个同步队列里,然后一个个操作,跟悲观锁类似,也容易造成阻塞
3、乐观锁
数据库加版本号,每次更新操作需要带版本号进行幂等操作。也可以用 redis 的 watch 功能,乐观锁操作会有很多无效操作,增加重试开销,但相对引起阻塞的问题这点性能开销还是可以接受的,所以高并发情况下最好还是用乐观锁
互联网正在高速发展,使用互联网服务的用户越多,高并发的场景也变得越来越多。电商秒杀和抢购,是两个比较典型的互联网高并发场景。虽然我们解决问题的具体技术方案可能千差万别,但是遇到的挑战却是相似的,因此解决问题的思路也异曲同工。
个人整理并发解决方案。
a.应用层面:读写分离、缓存、队列、集群、令牌、系统拆分、隔离、系统升级(可水平扩容方向)。
b.时间换空间:降低单次请求时间,这样在单位时间内系统并发就会提升。
c.空间换时间:拉长整体处理业务时间,换取后台系统容量空间。
System Design
https://zhuanlan.zhihu.com/p/191057045
需要设计哪些功能(也可以自己想),需要承受多大的访问量?
首先可以把 Twitter 的功能一个个罗列出来,很显然你无法在 45 分钟的面试中完成所有功能的设计,所以需要筛选出核心功能(Post a Tweet,Timeline,News Feed,Follow/Unfollow a user,Register/Login)。
然后有的面试官可能会问你系统承受的 QPS 大概是多少?需要考虑并发用户,读频率(Read QPS)以及写频率(Write QPS)。记住重要的是你的思考和计算过程而不是计算结果。
分析 QPS 有什么用?
- 如果 QPS = 100,那么用你的笔记本作 Web 服务器就好了;
- QPS = 1K,一台好点的 Web 服务器也能应付,需要考虑 Single Point Failure;
- QPS = 1m,则需要建设一个 1000 台 Web 服务器的集群,并且要考虑如何 Maintainance(某一台挂了怎么办)。
QPS 和 服务器/数据库之间的关系
- 一台 Web Server 承受量约为 1K 的 QPS(考虑到逻辑处理时间以及数据库查询的瓶颈);
- 一台 SQL Database 承受量约为 1K 的 QPS(如果 JOIN 和 INDEX query 比较多的话,这个值会更小);
- 一台 NoSQL Database (Cassandra) 约承受量是 10k 的 QPS;
- 一台 NoSQL Database (Memcached) 约承受量是 1M 的 QPS。
第二步,Service 服务
所谓服务可以认为是逻辑处理的整合,对于同一类问题的逻辑处理可以归并到一个服务中。这一步实际上就是将整个系统细分为若干个小的服务。
根据第一步选出的核心功能,我们可以将推特拆分成如下的几个服务:

第三步,Storage 存储
接下来就是 4S 分析法中最重要的一部分,存储。根据每个服务的数据特性选择合适的存储结构,然后细化数据表结构。
操作系统 OS
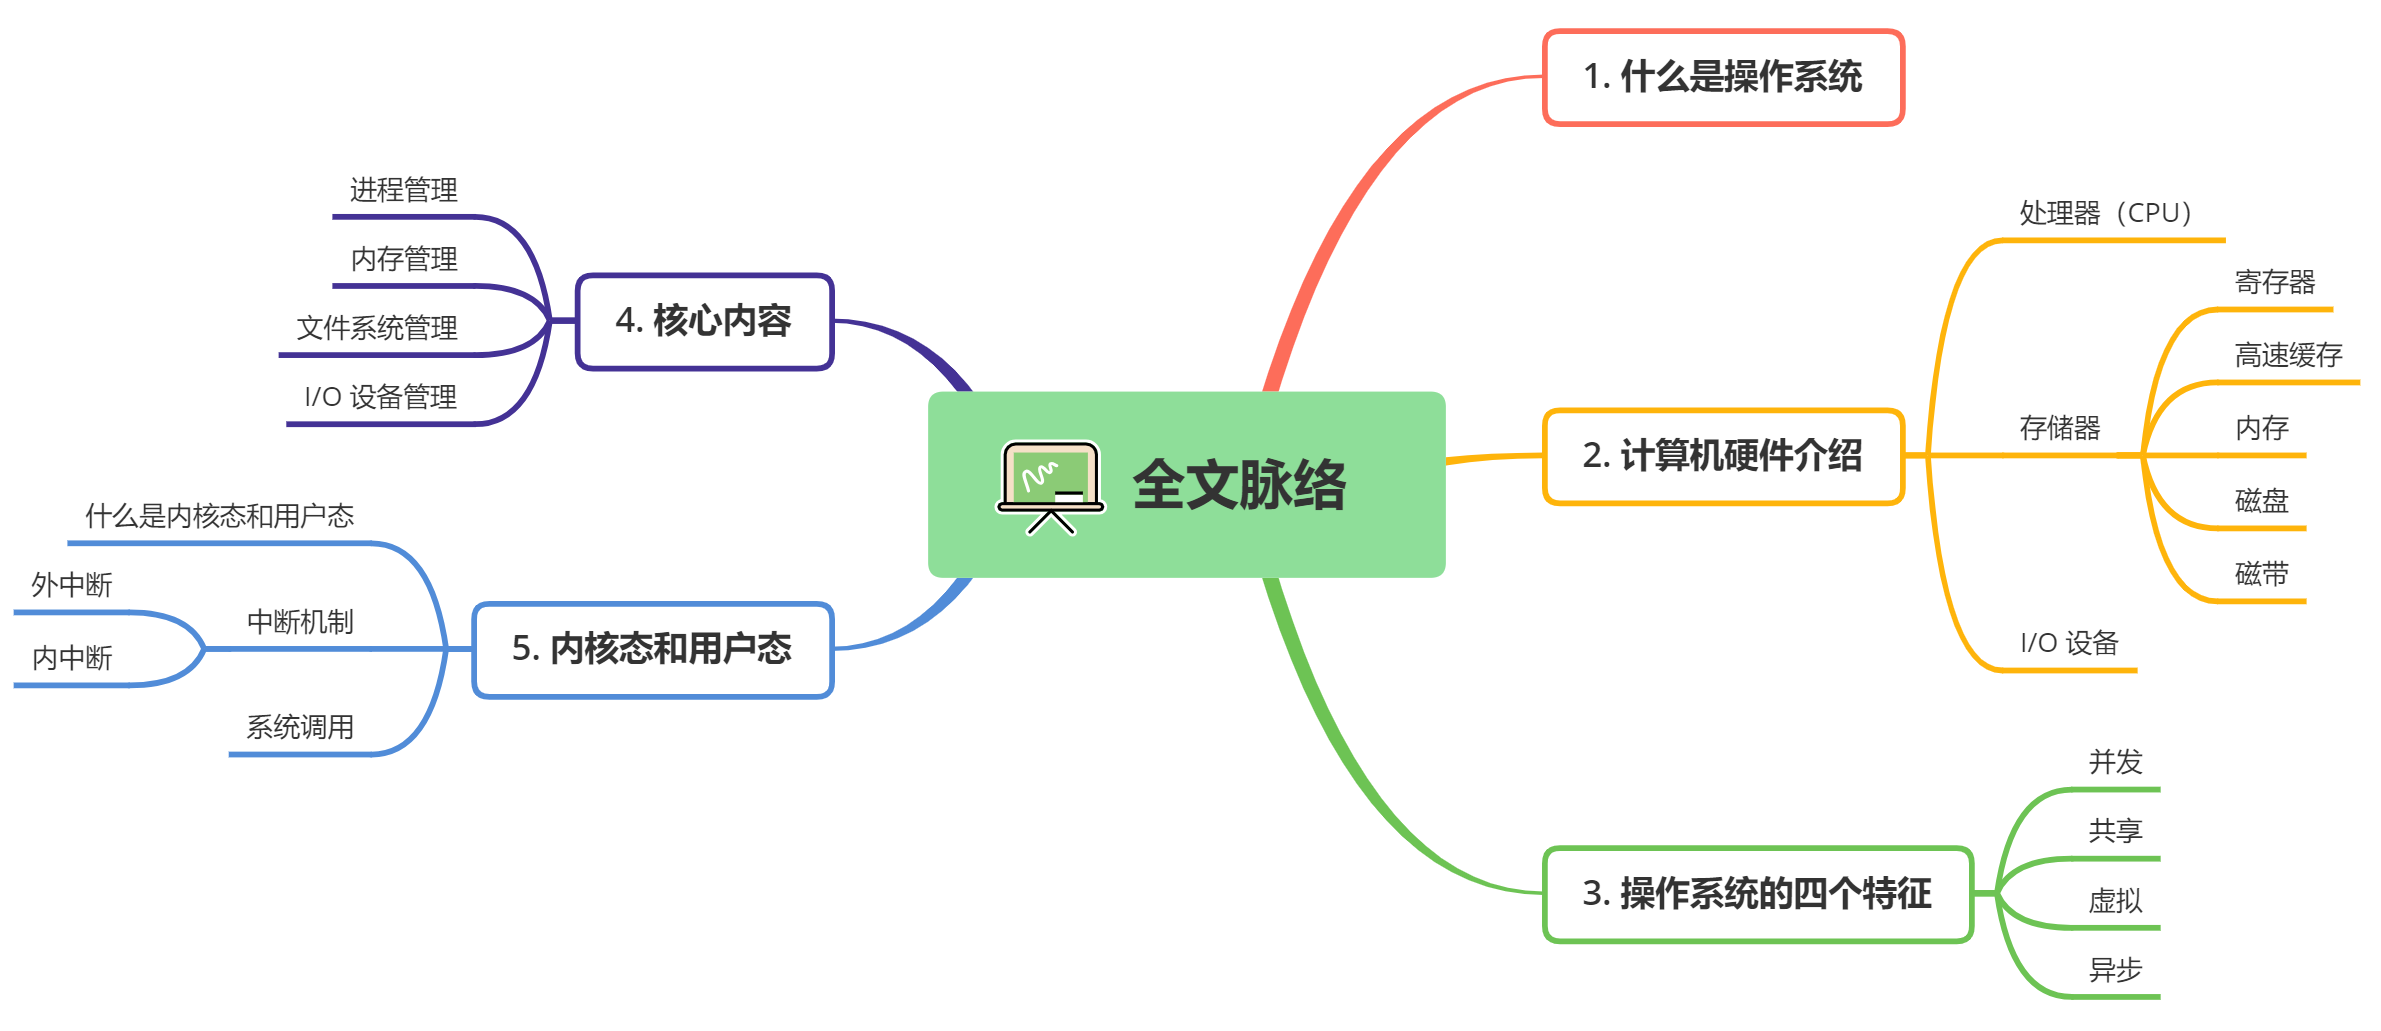
地址空间(address space)表示任何一个计算机实体所占用的内存大小
存储器抽象
在计算机中,每个设备以及进程都被分配了一个地址空间。处理器的地址空间由其地址总线以及寄存器决定。地址空间可以分为 Flat——表示起始空间位置为 0;或者 Segmented——表示空间位置由偏移量决定。在一些系统中,可以进行地址空间的类型转换。至于 IP 地址空间,IPV4 协议并没有预见到 IP 地址的需求量如此之大,32 位的地址空间已经无法满足需求了。因此,开发了IPV6 协议,支持 128 位的地址空间 [1] 。
暴露问题
把物理地址暴露给进程会带来下面几个严重问题。第一,如果用户程序可以寻址内存的每个字节,它们就可以很容易地(故意地或偶然地)破坏操作系统,从而使系统慢慢地停止运行。即使在只有一个用户进程运行的情况下,这个问题也是存在的。第二,使用这种模型,想要同时(如果只有一个 CPU 就轮流执行)运行多个程序是很困难的。在个人计算机上,同时打开几个程序是很常见的(一个文字处理器,一个邮件程序,一个网络浏览器,其中一个当前正在工作,其余的在按下鼠标的时候才会被激活)。在系统中没有对物理内存的抽象的情况下,很难做到上述情景,因此,我们需要其他办法。
寄存器是 CPU 内部高速存取数据的地方,比缓存更接近 CPU 的运算器。 8086 是 16 位 cpu(字长 16 位):
其 CPU 一次最多可处理 16 位数据 寄存器最大宽度位 16 位 寄存器与 PU 之间的通路位 16 位。 地址 20 位,最大可寻址 220 = 1MB 地址空间
并发
并发 Concurrent:无论上一个开始执行的任务是否完成,当前任务都可以开始执行 (也就是说,A B 顺序执行的话,A 一定会比 B 先完成,而并发执行则不一定。) 与可以一起执行的并行(parallel)相对的是不可以一起执行的串行(serial)
并发:从宏观方面来说,并发就是同时进行多种时间,实际上,这几种时间,并不是同时进行的,而是交替进行的,而由于 CPU 的运算速度非常的快,同一时间只有一个线程运行
并行:则是真正意义上的同时进行多种事情。这种只可以在多核 CPU 的基础上完成。
综上,并发与并行并不是互斥的概念,只是前者关注的是任务的抽象调度、后者关注的是任务的实际执行。而它们又是相关的,比如并行一定会允许并发。 所以题目中的例子:
cpu
CPU 里有两部分: 一部分叫做 Control Unit,负责控制。比如计数器,指令寄存,等等。
一部分叫做 Logic Unit,负责运算。比如加法器,累加器,等等。有些也会把 ‘ 数据总线’ 归于逻辑运算单元里
单核 CPU 多任务:并发(不必等上一个任务完成才开始下一个任务)、串行(只有一个实际执行任务的 CPU 核)
外储存器是指除计算机内存及 CPU 缓存以外的储存器,此类储存器一般断电后仍然能保存数据。常见的外存储器有硬盘、软盘、光盘、U 盘等

单核 cpu 同一时间只能运行一个线程
区别:进程是操作系统分配资源的基本单位,线程是任务调度和执行的
1.CPU 角度来看:
我们以 Intel 的 Core i5-8250U 为例来举例,它是四核八线程的 CPU ,
我认为是一个 CPU 集成了 4 个核心,一般来说一个核心对应一个线程,Intel 通过超线程技术来实现一个核心对应 2 个线程,所以它是四核 8 线程.
线程数:是同一时刻设备能并行执行的程序个数,这里说的线程是 CPU 级别的,不是 java 里的线程.
2.操作系统角度:
在操作系统中,进程是最小的资源分配单位,在一个进程中可以有多个线程.
我们可以看到这个任务管理器的图,我电脑是 4 核 8 线程的 CPU,我的电脑四核八线程,是采用超线程技术将一个物理处理核心模拟成两个逻辑处理核心.
我认为,一个逻辑处理器核心同一时间点只能执行一个进程,那理论上最多应该同时执行 8 个进程啊.
我的电脑同时开启了 213 个进程,2900 个线程,那它是怎么处理的呢?我找了下资料
原来操作系统是采用的是时间片轮转的抢占式调度方式,每个进程有各自独立的一块内存,使得各个进程之间内存地址相互隔离,
由于 CPU 的执行效率非常高,时间片非常短,在各个任务之间快速地切换,给人的感觉就是多个任务在“同时进行”.
进程与线程
**之间的关系与区别:**进程是资源分配的基本单位。线程是系统调度的基本单位
① 进程 包含 多个线程② 进程间 不共用 变量与资源;线程间 共用 变量与资源
Ⅰ 拥有资源
- 每个进程都有自己的独立内存空间,不同进程通过进程间通信来通信。
- 进程占据独立的内存,所以上下文进程间的切换开销(栈、寄存器、页表、文件句柄等)比较大
进程是资源分配的基本单位,同一个进程内的线程共享这个进程的资源
线程
- 是程序的实际执行者。一个进程至少包含一个主线程,也可以有更多的子线程。
- 多个线程共享所属进程的资源,同时线程也拥有自己的专属资源。
- 程间通信主要通过共享内存,上下文切换很快,资源开销较少,但相比进程不够稳定容易丢失数据。
协程
- 协程的调度完全由用户控制。
- 一个线程可以拥有多个协程,协程不是被操作系统内核所管理,而完全是由程序所控制。
- 与其让操作系统调度,不如我自己来,这就是协程
Ⅱ 调度
线程是独立调度的基本单位,在同一进程中,线程的切换不会引起进程切换,从一个进程中的线程切换到另一个进程中的线程时,会引起进程切换。
Ⅲ 系统开销
进程就是包换上下文切换的程序执行时间总和 = CPU 加载上下文+CPU 执行+CPU 保存上下文 由于创建或撤销进程时,系统都要为之分配或回收资源,如内存空间、I/O 设备等,所付出的开销远大于创建或撤销线程时的开销。类似地,在进行进程切换时,涉及当前执行进程 CPU 环境的保存及新调度进程 CPU 环境的设置,而线程切换时只需保存和设置少量寄存器内容,开销很小。
Ⅳ 通信方面
线程间可以通过直接读写同一进程中的数据进行通信,但是进程通信需要借助 IPC
多线程/多进程解决了阻塞问题
同步与互斥
- 临界区 对临界资源进行访问的那段代码称为临界区。
为了互斥访问临界资源,每个进程在进入临界区之前,需要先进行检查。
HTML
// entry section // critical section; // exit section
- 同步与互斥 同步:多个进程因为合作产生的直接制约关系,使得进程有一定的先后执行关系。 互斥:多个进程在同一时刻只有一个进程能进入临界区。
- 信号量 信号量(Semaphore)是一个整型变量,可以对其执行 down 和 up 操作,也就是常见的 P 和 V 操作。
down : 如果信号量大于 0 ,执行 -1 操作;如果信号量等于 0,进程睡眠,等待信号量大于 0; up :对信号量执行 +1 操作,唤醒睡眠的进程让其完成 down 操作。 down 和 up 操作需要被设计成原语,不可分割,通常的做法是在执行这些操作的时候屏蔽中断。
如果信号量的取值只能为 0 或者 1,那么就成为了 互斥量(Mutex) ,0 表示临界区已经加锁,1 表示临界区解锁。
互斥锁
1 严格轮换法 加入锁变量 2 Peterson 算法 进程 0 出临界区后进程 1 才会离开忙等待
C
typedef int semaphore; semaphore mutex = 1; void P1() { down(&mutex); // 临界区 up(&mutex); }
void P2() { down(&mutex); // 临界区 up(&mutex); } 使用信号量实现生产者-消费者问题
问题描述:使用一个缓冲区来保存物品,只有缓冲区没有满,生产者才可以放入物品;只有缓冲区不为空,消费者才可以拿走物品。
因为缓冲区属于临界资源,因此需要使用一个互斥量 mutex 来控制对缓冲区的互斥访问。
为了同步生产者和消费者的行为,需要记录缓冲区中物品的数量。数量可以使用信号量来进行统计,这里需要使用两个信号量:empty 记录空缓冲区的数量,full 记录满缓冲区的数量。其中,empty 信号量是在生产者进程中使用,当 empty 不为 0 时,生产者才可以放入物品;full 信号量是在消费者进程中使用,当 full 信号量不为 0 时,消费者才可以取走物品。
注意,不能先对缓冲区进行加锁,再测试信号量。也就是说,不能先执行 down(mutex) 再执行 down(empty)。如果这么做了,那么可能会出现这种情况:生产者对缓冲区加锁后,执行 down(empty) 操作,发现 empty = 0,此时生产者睡眠。消费者不能进入临界区,因为生产者对缓冲区加锁了,消费者就无法执行 up(empty) 操作,empty 永远都为 0,导致生产者永远等待下,不会释放锁,消费者因此也会永远等待下去。
进程间通信
图片缺失:C:\Users\Stan\AppData\Roaming\Typora\typora-user-images\image-20220707213314342.png
可选用的 6 种方法
- 管道 管道是通过调用 pipe 函数创建的,fd[0] 用于读,fd[1] 用于写。
- 信号(Signal):信号用于通知目标进程有某种事件发生,除了用于进程间通信外,进 程还可以发送信号给进程自身。信号的典型应用是 kill 命令
- 信号量(Semaphore):PV 操作,信号量用于两个进程之间同步协作手段,它相当于操作系统提 供的一个特殊变量,程序可以在上面进行 wait() 和 notify() 操作。
- 消息队列(Message Queue):以上三种方式只适合传递传递少量信息,POSIX 标准中 定义了消息队列用于进程间数据量较多的通信。进程可以向队列添加消息,被赋予读权 限的进程则可以从队列消费消息。消息队列克服了信号承载信息量少,管道只能用于无 格式字节流以及缓冲区大小受限等缺点,但实时性相对受限。
- 共享内存(Shared Memory):允许多个进程访问同一块公共的内存空间,这是效率最 高的进程间通信形式。原本每个进程的内存地址空间都是相互隔离的,但操作系统提供 了让进程主动创建、映射、分离、控制某一块内存的程序接口。当一块内存被多进程共 享时,各个进程往往会与其它通信机制,譬如信号量结合使用,来达到进程间同步及互 斥的协调操作。
- 套接字接口(Socket):消息队列和共享内存只适合单机多进程间的通信,套接字接口 是更为普适的进程间通信机制,可用于不同机器之间的进程通信。套接字(Socket)起 初是由 UNIX 系统的 BSD 分支开发出来的,现在已经移植到所有主流的操作系统上。出 于效率考虑,当仅限于本机进程间通信时,套接字接口是被优化过的,不会经过网络协 议栈,不需要打包拆包、计算校验和、维护序号和应答等操作,只是简单地将应用层数 据从一个进程拷贝到另一个进程,这种进程间通信方式有个专名的名称:UNIX Domain Socket,又叫做 IPC Socket
只支持半双工通信(单向交替传输); 只能在父子进程或者兄弟进程中使用。3.共享
1)空分复用技术
空分复用技术的原理就是把内存作为高速缓存来使用,只用来保存最频繁使用的部分程序,而把程序的大部分放在磁盘上。这种机制需要快速的映像内存地址,以便把程序生成的地址转换为有关字节在内存中的物理地址。这种映像由 CPU 中的一个部件,称为存储器管理单元(Memory Management Unit,MMU)来完成
2)时分复用技术
多个进程能在同一个 CPU 上并发执行就是因为使用了时分复用技术,让每个进程轮流占用处理器,每次只执行一小个时间片并快速切换。显然,如果失去了并发性,一个时间段内系统中只能运行一道程序,那也就失去了实现虚拟性的意义了。因此,没有并发性,就谈不上虚拟性
异步
阻塞和非阻塞解决了应用层等待数据返回时的状态问题,那系统内核获取到的数据到底如何返回给应用层呢?这里不同类型的操作便体现的是同步和异步的区别。
对于同步型的调用,应用层需要自己去向系统内核问询,如果数据还未读取完毕,那此时读取文件的任务还未完成,应用层根据其阻塞和非阻塞的划分,或挂起或去做其他事情(所以同步和异步并不决定其等待数据返回时的状态);如果数据已经读取完毕,那此时系统内核将数据返回给应用层,应用层即可以用取得的数据做其他相关的事情。
而对于异步型的调用,应用层无需主动向系统内核问询,在系统内核读取完文件数据之后,会主动通知应用层数据已经读取完毕,此时应用层即可以接收系统内核返回过来的数据,再做其他事情。
这便是(脱离阻塞和非阻塞来说之后)同步和异步的区别。也就是说,是否是同步还是异步,关注的是任务完成时消息通知的方式。由调用方盲目主动问询的方式是同步调用,由被调用方主动通知调用方任务已完成的方式是异步调用。
4.异步是指:在多道程序环境下,允许多个程序并发执行,但**由于资源有限,进程的执行不是一贯到底的,这就是进程的异步性。 异步和同步是相对的,同步就是顺序执行,执行完一个再执行下一个,需要等待、协调运行。异步就是彼此独立,在等待某事件的过程中继续做自己的事,不需要等待这一事件完成后再工作。线程就是实现异步的一个方式。异步是让调用方法的主线程不需要同步等待另一线程的完成,从而可以让主线程干其它的事情。
同步的优点是:同步是按照顺序一个一个来,不会乱掉,更不会出现上面代码没有执行完就执行下面的代码, 缺点:是解析的速度没有异步的快;
异步的优点是:异步是接取一个任务,直接给后台,在接下一个任务,一直一直这样,谁的先读取完先执行谁的, 缺点:没有顺序 ,谁先读取完先执行谁的 ,会出现上面的代码还没出来下面的就已经出来了,会报错;
异步是当一个调用请求发送给被调用者,而调用者不用等待其结果的返回而可以做其它的事情。实现异步可以采用多线程技术或则交给另外的进程来处理。
线程是抢占式,而协程是非抢占式的,所以需要用户自己释放使用权来切换到其他协程,因此同一时间其实只有一个协程拥有运行权,相当于单线程的能力。
协程并不是取代线程, 而且抽象于线程之上, 线程是被分割的 CPU 资源, 协程是组织好的代码流程, 协程需要线程来承载运行, 线程是协程的资源, 但协程不会直接使用线程, 协程直接利用的是执行器(Interceptor), 执行器可以关联任意线程或线程池, 可以使当前线程, UI 线程, 或新建新程.。
线程是协程的资源。协程通过 Interceptor 来间接使用线程这个资源。
-
进程管理
虚拟地址转换为物理地址就会变慢,进程切换主要是上下文切换开销太多,进程是资源分配的最小单位,每个进程都有自己的资源。同一个进程的多个线程都是共享这个进程的资源的,所以线程切换要快的多,因为切换的的东西少。
-
内存管理
虚拟内存技术,把内存作为高速缓存来使用,只用来保存最频繁使用的部分程序,而把程序的大部分放在磁盘上。
那么内存管理做的事情大概就是:
把使用频繁的部分程序放入内存 当内存满的时候,替换掉内存中的某些部分
-
文件系统管理
-
I/O 设备管理
内核态和用户态
内核 kernel 是程序,它需要运行,就必须被分配 CPU。因此,CPU 上会运行两种程序,一种是操作系统的内核程序(也称为系统程序),一种是应用程序。前者完成系统任务,后者实现应用任务。两者之间有控制和被控制的关系,前者有权管理和分配资源,而后者只能向系统申请使用资源。
什么是虚拟内存
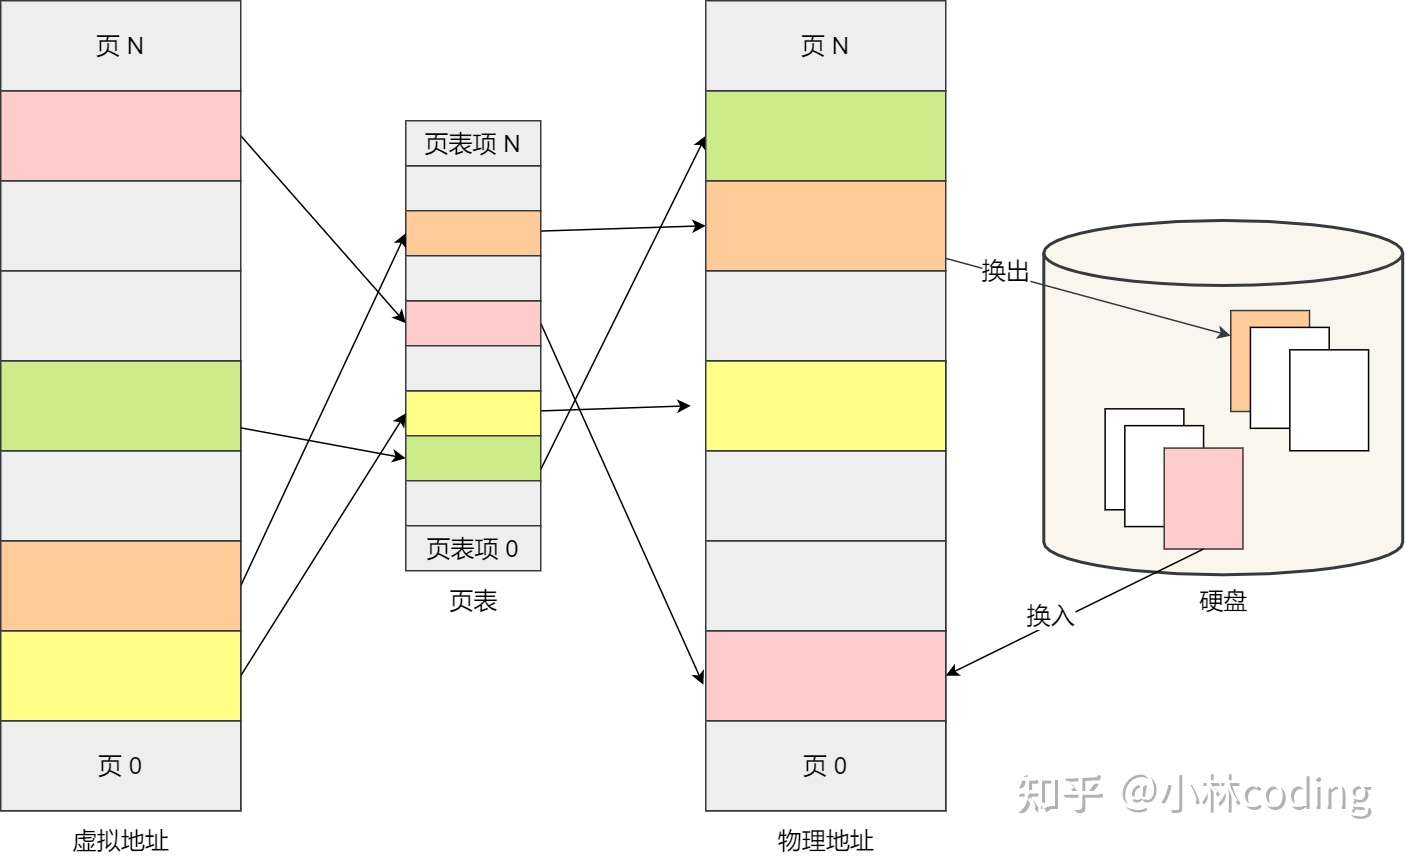
虚拟内存为每个进程提供了一个一致的、私有的地址空间,它让每个进程产生了一种自己在独享主存的错觉(每个进程拥有一片连续完整的内存空间)。这样会更加有效地管理内存并减少出错。操作系统也为每个进程创建巨大、私有的虚拟内存的假象,这种地址空间的抽象让每个程序好像拥有自己的内存,而实际上操作系统在背后秘密地让多个地址空间**「复用」**物理内存或者磁盘。
虚拟内存的目的是为了让物理内存扩充成更大的逻辑内存,从而让程序获得更多的可用内存。虚拟内存的重要意义是它定义了一个连续的虚拟地址空间,并且 把内存扩展到硬盘空间
例如有一台计算机可以产生 16 位地址,那么一个程序的地址空间范围是 0~64K。该计算机只有 32KB 的物理内存,虚拟内存技术允许该计算机运行一个 64K 大小的程序。
32 位系统使用 32 位地址线的最大寻址空间为 2 的 32 次方 bytes,计算后即 4294967296 Bytes,也就是我们常说的 4096MB,32 位地址线的寻址空间封顶即为 4GB
分页系统映射
内存管理单元(MMU)管理着地址空间和物理内存的转换,其中的页表(Page table)存储着页(程序地址空间)和页框(物理内存空间)的映射表。一个虚拟地址分成两个部分,一部分存储页面号,一部分存储偏移量。CPU 上的内存管理单元(Memory Management Unit,MMU)就是专门用来进行虚拟地址到物理地址的转换的,不过 MMU 需要借助存放在内存中的页表,而这张表的内容正是由操作系统进行管理的。
页表是一个十分重要的数据结构!
操作系统为每个进程建立了一张页表。一个进程对应一张页表,进程的每个页面对应一个页表项,每个页表项由页号和块号(页框号)组成,记录着进程页面和实际存放的内存块之间的映射关系。
pointer
指针本质上可以在整个 OS 允许的内存块上任意移动,有时候还会跨界到其他内存块上去。本质上它离机器语言太近,能够造成非常巨大的外延性破坏。一个最经典的例子就是内存践踏造成的缓冲区溢出。
Java 否定了这种自由性。你不能根据你现有的引用移动到内存的其他位置做任何你想做的事情。
C++ 利用 智能指针达成的效果是:一旦某对象不再被引用,系统刻不容缓,立刻回收内存
一个解决空悬指针的办法是,引入一层间接性,让 p1 和 p2 所指的对象永久有 效。比如图 1-2 中的 proxy 对象,这个对象,持有一个指向 Object 的指针。
shared_ptr 是引用计数型智能指针,在 Boost 和 std::tr1 里均提供. 它的引用计数本身是安全且无锁的,但对象的读写则不是,因为 shared_ptr 有两个数据成员,读写操作不能原子化。根据文档 11,shared_ptr 的线 程安全级别和内建类型、标准库容器、std::string 一样,即: • 一个 shared_ptr 对象实体可被多个线程同时读取
软工
- 需求在初始阶段就能够被精心设计。
- 具有容易理解的线性结构。
- 易于管理。
瀑布的缺点
- 既不灵活,又不支持变更。
- 任何阶段一旦出现延迟,都会导致项目无法推进。
- 由于较为死板,因此项目总体时间较长。
- 并不鼓励在初始阶段之后,利益相关者进行积极地沟通。
- Architecture comes in Designing phase and Design Patterns comes in Building phase.
- Architectural pattern is like a blue print and design pattern is actual implementation.
- Architecture is base which everything else adhere to and design pattern is a way to structure classes to solve common problems.
- All Architecture is design pattern but all design pattern can not be architecture. Like MVC can come under both. But singleton design pattern can not be an architecture pattern. MVC, MVVM all come under both.
敏捷软件开发
A build is an executable version of the system.
Integration build plan describes the sequences of build in an iteration
Testing
白盒测试也称为结构测试,主要用于检测软件编码过程中的错误。程序员的编程经验、对编程软件的掌握程度、工作状态等因素都会影响到编程质量,导致代码错误。
黑盒测试又称为功能测试,主要检测软件的每一个功能是否能够正常使用。在测试过程中,将程序看成不能打开的黑盒子,不考虑程序内部结构和特性的基础上通过程序接口进行测试,检查程序功能是否按照设计需求以及说明书的规定能够正常打开使用。
单元测试,需要遵循一下规则:
1、每一个测试方法上使用@Test 进行修饰
2、每一个测试方法必须使用 public void 进行修饰
3、每一个测试方法不能携带参数
4、测试代码和源代码在两个不同的项目路径下
5、测试类的包应该和被测试类保持一致
6、测试单元中的每个方法必须可以独立测试
junit 如何解决这个问题的呢?答案在于内部提供了一个断言机制,他能够将我们预期的结果和实际的结果进行比对,判断出是否满足我们的期望。相信到这,你已经迫不及待的想认识一下 junit,下面我们直接通过案例,来分析一下这个机制。
UML 统一建模语言
是一种为面向对象系统的产品进行说明、可视化和编制文档的一种标准语言,是非专利的第三代建模和规约语言。UML 是面向对象设计的建模工具,独立于任何具体程序设计语言。
windows 中只有“/r/n”才能正确触发“我们理解的换行”操作
设计模式
1. 创建型模式,这些设计模式提供了一种在创建对象的同时隐藏创建逻辑的方式,而不是使用 new 运算符直接实例化对象。这使得程序在判断针对某个给定实例需要创建哪些对象时更加灵活。共五种:工厂方法模式、抽象工厂模式、单例模式、建造者模式、原型模式。
2、 结构型模式,这些设计模式关注类和对象的组合。继承的概念被用来组合接口和定义组合对象获得新功能的方式。共七种:适配器模式、装饰器模式、代理模式、外观模式、桥接模式、组合模式、享元模式。
3、 行为型模式,这些设计模式特别关注对象之间的通信。共十一种:策略模式、模板方法模式、观察者模式、迭代子模式、责任链模式、命令模式、备忘录模式、状态模式、访问者模式、中介者模式、解释器模式。
**简单工厂,工厂方法,[抽象工厂]**都属于设计模式中的创建型模式。其主要功能都是帮助我们把对象的实例化部分抽取了出来,优化了系统的架构,并且增强了系统的扩展性。
★工厂模式中,重要的是工厂类,而不是产品类。产品类可以是多种形式,多层继承或者是单个类都是可以的。但要明确的,工厂模式的接口只会返回一种类型的实例,这是在设计产品类的时候需要注意的,最好是有父类或者共同实现的接口。
★使用工厂模式,返回的实例一定是工厂创建的,而不是从其他对象中获取的。
★工厂模式返回的实例可以不是新创建的,返回由工厂创建好的实例也是可以的。
发现简单工厂模式存在一系列问题:
- 工厂类集中了所有实例(产品)的创建逻辑,一旦这个工厂不能正常工作,整个系统都会受到影响;
- 违背“开放 - 关闭原则”,一旦添加新产品就不得不修改工厂类的逻辑,这样就会造成工厂逻辑过于复杂。
- 简单工厂模式由于使用了静态工厂方法,静态方法不能被继承和重写,会造成工厂角色无法形成基于继承的等级结构。
为了解决上述的问题,我们又使用了一种新的设计模式:工厂方法模式。工厂方法模式可以说是简单工厂模式的进一步抽象和拓展,在保留了简单工厂的封装优点的同时,让扩展变得简单,让继承变得可行,增加了多态性的体现。
区别
简单工厂 : 用来生产同一等级结构中的任意产品。一台咖啡机就可以理解为一个工厂模式,你只需要按下想喝的咖啡品类的按钮(摩卡或拿铁),它就会给你生产一杯相应的咖啡,你不需要管它内部的具体实现,只要告诉它你的需求即可。(对于增加新的产品,无能为力)
工厂方法 :用来生产同一等级结构中的固定产品。(支持增加任意产品)抽象工厂 :用来生产不同产品族的全部产品。(对于增加新的产品,无能为力;支持增加产品族)
不想喝咖啡了想喝啤酒,这个时候如果直接修改简单工厂里面的代码,这种做法不但不够优雅,也不符合软件设计的“开闭原则”,这时直接继承抽象 class override 方法
图片缺失:C:\Users\Stan\AppData\Roaming\Typora\typora-user-images\image-20220616151817765.png
单例模式(Singleton Pattern)是 Java 中最简单的设计模式之一,提供了一种创建对象的最佳方式。这种模式涉及到一个单一的类,该类负责创建自己的对象,同时确保只有单个对象被创建。这个类提供了一种访问其唯一的对象的方式,可以直接访问,不需要实例化该类的对象。
- 1、单例类只能有一个实例。
- 2、单例类必须自己创建自己的唯一实例。
- 3、单例类必须给所有其他对象提供这一实例。
优点:
- 1、在内存里只有一个实例,减少了内存的开销,尤其是频繁的创建和销毁实例(比如管理学院首页页面缓存)。
- 2、避免对资源的多重占用(比如写文件操作)。
**缺点:**没有接口,不能继承,与单一职责原则冲突,一个类应该只关心内部逻辑,而不关心外面怎么样来实例化。
使用场景:
- 1、要求生产唯一序列号。
- 2、WEB 中的计数器,不用每次刷新都在数据库里加一次,用单例先缓存起来。
- 3、创建的一个对象需要消耗的资源过多,比如 I/O 与数据库的连接等。
**注意事项:**getInstance() 方法中需要使用同步锁 synchronized (Singleton.class) 防止多线程同时进入造成 instance 被多次实例化。
建议使用第 3 种饿汉方式。只有在要明确实现 lazy loading 效果时,才会使用第 5 种登记方式。如果涉及到反序列化创建对象时,可以尝试使用第 6 种枚举方式。
创建者模式
Builder pattern 主要解决在软件系统中,有时候面临着“一个复杂对象”的创建工作,其通常由各个部分的子对象用一定的算法构成;由于需求的变化,这个复杂对象的各个部分经常面临着剧烈的变化,但是将它们组合在一起的算法却相对稳定。
1、去肯德基,汉堡、可乐、薯条、炸鸡翅等是不变的,而其组合是经常变化的,生成出所谓的“套餐”。 2、JAVA 中的 StringBuilder。
**原型模式(Prototype Pattern)**是用于创建重复的对象,同时又能保证性能。这种类型的设计模式属于创建型模式,它提供了一种创建对象的最佳方式。
这种模式是实现了一个原型接口,该接口用于创建当前对象的克隆。当直接创建对象的代价比较大时,则采用这种模式。例如,一个对象需要在一个高代价的数据库操作之后被创建。我们可以缓存该对象,在下一个请求时返回它的克隆,在需要的时候更新数据库,以此来减少数据库调用。
java 中的深浅拷贝,需要拷贝的原型类 需要实现Cloneable接口,然后重写其中的clone方法,才可以实现类的拷贝。
适配器模式(Adapter Pattern)是作为两个不兼容的接口之间的桥梁。这种类型的设计模式属于结构型模式,它结合了两个独立接口的功能。这种模式涉及到一个单一的类,该类负责加入独立的或不兼容的接口功能
装饰器模式(Decorator Pattern)允许向一个现有的对象添加新的功能,同时又不改变其结构。这种类型的设计模式属于结构型模式,它是作为现有的类的一个包装。
这种模式创建了一个装饰类,用来包装原有的类,并在保持类方法签名完整性的前提下,提供了额外的功能。我们通过下面的实例来演示装饰器模式的用法。其中,我们将把一个形状装饰上不同的颜色,同时又不改变形状类。
观察者模式
当对象间存在一对多关系时,则使用观察者模式(Observer Pattern)。比如,当一个对象被修改时,则会自动通知依赖它的对象。观察者模式属于行为型模式。
注意事项: 1、JAVA 中已经有了对观察者模式的支持类。 2、避免循环引用。 3、如果顺序执行,某一观察者错误会导致系统卡壳,一般采用异步方式。
实现观察者模式使用三个类 Subject、Observer 和 Client。Subject 对象带有绑定观察者到 Client 对象和从 Client 对象解绑观察者的方法。我们创建 Subject 类、Observer 抽象类和扩展了抽象类 Observer 的实体类。
享元模式(Flyweight Pattern)主要用于减少创建对象的数量,以减少内存占用和提高性能。这种类型的设计模式属于结构型模式,它提供了减少对象数量从而改善应用所需的对象结构的方式。
享元模式尝试重用现有的同类对象,如果未找到匹配的对象,则创建新对象。
SOLID 原则
SRP 单一责任原则 OCP 开放封闭原则 LSP 里氏替换原则 ISP 接口隔离原则 DIP 依赖倒置原则
单一责任原则 指的是一个类或者一个方法只做一件事。如果一个类承担的职责过多,就等于把这些职责耦合在一起,一个职责的变化就 可能抑制或者削弱这个类完成其他职责的能力。例如餐厅服务员负责把订单给厨师去做,而不是服务员又要订单又要炒菜。
开放封闭原则
对扩展开放,对修改关闭。意为一个类独立之后就不应该去修改它,而是以扩展的方式适应新需求。例如一开始做了普通 计算器程序,突然添加新需求,要再做一个程序员计算器,这时不应该修改普通计算器内部,应该使用面向接口编程, 组合实现扩展。
https://juejin.cn/post/6844903606563373069
要从集合中选出红苹果,我们会这样public static List<Apple> filterApplesByColor(List<Apple> inventory, String color) { List<Apple> result = new ArrayList<Apple>(); for (Apple apple : inventory) { if (apple.getColor().equals(color)) { result.add(apple); } } return result; }然后传入颜色参数来筛选List<Apple> apples = filterApplesByColor(inventory, "red");但是,如果现在要选出重量超过150g的苹果呢?在方法参数列表中多加一个weight么?你会发现我们所有的代码,只有if判断中的条件发生了变化,这违反了DRY原则(Don’t Repeat Yourself)。所以,我们把整个具体行为作为参数来传递,这样,方法体本身的代码就可以复用了。 // 定义一个接口 public interface ApplePredicate { boolean test(Apple apple); } public class AppleHeavyWeightPredicate implements ApplePredicate { public boolean test(Apple apple) { return apple.getWeight() > 150; } } public class AppleGreenColorPredicate implements ApplePredicate { public boolean test(Apple apple) { return "green".equals(apple.getColor()); } }现在我们可以灵活调用了List<Apple> redAndHeavyApples = filterApples(inventory, new AppleHeavyWeightPredicate());v5.lambda List<Apple> result = filterApples(inventory, (Apple apple) -> "red".equals(apple.getColor()));★函数模块遵循 OCP,基本手段(或主要体现)为设计出通用性的函数。
为什么要将行为作为参数 Parameterization
用户需求的频繁更改发生在方方面面,程序员常常面对“某种”这个字眼所标志的变化,即“某种”是对各种各样变化的抽象。实验 4 的需求变化,发生在函数级别,当要输出 0-x 之间符合“某种”条件的数时,程序员需要在不修改他的源代码的前提下,设计一个函数 filter,能够一次性地应对各种可能的条件。换句话说,程序员需要设计一个在各种情况下都能够使用的、具有一般性/通用性的函数。
Liskov Substitution Principle
If S is a declared subtype of T, objects of type S should behave as objects of type T are expected to behave, if they are treated as objects of type T
从字面上翻译:如果 S 是 T 的子类型,对于 S 类型的任意对象,如果将他们看作是 T 类型的对象,则对象的行为也理应与期望的行为一致。而另一种关于里氏替换原则的描述为 Robert Martin 在《敏捷软件开发:原则、模式与实践》:
子类型(subtype)必须能够替换掉他们的基类型(base type)。
所有基类出现的地方都可以用派生类替换而不会程序产生错误。任何基类可以出现的地方,子类一定可以出现。 LSP 是继承复用的基石,只有当衍生类可以替换掉基类,软件单位的功能不受到影响时,基类才能真正被复用,而衍生类也能够在基类的基础上增加新的行为。里氏代换原则是对“开-闭”原则的补充。实现“开-闭”原则的关键步骤就是抽象化。而基类与子类的继承关系就是抽象化的具体实现,所以里氏代换原则是对实现抽象化的具体步骤的规范。
不符合 LSP 的最常见的情况是,父类和子类都是可实例化的非抽象类,且父类的方法被子类重新定义,这一类的实现继承会造成父类和子类间的强耦合,也就是实际上并不相关的属性和方法牵强附会在一起,不利于程序扩展和维护。
如何符合 LSP 总结一句话 —— 就是尽量不要从可实例化的父类中继承,而是要使用基于抽象类和接口的继承。
接口隔离原则 类不应该依赖不需要的接口,知道越少越好。例如电话接口只约束接电话和挂电话,不需要让依赖者知道还有通讯录。
依赖倒置原则 指的是高级模块不应该依赖低级模块,而是依赖抽象。抽象不能依赖细节,细节要依赖抽象。比如类 A 内有类 B 对象,称为类 A 依赖类 B,但是不应该这样做,而是选择类 A 去依赖抽象。例如垃圾收集器不管垃圾是什么类型,要是垃圾就行。
迪米特法则(law of demeter,LoD)也成为最少知识原则(least knowledge principle),虽然名字不同,但描述的是同一个规则:一个对象应该对其他对象有最少的了解。通俗地讲,一个类应该对自己需要耦合或调用的类知道得最少 低耦合
leetcode
位运算
图片缺失:C:\Users\Stan\AppData\Roaming\Typora\typora-user-images\image-20220701114330836.png
image-20220701114330836
二分查找细节https://leetcode.cn/problems/binary-search/solution/er-fen-cha-zhao-xiang-jie-by-labuladong/
while 中是 < 还是 <=?
答:left==right 时是否需要终止循环,是否找到
int right = nums.size(); // 定义target在左闭右开的区间里,即:[left, right) while (left < right) { // 因为left == right的时候,在[left, right)是无效的空间,所以使用 <int binary_search(int[] nums, int target) { int left = 0, right = nums.length - 1; while(left <= right) { int mid = left + (right - left) / 2; if (nums[mid] < target) { left = mid + 1; } else if (nums[mid] > target) { right = mid - 1; } else if(nums[mid] == target) { // 直接返回 return mid; } } // 直接返回 return -1;}int left_bound(int[] nums, int target) { int left = 0, right = nums.length - 1; while (left <= right) { int mid = left + (right - left) / 2; if (nums[mid] < target) { left = mid + 1; } else if (nums[mid] > target) { right = mid - 1; } else if (nums[mid] == target) { // 别返回,锁定左侧边界 right = mid - 1; } } // 最后要检查 left 越界的情况 if (left >= nums.length || nums[left] != target) return -1; return left;}
int right_bound(int[] nums, int target) { int left = 0, right = nums.length - 1; while (left <= right) { int mid = left + (right - left) / 2; if (nums[mid] < target) { left = mid + 1; } else if (nums[mid] > target) { right = mid - 1; } else if (nums[mid] == target) { // 别返回,锁定右侧边界 left = mid + 1; } } // 最后要检查 right 越界的情况 if (right < 0 || nums[right] != target) return -1; return right;}树和二叉树
遍历
图片缺失:C:\Users\Stan\AppData\Roaming\Typora\typora-user-images\image-20220706235303353.png
BST 二叉查找树(排序树),若它的左子树不空,则左子树上所有的结点的值均不大于它根结点的值; 若它的左子树不空,则左子树上所有的结点的值均不小于它根结点的值;
最重要的性质是:二叉搜索树的中序遍历是有序的
以递归解决二叉树这种对称数据结构的策略,称为对称性递归。可以用**对称性递归解决的二叉树问题大多是判断性问题(bool 类型函数),**这一类问题又可以分为以下两类:https://leetcode.cn/problems/shu-de-zi-jie-gou-lcof/solution/yi-pian-wen-zhang-dai-ni-chi-tou-dui-che-uhgs/ 1、不需要构造辅助函数。这一类题目有两种情况:第一种是单树问题,且不需要用到子树的某一部分(比如根节点左子树的右子树),只要利用根节点左右子树的对称性即可进行递归。第二种是双树问题,即本身题目要求比较两棵树,那么不需要构造新函数。该类型题目如下:
- 相同的树 翻转二叉树
- 二叉树的最大深度
- 平衡二叉树
- 二叉树的直径
- 合并二叉树 另一个树的子树 单值二叉树
2、需要构造辅助函数。这类题目通常只用根节点子树对称性无法完全解决问题,必须要用到子树的某一部分进行递归,即要调用辅助函数比较两个部分子树。形式上主函数参数列表只有一个根节点,辅助函数参数列表有两个节点。该类型题目如下:
- 对称二叉树 剑指 Offer 26. 树的子结构
100. 相同的树,并注意与这道题的区别:剑指 Offer 26. 树的子结构。与字符串对比的话,子树就相当于字符串的子串(要求连续),树的子结构就相当于字符串的子序列(不要求连续)
为什么还需要非线性结构呢? 答案是为了高效地兼顾静态操作和动态操作,我们一般使用树去管理需要大量动态操作的数据
垂直遍历 leetcode.314
   3  /\ /  \ 9  20    /\   /  \  15   7  输入: {3,9,20,#,#,15,7}输出: [[9],[3,15],[20],[7]]public List<List<Integer>> verticalOrder(TreeNode root) {        // Write your code here        List<List<Integer>> results = new ArrayList<>();        if (root == null) {            return results;        }        Map<Integer, List<Integer>> map = new TreeMap<Integer, List<Integer>>();        Queue<Integer> qCol = new LinkedList<>();        Queue<TreeNode> queue = new LinkedList<>();        queue.offer(root);        qCol.offer(0);
        while(!queue.isEmpty()) {            TreeNode curr = queue.poll();            int col = qCol.poll();            if(!map.containsKey(col)) {                map.put(col, new ArrayList<Integer>(Arrays.asList(curr.val)));            } else {                map.get(col).add(curr.val);            }            if(curr.left != null) {                queue.offer(curr.left);                qCol.offer(col - 1);            }            if(curr.right != null) {                queue.offer(curr.right);                qCol.offer(col + 1);            }        }        for(int n : map.keySet()) {            results.add(map.get(n));        }        return results;    }
前缀和构造多叉树
Trie(发音类似 “try”)或者说 前缀树 字典树是一种树形数据结构,用于高效地存储和检索字符串数据集中的键。这一数据结构有相当多的应用情景,例如自动补完和拼写检查。
前缀和是一种重要的预处理,能大大降低查询的时间复杂度。我们可以简单理解为“数列的前 n 项的和”。这个概念其实很容易理解,即一个数组中,第 n 位存储的是数组前 n 个数字的和。
通过一个例子来进行说明会更清晰。题目描述:有一个长度为 N 的整数数组 A,要求返回一个新的数组 B,其中 B 的第 i 个数 B[i]是原数组 A 前 i 项和。
这道题实际就是让你求数组 A 的前缀和。对 [1,2,3,4,5,6] 来说,其前缀和可以是 pre=[1,3,6,10,15,21]。我们可以使用公式 pre[𝑖]=pre[𝑖−1]+nums[𝑖]得到每一位前缀和的值,从而通过前缀和进行相应的计算和解题。其实前缀和的概念很简单,但困难的是如何在题目中使用前缀和以及如何使用前缀和的关系来进行解题。实际的题目更多不是直接让你求前缀和,而是你需要自己使用前缀和来优化算法的某一个性能瓶颈。
平方根
法一:牛顿迭代法的本质是借助泰勒级数,从初始值开始快速向零点逼近。
图片缺失:C:\Users\Stan\AppData\Roaming\Typora\typora-user-images\image-20220724173218842.png
图片缺失:C:\Users\Stan\AppData\Roaming\Typora\typora-user-images\image-20220724165016023.png
为了练习函数与循环,我们来实现一个平方根函数:用牛顿法实现平方根函数。
计算机通常使用循环来计算 x 的平方根。从某个猜测的值 z 开始,我们可以根据 z² 与 x 的近似度来调整 z,产生一个更好的猜测:
z -= (z*z - x) / (2*z) long c=x; while(c*c>x){ c = (c+x/c)/2;//怎么得出来的? } return (int)c;法二:二分查找逼近
滑动窗口
:寻找满足 xx 最长子串/子数组/子序列
图片缺失:C:\Users\Stan\AppData\Roaming\Typora\typora-user-images\image-20220414224407802.png
1.当不满足条件时,拓展右边界,当满足条件时,缩短左边界,最后得到一个解并暂存 2.循环第一步,又得到一个解,将其与第一个解相对比,得到最优解并暂存,以此类推。
图片缺失:C:\Users\Stan\AppData\Roaming\Typora\typora-user-images\image-20220414224625379.png
图片缺失:C:\Users\Stan\AppData\Roaming\Typora\typora-user-images\image-20220414230254357.png
在数学中,数根(又称位数根或数字根 Digital root)是自然数的一种性质,换句话说,每个自然数都有一个数根。
数根是将一正整数的各个位数相加(即横向相加),若加完后的值大于 10 的话,则继续将各位数进行横向相加直到其值小于十为止[1],或是,将一数字重复做数字和,直到其值小于十为止,则所得的值为该数的数根。
例如 54817 的数根为 7,因为 5+4+8+1+7=25,25 大于 10 则再加一次,2+5=7,7 小于十,则 7 为 54817 的数根。
然后是它的用途。
数根可以计算模运算的同余,对于非常大的数字的情况下可以节省很多时间。
数字根可作为一种检验计算正确性的方法。例如,两数字的和的数根等于两数字分别的数根的和。
另外,数根也可以用来判断数字的整除性,如果数根能被 3 或 9 整除,则原来的数也能被 3 或 9 整除。
347. 前 K 个高频元素
对于 topk 问题:最大堆求 topk 小,最小堆求 topk 大。
topk 小:构建一个 k 个数的最大堆,当读取的数小于根节点时,替换根节点,重新塑造最大堆 topk 大:构建一个 k 个数的最小堆,当读取的数大于根节点时,替换根节点,重新塑造最小堆 eg. leetcode 215
借助 哈希表 来建立数字和其出现次数的映射,遍历一遍数组统计元素的频率 维护一个元素数目为 kk 的最小堆 why?
每次都将新的元素与堆顶元素(堆中频率最小的元素)进行比较 如果新的元素的频率比堆顶端的元素大,则弹出堆顶端的元素,将新的元素添加进堆中 最终,堆中的 kk 个元素即为前 kk 个高频元素
是使用小顶堆呢,还是大顶堆?
有的同学一想,题目要求前 K 个高频元素,那么果断用大顶堆啊。
那么问题来了,定义一个大小为 k 的大顶堆,在每次移动更新大顶堆的时候,每次弹出都把最大的元素弹出去了,那么怎么保留下来前 K 个高频元素呢。
所以我们要用小顶堆,因为要统计最大前 k 个元素,只有小顶堆每次将最小的元素弹出,最后小顶堆里积累的才是前 k 个最大元素。
三路快排 当序列中有大量的重复元素,二路排序虽然会均衡的分配到两个序列中,但是重复元素仍然参与到分割序列中,带来无谓的性能损耗。
     public void sort(int[] args, int l, int r) {        if (l >= r) {            return;        }    int target = args[l];    int lt = l, gt = r + 1, i = l + 1;    while (i < gt) {        if (args[i] < target) {            swap(args, i, lt + 1);            lt++;            i++;        } else if (args[i] > target) {            swap(args, i, gt - 1);            gt--;        } else {            i++;        }    }    swap(args, l, lt);
    sort(args, l, lt - 1);    sort(args, gt, r);    }//快速选择算法public int findKthLargest(int[] nums, int k) {        int left = 0;        int right = nums.length - 1;        int pivot = partition(nums, left, right);        // 从小到大排序,倒数第k个就是第k个最大元素        int targetIndex = nums.length - k;
        while (true) {            if (pivot == targetIndex) {                return nums[pivot];            } else if (pivot > targetIndex) {                right = pivot - 1;            } else {                left = pivot + 1;            }            pivot = partition(nums, left, right);        }    }
    int partition(int[] nums, int left, int right) {        // 基准值索引        int pivot = left;        // 预放值索引        int index = left + 1;        // 将比基准值小的都紧挨着基准值        for (int i = index; i <= right; i++) {            if (nums[i] < nums[pivot]) {                swap(nums, i, index);                index++;            }        }        // 把基准值移动到比基准值小的数列的最右边        swap(nums, pivot, index - 1);        return index - 1;    }
快速选择算法过一次遍历,确定某一个元素在排序以后的位置,这个算法叫「快速选择」。要理解「快速选择」算法,必须先理解「快速排序」的「partition」。 快速排序会递归处理划分的两边,而选择只处理划分一边。
LRUcache
伪头部(dummy head)和伪尾部(dummy tail)标记界限,这样在添加节点和删除节点的时候就不需要检查相邻的节点是否存在。
复杂度
“
”(Reduction)在计算复杂度理论中是一个非常重要的概念。
-Complete 等复杂度类的定义就离不开这个概念。
“多一归约”(Many-one reduction,下文统一采用此英文名,因为中文名不太常用也不太常见),这是数学家 Emil Post 在 1944 年提出来的概念。其是以函数形式定义的:对于问题 和问题 ,如果存在一个可以计算的函数 ,使得对于任意问题 的实例 ,都有
WEB 开发
Restful 规范
REST:REpresentational State Transfer 直接翻译:表现层状态转移
REST 实际上是对“HTTP”(Hypertext Transfer)的进一步抽象,两者就如同接口与实现类的关系一般。
转移(Transfer):无论状态是由服务端还是客户端来提供的,“取下一篇文章”这个行为逻辑必然只能由服务端来提供,因为只有服务端拥有该资源及其表征形式。服务器通过某种方式,把“用户当前阅读的文章”转变成“下一篇文章”,这就被称为“表征状态转移”
URL定位资源,用 HTTP描述操作。
看 Url 就知道要什么 看 http method 就知道干什么 看 http status code 就知道结果如何
为什么要用 RESTful 结构呢?
大家都知道“古代”网页是前端后端融在一起的,比如之前的 PHP,JSP 等。在之前的桌面时代问题不大,但是近年来移动互联网的发展,各种类型的 Client 层出不穷,RESTful 可以通过一套统一的接口为 Web,iOS 和 Android 提供服务。另外对于广大平台来说,比如 Facebook platform,微博开放平台,微信公共平台等,它们不需要有显式的前端,只需要一套提供服务的接口
6 大原则
1)客户端 - 服务器 - 通过将用户接口问题与数据存储问题分开,我们通过简化服务器组件来提高跨多个平台的用户接口的可移植性并提高可伸缩性。
2)无状态 - 从客户端到服务器的每个请求都必须包含理解请求所需的所有信息,并且不能利用服务器上任何存储的上下文。因此,会话状态完全保留在客户端上。无状态是 REST 的一条核心原则,部分开发者在做服务接口规划时,觉得 REST 风格的服务怎么设计都感觉别扭,很有可能的一种原因是在服务端持有着比较重的状态。REST 希望服务器不要去负责维护状态,每一次从客户端发送的请求中,应包括所有的必要的上下文信息,会话信息也由客户端负责保存维护,服务端依据客户端传递的状态来执行业 务处理逻辑,驱动整个应用的状态变迁。客户端承担状态维护职责以后,会产生一些新 的问题,譬如身份认证、授权等可信问题,它们都应有针对性的解决方案(这部分内容 可参见“安全架构”的内容)。 但必须承认的现状是,目前大多数的系统都达不到这个要求,往往越复杂、越大型的系统越是如此。服务端无状态可以在分布式计算中获得非常高价值的好处,但大型系统的上下文状态数量完全可能膨胀到让客户端在每次请求时提供变得不切实际的程度,在服务端的内存、会话、数据库或者缓存等地方持有一定的状态成为一种是事实上存在,并将长期存在、被广泛使用的主流的方案。
3)可缓存 - 缓存约束要求将对请求的响应中的数据隐式或显式标记为可缓存或不可缓存。如果响应是可缓存的,则客户端缓存有权重用该响应数据以用于以后的等效请求。
4)统一接口 - 通过将通用性的软件工程原理应用于组件接口,简化了整个系统架构,提高了交互的可见性。为了获得统一的接口,需要多个架构约束来指导组件的行为。REST 由四个接口约束定义: 资源识别;
通过陈述来处理资源;
自我描述性的信息; 并且,超媒体作为应用程序状态的引擎。
5)分层系统 - 分层系统风格允许通过约束组件行为来使体系结构由分层层组成,这样每个组件都不能“看到”超出与它们交互的直接层。
6)按需编码(可选) - REST 允许通过以小程序或脚本的形式下载和执行代码来扩展客户端功能。这通过减少预先实现所需的功能数量来简化客户端。
问题
面向资源的编程思想只适合做 CRUD
抽象资源。所谓的抽象资源是“不直接对应数据库表的资源”。比如“登录/登出”。如果你用 RPC 式的接口设计,这就很直接:POST /login 和 POST /logout。但是你要硬套 RESTful,你就得挖空心思的想出一个抽象资源“会话”(session)。登录 = 创建会话,登出 = 销毁会话。于是你把接口设计成 POST /sessions 和 DELETE /sessions。这就很反直觉,且背离 RESTful 的设计初衷。
元数据如何返回也是个问题。比如分页查询是很常见的需求。但是当前是第几页,一共多少条记录等,这些元数据放在响应的哪儿呢?如果放在 body 里,有点不 REST,因为 REST 的响应应该只包含数据;如果放在 header 里,则又要和客户端商定协议细节,客户端实现也变得更困难。
REST 与 HTTP 完全绑定,不适合应用于要求高性能传输的场景中
对于需要直接控制传输,如二 进制细节、编码形式、报文格式、连接方式等细节的场景中,REST 确实不合适,这些场 景往往存在于服务集群的内部节点之间,这也是之前曾提及的,REST 和 RPC 尽管应用 场景的确有所重合,但重合的范围有多大就是见仁见智的事情。 RESTful 和 HTTP 绑的太死,很难用在其他传输协议里,比如你很难把 REST 用在 Redis PubSub 里。相比之下,一个包含指令和数据的 RPC 包通过 HTTP 发还是通过 Kafka 发都没问题
REST 不利于事务支持
REST 没有传输可靠性支持 是的,并没有。在 HTTP 中你发送出去一个请求,通常会收到一个与之相对的响应,譬 如 HTTP/1.1 200 OK 或者 HTTP/1.1 404 Not Found 诸如此类的。但如果你没有收到任 何响应,那就无法确定消息到底是没有发送出去,抑或是没有从服务端返回回来,这其 中的关键差别是服务端到底是否被触发了某些处理?应对传输可靠性最简单粗暴的做法 是把消息再重发一遍。这种简单处理能够成立的前提是服务应具有幂等性
Features
1、每一个 URI 代表 1 种资源;
2、客户端使用 GET、POST、PUT、DELETE4 个表示操作方式的动词对服务端资源进行操作:GET 用来获取资源,POST 用来新建资源(也可以用于更新资源),PUT 用来更新资源,DELETE 用来删除资源;
3、通过操作资源的表现形式来操作资源;
4、资源的表现形式是 XML 或者 HTML;<xsl:sort order="descending" />
5、客户端与服务端之间的交互在请求之间是无状态的,从客户端到服务端的每个请求都必须包含理解请求所必需的信息。
在 Spring 构建 RESTful Web 服务的方法中,HTTP 请求由控制器处理。这些组件由 @RestController 注释标识,下面清单中显示的 GreetingController(来自 src/main/java/com/example/restservice/GreetingController.java)通过返回 Greeting 的新实例来处理 /greeting 的 GET 请求班级:
@RestControllerpublic class TestController { @Autowired(required = false) DogMapper dogMapper; @GetMapping("dogs") public List<Dog> getDogs() { return dogMapper.getAllDog(); }缺点
- 比如操作方式繁琐,RESTful API 通常根据 GET、POST、PUT、DELETE 来区分操作资源的动作,而 HTTP Method 本身不可直接见,是隐藏的,而如果将动作放到 URL 的 path 上反而清晰可见,更利于团队的理解和交流。
- 并且有些浏览器对 GET,POST 之外的请求支持不太友好,还需要特殊额外的处理。
- 过分强调资源,而实际业务 API 可能有各种需求比较复杂,单单使用资源的增删改查可能并不能有效满足使用需求,强行使用 RESTful 风格 API 只会增加开发难度和成本。
springboot
Spring 是分层的企业级应用轻量级开源框架,以 IoC 和 AOP 为内核。
- 用来简化 Spring 应用的初始搭建以及开发过程,使用特定的方式来进行配置
- 创建独立的 Spring 引用程序 main 方法运行
- 嵌入的tomcat无需部署 war 文件
- 简化 maven 配置
- 自动配置 Spring 添加对应的功能 starter 自动化配置
IoC控制反转,就是把原先我们代码里面需要实现的对象创建、依赖的代码,反转给容器来帮忙实现。当应用了 IoC,一个对象依赖的其它对象会通过被动的方式传递进来,而不是这个对象自己创建或者查找依赖对象。IoC 的实现方式有依赖注入和依赖查找,由于依赖查找使用的很少,因此 IoC 也叫做依赖注入。依赖注入指对象被动地接受依赖类而不用自己主动去找,对象不是从容器中查找它依赖的类,而是在容器实例化对象时主动将它依赖的类注入给它。假设一个 Car 类需要一个 Engine 的对象,那么一般需要需要手动 new 一个 Engine,利用 IoC 就只需要定义一个私有的 Engine 类型的成员变量,容器会在运行时自动创建一个 Engine 的实例对象并将引用自动注入给成员变量。
AOP 即面向切面编程,简单地说就是将代码中重复的部分抽取出来,在需要执行的时候使用动态代理的技术,在不修改源码的基础上对方法进行增强。优点是可以减少代码的冗余,提高开发效率,维护方便。常用场景包括权限认证、自动缓存、错误处理、日志、调试和事务等。
相关注解
@Aspect:声明被注解的类是一个切面 Bean。
@Before:前置通知,指在某个连接点之前执行的通知。
@After:后置通知,指某个连接点退出时执行的通知(不论正常返回还是异常退出)。
Spring MVC 核心组件
DispatcherServlet:SpringMVC 中的前端控制器,是整个流程控制的核心,负责接收请求并转发给对应的处理组件。控制器,是整个流程控制的核心,负责接收请求并转发给对应的处理组件。
Handler:处理器,完成具体业务逻辑,相当于 Servlet 或 Action。
HandlerMapping:完成 URL 到 Controller 映射的组件,DispatcherServlet 接收到请求之后,通过 HandlerMapping 将不同的请求映射到不同的 Handler。
Mybatis 是一个实现了数据持久化的 ORM 框架,简单理解就是对 JDBC 进行了封装。
ORM 全称是:Object Relational Mapping(对象关系映射](https://www.zhihu.com/search?q=对象关系映射&search_source=Entity&hybrid_search_source=Entity&hybrid_search_extra={“sourceType”%3A“article”%2C“sourceId”%3A“27188788”})),其主要作用是在编程中,把面向对象的概念跟数据库中表的概念对应起来。举例来说就是,我定义一个对象,那就对应着一张表,这个对象的实例,就对应着表中的一条记录。
Spring 启动时读取应用程序提供的 Bean 配置信息,并在 Spring 容器中生成一份相应的 Bean 配置注册表,然后根据这张注册表实例化 Bean,装配好 Bean 之间的依赖关系,为上层应用提供准备就绪的运行环境。
Database
NoSQL 指非关系型数据库,与关系型数据库存在显著差异。其中最重要之处在于 NoSQL 数据库不适用 SQL 语言。其数据存储不需要固定的表格模式,一般都有水平可扩展性。NoSQL 数据库分为以下几类:
①Key/Value 键值存储。这种数据存储通常都无数据结构,被当作字符串或者二进制数据,但是数据加载快,典型应用于高并发和日志系统场景。如 Redis。
②列存储数据库。列存储数据库功能相对局限,但是查找速度快,易分布式扩展。一般用于分布式文件系统。如 Hbase、Cassandra
③文档型数据库。和键值对数据库类似,也没有严格数据格式。不需要预先创建表结构,数据格式更加灵活,一般用户 Web 应用。如 MongoDB。
④图形数据库。图形数据库专注于构建关系图谱,如社交网络、推荐系统等等。这类网络有 Neo4j、DEX。
NoSQL 种类繁多,Spring Boot 支持绝大多数。我们主要介绍常见的 Redis 和 MongoDB。
DBMS: XML,file system
集群原理
在 Redis 集群中,所有 Redis 节点彼此互联,节点内部使用二进制协议优化传输速度和带宽。当一个节点宕机后,集群中超过半数节点检测失效才认为该节点失效。不同于 Tomcat 集群需要反向代理服务器,Redis 集群中任意节点都可以直接和 Java 客户端连接。Redis 集群上的数据分配采用哈希槽。Redis 集群中内置了 16384 个哈希槽,当有数据要存储时,Redis 会首先使用 CRC16 算法对 key 进行计算,将计算结果对 16384 取余,这样每个 key 都会对应一个取值在 16384 之间的哈希槽。开发者可根据每个 Redis 实例性能来调整每个 Redis 实例上哈希槽的分布范围。
负载均衡
是防止有的人干死了,有的人闲死了,来根据能力(CPU、IO)分配一下工作量
现有的负载均衡算法主要分为静态和动态两类。静态负载均衡算法以固定的概率分配任务,不考虑服务器的状态信息,如轮转算法、加权轮转算法等;动态负载均衡算法以服务器的实时负载状态信息来决定任务的分配,如最小连接法
常用的负载均衡策略
1.轮训
2.随机
3.加权
4.最小响应时间
5.最小并发数
Nginx 是一个高性能的 http 和反向代理服务器。反向代理是负载均衡的实现方式之一 这个问题描述是性能,只能代理到多个节点,代理单一节点对性能提升明显是没意义的。或者如某个回答说的,应该是提升吞吐量,性能的描述不是很准确。
反向代理隐藏了真实的服务端,当我们请求 www.baidu.com 的时候,就像拨打 10086 一样,背后可能有成千上万台服务器为我们服务,但具体是哪一台,你不知道,也不需要知道,你只需要知道反向代理服务器是谁就好了,www.baidu.com 就是我们的反向代理服务器,反向代理服务器会帮我们把请求转发到真实的服务器那里去。
LVS 四层负载均衡集群
图片缺失:C:\Users\Stan\AppData\Roaming\Typora\typora-user-images\image-20220715163309693.png
总结:从上面的对比看来四层负载与七层负载最大的区别就是效率与功能的区别。四层负载架构设计比较简单,无需解析具体的消息内容,在网络吞吐量及处理能力上会相对比较高,而七层负载均衡的优势则体现在功能多,控制灵活强大。在具体业务架构设计时,使用七层负载或者四层负载还得根据具体的情况综合考虑。
数据库系统
Mysql表格设计?
平衡范式与冗余(效率优先;往往牺牲范式)拒绝 3B(拒绝大sql 语句:big sql、拒绝大事务:big transaction、拒绝大批量:big batch);
先建立索引或者分区,然后再查询
事务
要保证交易正常可靠地进行,数据库就得解决上面的四个问题,这也就是事务诞生的背景
事务(transaction)指一组 SQL 语句;每一个 MySQL 语句都是相互依赖的。而整个单独单元作为一个不可分割的整体, 如果单元中某条 SQL 语句一旦执行失败或产生错误,整个单元将会回滚。 所有受到影响的数据将返回事务开始以前的状态;如果单元中的所有 SQL 语句均执行成功, 则事务被顺利执行。 保留点(savepoint)指事务处理中设置的临时占位符(placeholder),你可以对它发布回退(与回退整个事务处理不同)。
创建
隐式事务:
比如insert、update、delete语句。显式事务:
事务具有明显的开启和结束标记。前提: 必须先设置自动提交功能为禁用。set autocommit=0;事务四大特性,数据库特性
-
A (Atomicity) 原子性:整个事务中的所有操作,要么全部完成,要么全部不完成,不可能停滞在中间某个环节。事务在执行过程中发生错误,会被回滚(Rollback)到事务开始前的状态,就像这个事务从来没有执行过一样
-
C (Consistency) 一致性:在事务开始之前和事务结束以后,数据库的完整性约束没有被破坏。A 账户和 B 账户之间相互转账,无论如何操作,A、B 账户的总金额都必须是不变的。数据库只有一个状态,不存在未确定状态
-
隔离性(Isolation):隔离性是当多个用户 并发的 访问数据库时,如果操作同一张表,数据库则为每一个用户都开启一个事务,且事务之间互不干扰,如果 A 在转账 1 亿给 B(T1),同时 C 又在转账 3 亿给 A(T2),不管 T1 和 T2 谁先执行完毕,最终结果必须是 A 账户增加 2 亿,而不是 3 亿,B 增加 1 亿,C 减少 3 亿。4 个隔离级别
持久性(Durability):持久性就是指如果事务一旦被提交,数据库中数据的改变就是永久性的,即使断电或者宕机的情况下,也不会丢失提交的事务操作。
图片缺失:C:\Users\Stan\AppData\Roaming\Typora\typora-user-images\image-20220704201518906.png
只有满足一致性,事务的执行结果才是正确的。 在无并发的情况下,事务串行执行,隔离性一定能够满足。此时只要能满足原子性,就一定能满足一致性。 在并发的情况下,多个事务并行执行,事务不仅要满足原子性,还需要满足隔离性,才能满足一致性。 如何保证原子性
begin; -- 开始一个事务update table set A = A - 1亿; -- 伪sql,仅作示意update table set B = B + 1亿;-- 其他读写操作commit; -- 提交事务要保证上面操作的原子性, 就得等begin和commit之间的操作全部成功完成后,才将结果统一提交给数据库保存,如果途中任意一个操作失败,就撤销前面的操作,且操作不会提交数据库保存,这样就保证了同生共死。
如何保证隔离性
原子性的问题解决了,但是如果有另外的事务在同时修改数据 A 怎么办呢? 虽然可以保证事务的同生共死,但是数据一致性会被破坏。 此时需要引入数据的隔离机制,确保同时只能有一个事务在修改 A,一个修改完了,另一个才来修改。 这需要对数据 A 加上互斥锁
问题:ACID 中哪个特性最重要?
Consistency 一致性, AID 都是为了保证 C,但注意的是 ACID 里的一致性和 CAP 定理里的一致性不是一回事!这里的一致性是指系统从一个正确的状态,迁移到另一个正确的状态.什么叫正确的状态呢?就是当前的状态满足预定的约束就叫做正确的状态
然而微服务架构下,每个微服务都有自己的数据库,导致微服务架构的系统不能简单地满足 ACID,我们就需要寻找微服务架构下的数据一致性解决方案。
微服务架构的系统本身是一种分布式系统,而本文讨论的问题其实也就是分布式事务之数据一致性的问题,我们来聊聊分布式系统的 CAP 理论和 BASE 理论。
隔离级别
并发环境中事务的隔离级别一共分为四种,安全性分别如下:
- 序列化(SERIALIZABLE):如果隔离级别为序列化,则用户之间通过一个接一个顺序地执行当前的事务,这种隔离级别提供了事务之间最大限度的隔离。
- 可重复读(REPEATABLE READ):这是 MySQL 的默认事务隔离级别,它确保**同一事务的多个实例在并发读取数据时,会看到同样的数据行。**不过理论上,这会导致另一个棘手的问题:幻读 (Phantom Read)。简单的说,幻读指当用户读取某一范围的数据行时,另一个事务又在该范围内插入了新行,当用户再读取该范围的数据行时,会发现有新的“幻影” 行。InnoDB 和 Falcon 存储引擎通过多版本并发控制(MVCC,Multiversion Concurrency Control)机制解决了该问题。
- **提交读(READ COMMITTED)**这是大多数数据库系统的默认隔离级别(Oracle、PostgreSQL、SQL Server 默认模式)。它满足了隔离的简单定义:**一个事务只能看见已经提交事务所做的改变。**这种隔离级别 也支持所谓的不可重复读(Nonrepeatable Read),因为同一事务的其他实例在该实例处理其间可能会有新的 commit,所以同一 select 可能返回不同结果。
- **未提交读(READ UNCOMMITTED)**处于这个隔离级的事务可以读到其他事务还没有提交的数据 在该隔离级别,所有事务都可以看到其他未提交事务的执行结果。本隔离级别很少用于实际应用,因为它的性能也不比其他级别好多少。读取未提交的数据,也被称之为脏读(Dirty Read)。
信息检索
正向索引: 当用户发起查询时(假设查询为一个关键词),搜索引擎会扫描索引库中的所有文档,找出所有包含关键词的文档,这样依次从文档中去查找是否含有关键词的方法叫做正向索引。增加效率,搜索引擎会把正向索引变为反向索引(倒排索引)即把“文档→单词”的形式变为“单词→文档”的形式,分出来的词集合称为 Term Dictionary。
倒排索引具体机构如下: 单词 1→文档 1 的 ID;文档 2 的 ID;文档 3 的 ID…
倒排索引(Inverted Index):倒排索引是实现**“单词-文档矩阵”**的一种具体存储形式,通过倒排索引,可以根据单词快速获取包含这个单词的文档列表。倒排索引主要由两个部分组成:“单词词典”和“倒排文件”。
单词词典(Lexicon):搜索引擎的通常索引单位是单词,单词词典是由文档集合中出现过的所有单词构成的字符串集合,单词词典内每条索引项记载单词本身的一些信息以及指向“倒排列表”的指针。 倒排列表(PostingList):倒排列表记载了出现过某个单词的所有文档的文档列表及单词在该文档中出现的位置信息,每条记录称为一个倒排项(Posting)。根据倒排列表,即可获知哪些文档包含某个单词。 倒排文件(Inverted File):所有单词的倒排列表往往顺序地存储在磁盘的某个文件里,这个文件即被称之为倒排文件,倒排文件是存储倒排索引的物理文件。
图片缺失:C:\Users\Stan\AppData\Roaming\Typora\typora-user-images\image-20220712161121828.png
图片缺失:C:\Users\Stan\AppData\Roaming\Typora\typora-user-images\image-20220712161224139.png
TF(term frequency): 单词在文档中出现的次数。 Pos: 单词在文档中出现的位置。
这个表格展示了更加复杂的倒排索引,前两列不变,第三列倒排索引包含的信息为(文档 ID,单词频次,<单词位置>),比如单词“乔布斯”对应的倒排索引里的第一项(1;1;<1>)意思是,文档 1 包含了“乔布斯”,并且在这个文档中只出现了 1 次,位置在第一个。
索引
数据库索引是对数据库表的一列或者多列的值进行排序一种结构,使用索引可以快速访问数据表中的特定信息。
索引的优缺点?
优点:
- 大大加快数据检索的速度。
- 将随机 I/O 变成顺序 I/O(因为 B+树的叶子节点是连接在一起的)
- 加速表与表之间的连接
缺点:
- 从空间角度考虑,建立索引需要占用物理空间
- 从时间角度 考虑,创建和维护索引都需要花费时间,例如对数据进行增删改的时候都需要维护索引。
索引的实现通常使用Hash 索引和 B+树(MySQL 常用的索引就是 B+树)。除了数据之外,数据库系统还维护为满足特定查找算法的数据结构,这些数据结构以某种方式引用数据,这种数据结构就是索引。简言之,索引就类似于书本,字典的目录。 B 树中的内部节点和叶子节点均存放键和值,而 B+树的内部节点只有键没有值,叶子节点存放所有的键和值。 B+树的叶子节点是通过相连在一起的,方便顺序检索。 两者的结构图如下。
聚簇索引:将数据和索引放到一起存储,索引结构的叶子节点保留了数据行。 非聚簇索引:将数据进和索引分开存储,索引叶子节点存储的是指向数据行的地址。
CREATE INDEX ,ALTER TABLE
分布式
CAP 原则又称 CAP 定理,指的是在一个分布式系统中,Consistency(一致性)、 Availability(可用性)、Partition tolerance(分区容错性),三者不可兼得。
- 一致性(C):对某个指定的客户端来说,读操作能返回最新的写操作结果
- 可用性(A):指系统提供的服务必须一直处于可用的状态,每次请求都能获取到非错的响应(不保证获取的数据为最新数据)
- 分区容错性(P):分布式网络中部分网络不可用时, 系统依然正常对外提供服务。网络允许丢失信息
- 以电商网站为例,会员登录、个人设置、个人订单、购物车、搜索用 AP,因为这些数据短时间内不一致不影响使用;后台的商品管理就需要 CP,避免商品数量的不一致;支付功能需要 CA,保证支付功能的安全稳定
BASE 理论的核心思想是:即使无法做到强一致性,但每个应用都可以根据自身业务特点,采用适当的方式来使系统达到最终一致性。
- Basically Available(基本可用) 响应时间上的损失:正常情况下,处理用户请求需要 0.5s 返回结果,但是由于系统出现故障,处理用户请求的时间变成 3s。 系统功能上的损失:正常情况下,在一个电子商务网站上进行购物的时候,消费者几乎能够顺利完成每一笔订单,但是在一些节日大促购物高峰的时候,由于消费者的购物行为激增,为了保护购物系统的稳定性,部分消费者可能会被引导到一个降级页面
- 软状态 软状态指允许系统中的数据存在中间状态,并认为该中间状态的存在不会影响系统的整体可用性,即允许系统在不同节点的数据副本之间进行数据同步的过程存在延时
- 最终一致性 最终一致性强调的是系统中所有的数据副本,在经过一段时间的同步后,最终能够达到一个一致的状态。因此,最终一致性的本质是需要系统保证最终数据能够达到一致,而不需要实时保证系统数据的强一致性。
- 分布式: 一个业务分拆多个子业务,部署在不同的服务器上
- 集群: 同一个业务,部署在多个服务器上。比如之前做电商网站搭的 redis 集群以及 solr 集群都是属于将 redis 服务器提供的缓存服务以及 solr 服务器提供的搜索服务部署在多个服务器上以提高系统性能、并发量解决海量存储问题。
The consensus problem requires agreement among a number of processes (or agents) for a single data value. Some of the processes (agents) may fail or be unreliable in other ways, so consensus protocols must be fault tolerant or resilient. The processes must somehow put forth their candidate values, communicate with one another, and agree on a single consensus value.
The consensus problem is a fundamental problem in control of multi-agent systems. One approach to generating consensus is for all processes (agents) to agree on a majority value. In this context, a majority requires at least one more than half of available votes (where each process is given a vote). However, one or more faulty processes may skew the resultant outcome such that consensus may not be reached or reached incorrectly.
解决共识问题的协议旨在处理数量有限的错误进程 Protocols that solve consensus problems are designed to deal with limited numbers of faulty processes. These protocols must satisfy a number of requirements to be useful. For instance, a trivial protocol could have all processes output binary value 1. This is not useful and thus the requirement is modified such that the output must somehow depend on the input. That is, the output value of a consensus protocol must be the input value of some process. Another requirement is that a process may decide upon an output value only once and this decision is irrevocable. A process is called correct in an execution if it does not experience a failure. A consensus protocol tolerating halting failures must satisfy the following properties.[1]
TerminationEventually, every correct process decides some value.IntegrityIf all the correct processes proposed the same value {\displaystyle v}, then any correct process must decide {\displaystyle v}.AgreementEvery correct process must agree on the same value.
OLTP vs OLAP

MapReduce
1TB 的数据,如何统计单词数?如何建立倒排索引?这其实是很复杂的过程,如果有 10TB,或者 1PB 数据怎么办呢?这时候单机就没办法做,变得很复杂需要想办法来解决。很多人说这些可以自己单机写,单机写的过程甚至构建了一个 MapReduce 的系统
是面向大数据并行处理的计算模型、框架和平台,它隐含了以下三层含义:
1)MapReduce 是一个基于集群的高性能并行计算平台(Cluster Infrastructure)。它允许用市场上普通的商用服务器构成一个包含数十、数百至数千个节点的分布和并行计算集群。
2)MapReduce是一种编程模型和相关实现,用于在集群上使用并行分布式算法处理和生成大数据集将数据分布存储、数据通信、容错处理等并行计算涉及到的很多系统底层的复杂细节交由系统负责处理,大大减少了软件开发人员的负担。
3)MapReduce 是一个并行程序设计模型与方法(Programming Model & Methodology)。它借助于函数式程序设计语言Lisp 的设计思想,提供了一种简便的并行程序设计方法,用 Map 和 Reduce 两个函数编程实现基本的并行计算任务,提供了抽象的操作和并行编程接口,以简单方便地完成大规模数据的编程和计算处理 A MapReduce program is composed of a map procedure, which performs filtering and sorting (such as sorting students by first name into queues, one queue for each name), and a reduce method, which performs a summary operation (such as counting the number of students in each queue, yielding name frequencies). The “MapReduce System” (also called “infrastructure” or “framework”) orchestrates the processing by marshalling the distributed servers, running the various tasks in parallel, managing all communications and data transfers between the various parts of the system, and providing for redundancy and fault tolerance .
Hadoop 实现了一个分布式文件系统( Distributed File System),其中一个组件是HDFS(Hadoop Distributed File System)。HDFS 有高容错性的特点,并且设计用来部署在低廉的(low-cost)硬件上;而且它提供高吞吐量(high throughput)来访问应用程序的数据,适合那些有着超大数据集(large data set)的应用程序。HDFS 放宽了(relax)POSIX的要求,可以以流的形式访问(streaming access)文件系统中的数据。Hadoop 的框架最核心的设计就是:HDFS和MapReduce。HDFS 为海量的数据提供了存储,而 MapReduce 则为海量的数据提供了计算
Redis
Redis(Remote Dictionary Server ),即远程字典服务。C 语言开发的一个开源的(遵从 BSD 协议)高性能键值对(key-value)的内存数据库,可以用作数据库、缓存、消息中间件等。它是一种 NoSQL(not-only sql,泛指非关系型数据库)的数据库。
我顿了一下,接着说:Redis 作为一个内存数据库。1、性能优秀,数据在内存中,读写速度非常快,支持并发 10W QPS;2、单进程单线程,是线程安全的,采用 IO多路复用机制;3、丰富的数据类型,支持字符串(strings)、散列(hashes)、列表(lists)、集合(sets)、有序集合(sorted sets)等;4、支持数据持久化。可以将内存中数据保存在磁盘中,重启时加载;5、主从复制,哨兵,高可用;6、可以用作分布式锁;7、可以作为消息中间件使用,支持发布订阅
图片缺失:C:\Users\Stan\AppData\Roaming\Typora\typora-user-images\image-20220703101749620.png
Redis 这么快?
第一:Redis 完全基于内存,绝大部分请求是纯粹的内存操作,非常迅速,数据存在内存中,类似于 HashMap,HashMap 的优势就是查找和操作的时间复杂度是 O(1)。第二:数据结构简单,对数据操作也简单。第三:采用单线程,避免了不必要的上下文切换和竞争条件,不存在多线程导致的 CPU 切换,不用去考虑各种锁的问题,不存在加锁释放锁操作,没有死锁问题导致的性能消耗。第四:使用多路复用 IO 模型,非阻塞 IO。
为什么是单线程的
- Redis 是基于内存的操作,CPU 不是 Redis 的瓶颈
- 省去了很多上下文切换线程的时间,不用去考虑各种锁的问题
- 多路 I/O 复用:使用了单线程来轮询描述符,减少了线程切换时上下文的切换和竞争
- 能带来更好的可维护性,方便开发和调试
Redis 需要对数据设置过期时间,并采用的是惰性删除+定期删除两种策略对过期键删除。Redis 对过期键的策略+持久化
如果缓存数据设置的过期时间是相同的,并且 Redis 恰好将这部分数据全部删光了。这就会导致在这段时间内,这些缓存同时失效,全部请求到数据库中。
缓存雪崩:
- Redis 挂掉了,请求全部走数据库。
- 对缓存数据设置相同的过期时间,导致某段时间内缓存失效,请求全部走数据库。
缓存雪崩如果发生了,很可能就把我们的数据库搞垮,导致整个服务瘫痪!
如何解决缓存雪崩?
- 解决方法:考虑用加锁或者队列的方式保证来保证不会有大量的线程对数据库一次性进行读写,从而避免失效时大量的并发请求落到底层存储系统上;还有一个解决方案,原有的失效时间基础上增加一个随机值,这样就会大幅度的减少缓存在同一时间过期。
对于“Redis 挂掉了,请求全部走数据库”这种情况,我们可以有以下的思路:
- 事发前:实现 Redis 的高可用(主从架构+Sentinel 或者 Redis Cluster),尽量避免 Redis 挂掉这种情况发生。
- 事发中:万一 Redis 真的挂了,我们可以设置本地缓存(ehcache)+限流(hystrix),尽量避免我们的数据库被干掉(起码能保证我们的服务还是能正常工作的)
- 事发后:redis 持久化,重启后自动从磁盘上加载数据,快速恢复缓存数据。
缓存穿透
是指查询一个一定不存在的数据。由于缓存不命中,并且出于容错考虑,如果从数据库查不到数据则不写入缓存,这将导致这个不存在的数据每次请求都要到数据库去查询,失去了缓存的意义。
缓存穿透也有两种方案:
- 由于请求的参数是不合法的(每次都请求不存在的参数),于是我们可以使用布隆过滤器(BloomFilter)或者压缩 filter提前拦截,不合法就不让这个请求到数据库层!
- 当我们从数据库找不到的时候,我们也将这个空对象设置到缓存里边去。下次再请求的时候,就可以从缓存里边获取了。
- 这种情况我们一般会将空对象设置一个较短的过期时间。
缓存与数据库双写一致
只要我们设置了键的过期时间,我们就能保证缓存和数据库的数据最终是一致的。因为只要缓存数据过期了,就会被删除。随后读的时候,因为缓存里没有,就可以查数据库的数据,然后将数据库查出来的数据写入到缓存中。
除了设置过期时间,我们还需要做更多的措施来尽量避免数据库与缓存处于不一致的情况发生。分布式环境下非常容易出现缓存和数据库间数据一致性问题,针对这一点,如果项目对缓存的要求是强一致性的,那么就不要使用缓存。我们只能采取合适的策略来降低缓存和数据库间数据不一致的概率,而无法保证两者间的强一致性。合适的策略包括合适的缓存更新策略,更新数据库后及时更新缓存、缓存失败时增加重试机制。
两种策略各自有优缺点:
- 先删除缓存,再更新数据库
- 在高并发下表现不如意,在原子性被破坏时表现优异
- 先更新数据库,再删除缓存(
Cache Aside Pattern设计模式) - 在高并发下表现优异,在原子性被破坏时表现不如意
- 部署方式
- 主从
- 从服务器连接主服务器,发送 SYNC 命令;主服务器接收到 SYNC 命名后,开始执行 BGSAVE 命令生成 RDB 文件并使用缓冲区记录此后执行的所有写命令;主服务器 BGSAVE 执行完后,向所有从服务器发送快照文件,并在发送期间继续记录被执行的写命令;从服务器收到快照文件后丢弃所有旧数据,载入收到的快照;主服务器快照发送完毕后开始向从服务器发送缓冲区中的写命令;从服务器完成对快照的载入,开始接受命令请求,并执行来自主服务器缓冲区的写命令;(从服务器初始化完成)主服务器每执行一个写命令就会向从服务器发送相同的写命令,从服务器接收并执行收到的写命令(从服务器初始化完成后的操作)
- 一般主从配置可以缓解请求压力,做读写分离,写服务器不开启持久化,从服务器开启,从服务器还负责读取的操作,而且从服务器可以是多个,可以有效缓解主服务器的压力;但是坏处在于,如果主服务器宕机,无法自动切换恢复;
Redis 的持久化策略
有两种:1、RDB:快照形式是直接把内存中的数据保存到一个 dump 的文件中,定时保存,保存策略。2、AOF:把所有的对 Redis 的服务器进行修改的命令都存到一个文件里,命令的集合。Redis 默认是快照 RDB 的持久化方式。当 Redis 重启的时候,它会优先使用AOF 文件来还原数据集,因为 AOF 文件保存的数据集通常比 RDB 文件所保存的数据集更完整。你甚至可以关闭持久化功能,让数据只在服务器运行时存。
MQ(Message Queue)
是基础数据结构中“先进先出”的一种数据结构。一般用来解决应用解耦,异步消息,流量削峰等问题,实现高性能,高可用,可伸缩和最终一致性架构
缺点:
系统复杂性
本来蛮简单的一个系统,我代码随便写都没事,现在你凭空接入一个中间件在那,我是不是要考虑去维护他,而且使用的过程中是不是要考虑各种问题,比如消息重复消费、消息丢失、消息的顺序消费等等,反正用了之后就是贼烦。
数据一致性
这个其实是分布式服务本身就存在的一个问题,不仅仅是消息队列的问题,但是放在这里说是因为用了消息队列这个问题会暴露得比较严重一点。
可用性
你搞个系统本身没啥问题,你现在突然接入一个中间件在那放着,万一挂了怎么办?我下个单MQ 挂了,优惠券不扣了,积分不减了,这不是杀一个程序员能搞定的吧,感觉得杀一片。
消息队列中间件
目前在市面上比较主流的消息队列中间件主要有,Kafka、ActiveMQ、RabbitMQ、RocketMQ 等这几种。
图片缺失:C:\Users\Stan\AppData\Roaming\Typora\typora-user-images\image-20220702160812046.png
Elasticsearch
Elasticsearch 是一个分布式、可扩展、实时的搜索与数据分析引擎。 它能从项目一开始就赋予你的数据以搜索、分析和探索的能力,可用于实现全文搜索和实时数据统计。
微服务
熔断、隔离、降级
服务隔离、降级和熔断的产生背景 tomcat 底层都会共享一个线程池(自己创建的例外),当某个方法(服务)访问非常慢造成响应延迟,会造成大多数线程阻塞,导致整个线程池被占用甚至拖垮。 线程名定义:线程池名称+线程 ID
2.服务隔离解决思路 2.1 线程池隔离
不同的 http 服务使用不同的线程池,当自己的资源用完,直接返回失败而不是占用别人的资源 优点:可提高并发性 缺点:增加 CPU 调度开销 使用场景:第三方应用或接口;并发量大
2.2 信号量隔离
原子计数器方式记录当前运行的线程数,超过则拒绝,不超过则+1,返回则-1 使用场景:内部应用或中间件;并发需求不大
区别:信号量可动态调整,但线程池不可以调整
3.服务降级 当服务不可用(服务正在等待、链接超时、网络延迟、服务器响应慢等),客户端一直等待时,调用 fallback 方法给客户端返回一个错误提示,不让客户端继续等待。 目的:提高用户体验,防止雪崩效应。
4.服务熔断 熔断和保险丝一样,当访问请求过多的时候,达到一个阈值(自己设置)就直接拒绝访问,可以保护当前服务,让服务不会被挂掉,需要和服务降级一起使用。
RPC
RPC 的全称是 Remote Procedure Call 是一种进程间通信方式。它允许程序调用另一个地址空间(通常是共享网络的另一台机器上)的过程或函数,而不用程序员显式编码这个远程调用的细节。即无论是调用本地接口/服务的还是远程的接口/服务,本质上编写的调用代码基本相同。
RPC 是一个请求响应模型 会隐藏底层的通讯细节(不需要直接处理 Socket 通讯或 Http 通讯)。客户端发起请求,服务器返回响应(类似于 Http 的工作方式).RPC 在使用形式,最初目的是像调用本地函数(或方法)一样去调用远程的函数(或方法)。
除 RPC 之外,常见的多系统数据交互方案还有分布式消息队列、HTTP 请求调用、数据库和分布式缓存等。 其中 RPC 和 HTTP 调用是没有经过中间件的,它们是端到端系统的直接数据交互。
在 RPC 框架中主要有三个角色:提供者、消费者和注册中心。如下图所示:

在这里插入图片描述
- 提供者: 暴露服务的服务提供方。
- 调用者: 调用远程服务的服务消费方。
- 注册中心: 服务注册与发现的注册中心。
4 步:建立通信,服务寻址,网络传输,服务调用
3、网络传输
3.1、序列化
客户端怎么把参数值传给远程的函数呢?在本地调用中,我们只需要把参数压到栈里,然后让函数自己去栈里读就行。但是在远程过程调用时,客户端跟服务端是不同的进程,不能通过内存来传递参数。甚至有时候客户端和服务端使用的都不是同一种语言(比如服务端用 C++,客户端用 Java 或者 Python)。这时候就需要客户端把参数先转成一个字节流,传给服务端后,再把字节流转成自己能读取的格式。这个过程叫序列化和反序列化。同理,从服务端返回的值也需要序列化反序列化的过程。
当 A 机器上的应用发起一个 RPC 调用时,调用方法和其入参等信息需要通过底层的网络协议如 TCP 传输到 B 机器,由于网络协议是基于二进制的,所有我们传输的参数数据都需要先进行序列化(Serialize)或者编组(marshal)成二进制的形式才能在网络中进行传输。然后通过寻址操作和网络传输将序列化或者编组之后的二进制数据发送给 B 机器。
3.2、反序列化 B 接收到请求后,二进制信息恢复为内存中的表达方式
网络传输。
远程调用往往用在网络上,客户端和服务端是通过网络连接的。所有的数据都需要通过网络传输,因此就需要有一个网络传输层。网络传输层需要把 Call ID 和序列化后的参数字节流传给服务端,然后再把序列化后的调用结果传回客户端。只要能完成这两者的,都可以作为传输层使用。因此,它所使用的协议其实是不限的,能完成传输就行。尽管大部分 RPC 框架都使用 TCP 协议,但其实 UDP 也可以,而 gRPC 干脆
分布式运算 8 宗罪
\1. The network is reliable —— 网络是可靠的。 \2. Latency is zero —— 延迟是不存在的。 \3. Bandwidth is infinite —— 带宽是无限的。 \4. The network is secure —— 网络是安全的。 \5. Topology doesn’t change —— 拓扑结构是一成不变的。 \6. There is one administrator —— 总会有一个管理员。 \7. Transport cost is zero —— 不必考虑传输成本。 \8. The network is homogeneous —— 网络是同质化的
RPC 发展为 RMI(Sun/Oracle)、Thrift(Facebook/Apache)、Dubbo(阿里巴巴/Apache)、gRPC(Google)、Motan1/2(新浪)、Finagle(Twitter)、brpc(百度/Apache)、.NET Remoting(微软)、Arvo(Hadoop)、JSON-RPC 2.0 (公开规范,JSON-RPC 工作组)……等等难以穷举的协议和框架。最近几年,RPC 框架有明显的朝着更高层次(不仅仅负责调用远程服务,还管理远程 服务)与插件化方向发展的趋势,不再追求独立地解决 RPC 的全部三个问题(表示数据、 传递数据、表示方法)
Linux
Linux,全称GNU/Linux,是一种免费使用和自由传播的类 UNIX操作系统,其内核由林纳斯·本纳第克特·托瓦兹于 1991 年 10 月 5 日首次发布,它主要受到Minix和 Unix 思想的启发,是一个基于POSIX的多用户、多任务、支持多线程和多CPU的操作系统。它能运行主要的Unix工具软件、应用程序和网络协议。它支持32 位和64 位硬件。Linux 继承了 Unix 以网络为核心的设计思想,是一个性能稳定的多用户网络操作系统。Linux 有上百种不同的发行版,如基于社区开发的debian、archlinux,和基于商业开发的Red Hat Enterprise Linux、SUSE、Oracle Linux等。
linux 网络
$表明是非 root 用户登录,#表示是 root 用户登录,它们是终端 shell 的命令提示符 几种常用终端的命令提示符
BASH: root 账户: # ,非 root 账户: KSH: root账户: # ,非root账户: CSH[TCSH]: root 账户: % ,非 root 账户: %
而/ 是根节点, ~ 是 home如果以root账号登陆 ~ 是 /root/Program:a file containing instructions to be executed, static Process: an instance of a program in execution, live entity
execve(执行文件)在父进程中 fork 一个子进程,在子进程中调用 exec 函数启动新的程序。exec 函数一共有六个,其中 execve 为内核级系统调用,其他(execl,execle,execlp,execv,execvp)exec(): often used after fork() to load another process
提出一个问题:当在 O_APPEND 打开后,然后用 lseek 移动到其他的位置,然后再用 write 写,这个时候,请问你数据写到哪里去了?
是在末端,还是 lseek 移动到得位置。答案是在末端。
因为 O_APPEND 打开后,是一个原子操作:移动到末端,写数据。这是 O_APPEND 打开的作用。中间的插入时无效的
通信双方交流的信息单元(比特、字节、字、双字等等)应该以什么样的顺序进行传送。如果不达成一致的规则,通信双方将无法进行正确的编/译码从而导致通信失败。Big Endian 和 Little Endian
FTP
主动模式的 FTP 是指服务器主动连接客户端的数据端口,被动模式的 FTP 是指服务器被动等待客户端连接自己的数据端口。
被动模式的 FTP 通常用在处于防火墙之后的 FTP 客户访问外界 FTP 服务器的情况,因为在这种情况下,防火墙通常配置为不允许外界访问防火墙之内的主机,而只允许由防火墙之内的主机发起对外的连接请求。因此,在这种情况下不能使用主动模式的 FTP 传输,而被动模式的 FTP 可以良好的工作。
主动模式需要服务器主动向客户端发起连接,而现在普通的客户端大多位于 NAT 之后,所以主动模式常常无法进行。即使可以,也需要客户端打开防火墙,允许服务端的 20 端口访问。所以服务端基本需要支持被动模式,但被动模式需要开放一段端口。为了安全,可以选择一小段端口,然后在防火墙开放这一段端口。
面向对象语言(OO)知识点:
三个特征
- 封装 封装,也就是把客观事物封装成抽象的类,并且类可以把自己的数据和方法只让可信的类或者对象操作,对不可信的进行信息隐藏。
- 继承 继承是指这样一种能力:它可以使用现有类的所有功能,并在无需重新编写原来类的情况下对这些功能进行扩展。通过继承创建的新类称为「子类」或「派生类」,被继承的类称为「基类」、「父类」或「超类」。 要实现继承,可以通过 继承和组合 来实现。
- 多态性 多态性是允许你将父对象设置成为和一个或更多的他的子对象相等的技术,赋值之后,父对象就可以根据当前赋值给它的子对象的特性以不同的方式运作。简单说就是一句话:允许将子类类型的指针赋值给父类类型的指针。 实现多态,有两种方式,覆盖和重载。两者的区别在于:覆盖在运行时决定,重载是在编译时决定。并且覆盖和重载的机制不同。例如在 Java 中,重载方法的签名必须不同于原先方法的,但对于覆盖签名必须相同。
我对面向对象的理解:面向对象的编程方式使得每一个类都只做一件事。面向过程会让一个类越来越全能,就像一个管家一样做了所有的事。而面向对象像是雇佣了一群职员,每个人做一件小事,各司其职,最终合作共赢
1.类之间的关系:
简单的说,类和类之间的关系有三种:is-a、has-a 和 use-a 关系。
is-a 关系也叫继承 inheritance 或泛化,比如学生和人的关系、手机和电子产品的关系都属于继承关系。
has-a 关系通常称之为聚类(关联)aggregation,比如部门和员工的关系,汽车和引擎的关系都属于关联关系;关联关系如果是整体和部分的关联,那么我们称之为聚合关系;如果整体进一步负责了部分的生命周期(整体和部分是不可分割的,同时同在也同时消亡),那么这种就是最强的关联关系,我们称之为合成关系。 use-a 关系通常称之为依赖,比如司机有一个驾驶的行为(方法),其中(的参数)使用到了汽车,那么司机和汽车的关系就是依赖关系。
2 创建对象
Vehicle veh1;veh1 = new Vehicle();==等价 Vehicle veh1 = new Vehicle();事实上应该是 veh1 是包含 Vehicle 对象的一个引用。
数据存储:auto普通局部栈变量,是自动存储,这种对象会自动创建和销毁 , static静态数据,地址不变 只初始化一次 静态局部变量存值如同全局变量, 区别在于它只属于拥有它的函数; 它也会被初始化为空, extern外部变量声明不产生新数据,register CPU加快 用于频繁使用的变量;PYTHON
1.和 C/C++、Java 等语言不同,Python 中没有用花括号来构造代码块而是使用了缩进的方式来表示代码的层次结构
def roll_dice(n=2): for _ in range(1,100): 使用:代替{ }

复合赋值位运算符“&=、^ =、| =”
任务,可能事先需要设置,事后做清理工作。对于这种场景,Python 的 with 语句提供了一种非常方便的处理方式。一个很好的例子是文件处理。with 所求值的对象必须有一个__enter__()方法,一个__exit__()方法。
紧跟 with 后面的语句被求值后,返回对象的__enter__()方法被调用,这个方法的返回值将被赋值给 as 后面的变量。当 with 后面的代码块全部被执行完之后,将调用前面返回对象的__exit__()方法。
爬虫
Regular expression
通过使用正则表达式,可以匹配,检索和替换那些符合某个模式(规则)的文本等.
- 测试字符串内的模式。 例如,可以测试输入字符串,以查看字符串内是否出现电话号码模式或信用卡号码模式。这称为数据验证。
- 替换文本。 可以使用正则表达式来识别文档中的特定文本,完全删除该文本或者用其他文本替换它。
- 基于模式匹配从字符串中提取子字符串。 可以查找文档内或输入域内特定的文本。
例如,您可能需要搜索整个网站,删除过时的材料,以及替换某些 HTML 格式标记。在这种情况下,可以使用正则表达式来确定在每个文件中是否出现该材料或该 HTML 格式标记。此过程将受影响的文件列表缩小到包含需要删除或更改的材料的那些文件。然后可以使用正则表达式来删除过时的材料。最后,可以使用正则表达式来搜索和替换标记。
元字符
[^…]:非…
图片缺失:C:\Users\Stan\AppData\Roaming\Typora\typora-user-images\image-20220327114645805.png
量词 ?:0-1 *: 0-∞ +: 1-∞
.* ? 惰性匹配 .* 贪婪匹配
反爬
1.headers 中的 useragent
2.cookie
3.headers 中的 referer
python 爬虫的 xpath、bs4、re 解析方法。xpath和 bs4 是属于第三方库 bs4 和 xpath 都是用来解析 html 数据的 相比之下,xpath 的速度会快一点 正则使用元字符 xpath 和 bs4 将获取的源码转化成一个对象
模拟浏览器——处理 cookie
防盗链 溯源—— Referer
找到未加密的参数 和加密过程语句
回车、换行的区别
在 Windows 中:
‘ (回车):即将光标回到当前行的行首(而不会换到下一行),之后的输出会把之前的输出覆盖
‘’ 换行,换到当前位置的下一位置,而不会回到行首;
Unix 系统里,每行结尾只有“<换行>”,即“”;
Windows 系统里面,每行结尾是“<回车><换行>”,即“”;
Mac 系统里,每行结尾是“<回车>”,即”;
也就是:
Linux 中遇到换行符(“”)会进行回车+换行的操作,回车符(“)反而只会作为控制字符(”^M“)显示,不发生回车的操作。 而 windows 中要回车符+换行符(”“)才会回车+换行,缺少一个控制符或者顺序不对都不能正确的另起一行。 一个直接后果是:
Unix/Mac 系统下的文件在 Windows 里打开的话,所有文字会变成一行; Windows 里的文件在 Unix/Mac 下打开的话,在每行的结尾可能会多出一个^M 符号。
在解析字符串,或其他格式的文件内容的时候,经常需要判定回车换行”的地方,这个时候就要注意:既要判定“”又要判定“”。
写程序时可能得到一行,将其进行 trim 掉’,这样能得到所需要的 string 了。
基础数据类型
列表转换:list(str1) 将字符串转化成列表
元组转换:tuple(list01) 将列表转换为元组
字典转换:dict(zip(keylist,valuelist)) 列表转换成字典
集合转换:set(list01) 列表转换为集合
2.循环
range(1, 101, 2):可以用来产生 1 到 100 的奇数,其中 2 是步长,即每次数值递增的值。range(100, 0, -2):可以用来产生 100 到 1 的偶数,其中-2 是步长,即每次数字递减的值。
Golang
在 Go 语言出现之前,开发者们总是面临非常艰难的抉择,究竟是使用执行速度快但是编译速度并不理想的语言(如:C++),还是使用编译速度较快但执行效率不佳的语言(如:.NET、Java),或者说开发难度较低但执行速度一般的动态语言呢?显然,Go 语言在这 3 个条件之间做到了最佳的平衡:快速编译,高效执行,易于开发。
Go 语言支持交叉编译,比如说你可以在运行 Linux 系统的计算机上开发可以在 Windows 上运行的应用程序。这是第一门完全支持 UTF-8 的编程语言,这不仅体现在它可以处理使用 UTF-8 编码的字符串,就连它的源码文件格式都是使用的 UTF-8 编码。
Go 语言在 C 语言的基础上取其精华,弃其糟粕,将 C 语言中较为容易发生错误的写法进行调整,做出相应的编译提示。
https://go.dev/doc/faq#Is_Go_an_object-oriented_language
强类型静态编译型语言。隐式继承
可以在事后添加接口,而无需注释原始类型。因为类型和接口之间没有明确的关系,所以没有要管理或讨论的类型层次结构。
声明变量
var a string, var 声明自动匹配,
使用操作符 := 可以高效地创建一个新的变量,称之为初始化声明。
如果在相同的代码块中,我们不可以再次对于相同名称的变量使用初始化声明,例如:a := 20 就是不被允许的,编译器会提示错误 no new variables on left side of :=,但是 a = 20 是可以的,因为这是给相同的变量赋予一个新的值。
如果你在定义变量 a 之前使用它,则会得到编译错误 undefined: a。
如果你声明了一个局部变量却没有在相同的代码块中使用它,同样会得到编译错误,例如下面这个例子当中的变量 a:
:=表示声明并赋值,只要:=左边有一个新变量都可以用:=,否则只能用=; 且不能用于声明全局变量
iota 是 Go 语言的一个保留字,用作常量计数器。由于 iota 具有自增特性,所以使用 iota 能简化定义,在定义枚举时很有用。
使用iota时只需要记住以下两点
1.iota在const关键字出现时将被重置为 0。
2.const中每新增一行常量声明将使iota计数一次(iota 可理解为const语句块中的行索引)。
”_“表示匿名变量,无法访问
函数
func max(num1, num2 int) int {
多返回值写法:
//匿名返回func swap(x, y string) (string, string) { return y, x}//s1 s2 属于swap的形参,为默认值func swap(x, y string) (s1 string,s2 string) { return y, x}形参就像定义在函数体内的局部变量。
调用函数,可以通过两种方式来传递参数:
默认情况下,Go 语言使用的是值传递,即在调用过程中不会影响到实际参数。
import 导包路径和 init 调用流程
图片缺失:C:\Users\Stan\AppData\Roaming\Typora\typora-user-images\image-20220721100545925.png
image-20220721100545925
//Go 语言支持匿名函数,可作为闭包。匿名函数是一个"内联"语句或表达式。匿名函数的优越性在于可以直接使用函数内的变量,不必申明。以下实例中,我们创建了函数 getSequence() ,返回另外一个函数。该函数的目的是在闭包中递增 i 变量func getSequence() func() int {   i:=0   return func() int {      i+=1     return i   }}
func main(){   /* nextNumber 为一个函数,函数 i 为 0 */   nextNumber := getSequence()
   /* 调用 nextNumber 函数,i 变量自增 1 并返回 */   fmt.Println(nextNumber())   fmt.Println(nextNumber())   fmt.Println(nextNumber())
   /* 创建新的函数 nextNumber1,并查看结果 */   nextNumber1 := getSequence()   fmt.Println(nextNumber1())   fmt.Println(nextNumber1())}
命名规范
1.1 Go 是一门区分大小写的语言。
命名规则涉及变量、常量、全局函数、结构、接口、方法等的命名。 Go 语言从语法层面进行了以下限定:任何需要对外暴露的名字必须以大写字母开头,不需要对外暴露的则应该以小写字母开头。
- 当命名(包括常量、变量、类型、函数名、结构字段等等)以一个大写字母开头,如:Analysize,那么使用这种形式的标识符的对象就可以被外部包的代码所使用(客户端程序需要先导入这个包),这被称为导出(像面向对象语言中的 public);
- 命名如果以小写字母开头,则对包外是不可见的,但是他们在整个包的内部是可见并且可用的(像面向对象语言中的 private )
1.2 包名称
保持 package 的名字和目录保持一致,尽量采取有意义的包名,简短,有意义,尽量和标准库不要冲突。包名应该为小写单词,不要使用下划线或者混合大小写。
package domainpackage main1.3 文件命名
尽量采取有意义的文件名,简短,有意义,应该为小写单词,使用下划线分隔各个单词。
approve_service.go1.4 结构体命名
-
采用驼峰命名法,首字母根据访问控制大写或者小写
-
struct 申明和初始化格式采用多行,例如下面:
type MainConfig struct { Port string `json:"port"` Address string `json:"address"`}config := MainConfig{"1234", "123.221.134"}
%v 按默认格式输出 %+v 在%v 的基础上额外输出字段名 %#v 在%+v 的基础上额外输出类型名
指针
指针可以高效地利用内存,提高性能
传地址参数给函数,函数接收指针
图片缺失:C:\Users\Stan\AppData\Roaming\Typora\typora-user-images\image-20220721142835105.png
对于 c 语言中指针的操作符有两个:&和* 。对于&,好理解,翻译的也不错,就是“取地址”的意思。但对于*,翻译为“解引用”,字面意思不好理解,即使看了后面内容才知道不过是“取指针指向的地址的内容“ 解引用是返回内存地址中对应的对象。
defer 关键字
defer 是当前函数的声明周期结束后才会出栈,所以 return 和 defer 在一个函数中时 return 先 defer 后
动态数组传参是引用传递,而且不同元素长度的动态数组形参一致
Slice 切片
切片本身并不是动态数组或者数组指针。它内部实现的数据结构通过指针引用底层数组,设定相关属性将数据读写操作限定在指定的区域内。**切片本身是一个只读对象,其工作机制类似数组指针的一种封装。**切片常见的操作有 reslice、append、copy。与此同时,切片还具有可索引,可迭代的优秀特性。
Go 中数组赋值和函数传参都是值复制的。那这会导致什么问题呢?
假想每次传参都用数组,那么每次数组都要被复制一遍。如果数组大小有 100 万,在 64 位机器上就需要花费大约 800W 字节,即 8MB 内存。这样会消耗掉大量的内存。于是乎有人想到,函数传参用数组的指针。
slice1 := make(int[],3)  //声明切片并分配空间初始值为0
var slice2 = []int//Objective-C, Swift, Ruby, Lua中的关键字,与C++里的NULL不同,NULL是一个宏定义,值为0,nil表示无值if slice2==nil{
}//追加元素,如果append时超过容量cap,容量将自动变为2倍numbers = append(numbers,2)
make()开辟 map,slice 空间
声明map
myMap = make(map[int][string])myMap1 = map[int][string]{ 0:"john", 1:"stan"}并发
虽然一些编程语言的框架在不断地提高多核资源使用效率,例如 Java 的 Netty 等,但仍然需要开发人员花费大量的时间和精力搞懂这些框架的运行原理后才能熟练掌握。
作为程序员,要开发出能充分利用硬件资源的应用程序是一件很难的事情。现代计算机都拥有多个核,但是大部分编程语言都没有有效的工具让程序可以轻易利用这些资源。编程时需要写大量的线程同步代码来利用多个核,很容易导致错误。
Go 语言正是在多核和网络化的时代背景下诞生的原生支持并发的编程语言。Go 语言从底层原生支持并发,无须第三方库,开发人员可以很轻松地在编写程序时决定怎么使用 CPU 资源。
Go 语言的并发是基于 goroutine 的,goroutine 类似于线程,但并非线程。可以将 goroutine 理解为一种虚拟线程。Go 语言运行时会参与调度 goroutine,并将 goroutine 合理地分配到每个 CPU 中,最大限度地使用 CPU 性能。
多个 goroutine 中,Go 语言使用通道(channel)进行通信,通道是一种内置的数据结构,可以让用户在不同的 goroutine 之间同步发送具有类型的消息。这让编程模型更倾向于在 goroutine 之间发送消息,而不是让多个 goroutine 争夺同一个数据的使用权。
goroutine
Web 搜索
图片缺失:C:\Users\Stan\AppData\Roaming\Typora\typora-user-images\image-20220605103225320.png
image-20220605103225320
增大 Batch_Size 有何好处? 内存利用率提高了,大矩阵乘法的并行化效率提高。 跑完一次 epoch(全数据集)所需的迭代次数减少,对于相同数据量的处理速度进一步加快。 在一定范围内,一般来说 Batch_Size 越大,其确定的下降方向越准,引起训练震荡越小。 盲目增大 Batch_Size 有何坏处? 内存利用率提高了,但是内存容量可能撑不住了。 跑完一次 epoch(全数据集)所需的迭代次数减少,要想达到相同的精度,其所花费的时间大大增加了,从而对参数的修正也就显得更加缓慢。 Batch_Size 增大到一定程度,其确定的下降方向已经基本不再变化。
词项频率(Term Frequency, TF): 排序中的重要因子 ▪ Tf-idf 权重计算方法: 最出名的经典排序方法 ▪ 向量空间模型(Vector space model): 信息检索中最重要的形式化模型之一 (其他模型还包括布尔模型和概率模型)
Markov
图片缺失:C:\Users\Stan\AppData\Roaming\Typora\typora-user-images\image-20220604222657324.png
image-20220604222657324
马尔可夫模型
P(o1,o2,o3,…|s1,s2,s3….)根据应用的不同而又不同的名称,在语音识别中它被称为“声学模型”(AcousticModel),在机器翻译中是“翻译模型”(*TranslationModel)*而在拼写校正中是“纠错模型”(CorrectionModel)。而 P(s1,s2,s3,…)就是我们在系列一中提到的语言模型。
第一,s1,s2,s3,…是一个马尔可夫链,也就是说,si 只由 si-1 决定(详见系列一);
第二,第 i 时刻的接收信号 oi 只由发送信号 si 决定(又称为独立输出假设,即 P(o1,o2,o3,…|s1,s2,s3….)=P(o1|s1)*P(o2|s2)*P(o3|s3)…。
满足上述两个假设的模型就叫隐含马尔可夫模型。我们之所以用“隐含”这个词,是因为状态 s1,s2,s3,…是无法直接观测到的。
在利用隐含马尔可夫模型解决语言处理问题前,先要进行模型的训练。常用的训练方法由伯姆(Baum)在 60 年代提出的,并以他的名字命名。隐含马尔可夫模型在处理语言问题早期的成功应用是语音识别。七十年代,当时IBM的FredJelinek(贾里尼克)和卡内基·梅隆大学的*JimandJanetBake 提出用隐含马尔可夫模型来识别语音,语音识别的错误率相是人工智能和模式匹配等方法的三分之一(从 30% 到 10%)。八十年代李开复博士坚持采用隐含马尔可夫模型的框架,成功地开发了世界上第一个大词汇量连续语音识别系统 Sphinx。
衡量二分类:
精确率是针对我们预测结果而言的,它表示的是预测为正的样本中有多少是真正的正样本。那么预测为正就有两种可能了,一种就是把正类预测为正类(TP),另一种就是把负类预测为正类(FP),也就是

img
而召回率是针对我们原来的样本而言的,它表示的是样本中的正例有多少被预测正确了。那也有两种可能,一种是把原来的正类预测成正类(TP),另一种就是把原来的正类预测为负类(FN)。
召回率(Recall): RR/(RR + NR),返回的相关结果数占实际相关结果总数的比率,也称为查全率,R∈ [0,1]
▪ 正确率(Precision): RR/(RR + RN),返回的结果中真正相关结果的比率,也称为查准率, P∈ [0,1]
▪ 两个指标分别度量检索效果的某个方面,忽略 任何一个方面都有失偏颇。两个极端情况:返 回有把握的 1 篇,P=100%,但 R 极低;全部文 档都返回,R=1,但 P 极低
RNN
Softmax 如果你在开发一个音乐分类的应用,需要对 k 种类型的音乐进行识别,那么是选择使用 softmax 分类器呢,还是使用 logistic 回归算法建立 k 个独立的二元分类器呢?
这一选择取决于你的类别之间是否互斥,例如,如果你有四个类别的音乐,分别为:古典音乐、乡村音乐、摇滚乐和爵士乐,那么你可以假设每个训练样本只会被打上一个标签(即:一首歌只能属于这四种音乐类型的其中一种),此时你应该使用类别数k= 4 的 softmax 回归。(如果在你的数据集中,有的歌曲不属于以上四类的其中任何一类,那么你可以添加一个“其他类”,并将类别数k设为 5。)
如果你的四个类别如下:人声音乐、舞曲、影视原声、流行歌曲,那么这些类别之间并不是互斥的。例如:一首歌曲可以来源于影视原声,同时也包含人声 。这种情况下,使用 4 个二分类的 logistic 回归分类器更为合适。这样,对于每个新的音乐作品 ,我们的算法可以分别判断它是否属于各个类别。
当前我们来看一个计算视觉领域的例子,你的任务是将图像分到三个不同类别中。(i) 假设这三个类别分别是:室内场景、户外城区场景、户外荒野场景。你会使用 sofmax 回归还是 3 个 logistic 回归分类器呢? (ii) 当前假设这三个类别分别是室内场景、黑白图片、包含人物的图片,你又会选择 softmax 回归还是多个 logistic 回归分类器呢?
在第一个例子中,三个类别是互斥的,因此更适于选择 softmax 回归分类器 。而在第二个例子中,建立三个独立的 logistic 回归分类器更加合适。
C 程序语言设计:
图片缺失:C:\Users\Stan\AppData\Roaming\Typora\typora-user-images\image-20220108165634747.png
结构体
C 语言–“.”与“->”有什么区别?:都是访问结构体的方式, ->指向结构体的指针,equals (*a).b;
循环
1)break 语句通常用在循环语句和开关语句中。当 break 用于开关语句 switch 中时,可使程序跳出 switch 而执行 switch 以后的语句;如果没有 break 语句,则将成为一个死循环而无法退出。 当 break 语句用于 do-while、for、while 循环语句中时,可使程序终止循环而执行循环后面的语句,通常 break 语句总是与 if 语句联在一起,即满足条件时便跳出循环。
2)continue 语句的作用是跳过循环体中剩余的语句而强行执行下一次循环。continue 语句只用在 for、while、do-while 等循环体中,常与 if 条件语句一起使用,用来加速循环
基础
#include.. .h 文件是头文件,内含函数声明、宏定义、结构体定义等内容 .c 文件是程序文件,内含函数实现,变量定义等内容。 强制类型转换 (type_name)variable 整数除法 31/44 = 0 但 (float)31/44 = 0.7123 库函数:{ math.h 1.ploy()功能:求以向量为解的方程或方阵的特征多项式。 cmath.h fabs( )主要是求精度要求更高的 double ,float 型的绝对值
String.h: **void memset(void s, int c, size_t n);
memset:初始化字符串
memset 函数按字节对内存块进行初始化,所以不能用它将 int 数组初始化为 0 和-1 之外的其他值(除非该值高字节和低字节相同)。
作用是在一段内存块中填充某个给定的值,它对较大的结构体或数组进行清零操作的一种最快方法。 }
#include <memory.h>
int main(void){    char buffer[]="Helloworld\n";    printf("Buffer before memset:%s\n",buffer);    memset(buffer+2,'*',sizeof(buffer));    printf("Buffer after memset:%s\n",buffer);    return 0;}输出结果:
Buffer before memset:Helloworld
Buffer after memset:He*********
printf(“%s/n”,a%2==0 ? “even”:“odd”);(条件? 满足:不满足)结构
int 把 main()的值返回给 os ;c 所使用的参数都要预先规定;main 必须有 %#o,0 表示八进制;0X 表示十六进制
++在变量后,意味着执行完这条语句才++ count++ 等于 count+=1 前缀++a 常用(先递增 n,再使用)vs 后缀 a++ 先使用 a 再递增
位置是逻辑上的概念,与实现无关连续用
Difference between
for(initialization;condition;update)
scanf
while(scanf(“%d,&n)&&n!=0) while(scanf(”%d“,&n&&n) while(scanf(”%d“,&n),n) 功能:当输入 n 且 n!=0 时继续循环,当 n 为 0 时结束循环(上述三种写法都可实现此种功能) while(scanf(”%d,&n)!=EOF)和 while(~scanf(“%d”,&n) 功能:当读到文件结尾时终止循环
两个 scanf(%c)的问题:
1。清空输入缓冲区 第一个 scanf 后加入语句:fflush(stdin); //C 语言清空输入缓冲区函数
2。格式控制中加入空格 or 第一个 scanf(%c) 将第二个 scanf 改为:scanf(” %c“,&ch2);//在% 号前面加一个空格 name == &name[0] 用 scanf 读 string scanf(“%s, char);scanf(”%s“,string)前者速度更快,现在想了想应该是数组名可以表示数组首地址的原因。 scanf 格式输入时要求输入格式与格式控制符中的完全一样(如:scanf(”abcd%c”,&ch);
输入时必须输入 abcde,ch 得到的值为 e)空格可以抵消前面输入的回车符。 所以 scanf(%s)只能读一个单词 scanf(“%3.2f”)错误 读 float 和 double 时不能指定精度 读到第一个空白时停止 &储存 int 型 scanf(“%d ,&price”);的地址
059 (0 开头的表示 8 进制,但 9 错误);0xAF (16 进制,10*16+15) printf(“%x”, x); // 以 16 进制格式输出,输出 17; printf(“%o”, x); // 以 8 进制格式输出,输出 2。
“a”字符串‘a’字符常量、是以其代码(一般采用 ASCII 代码,整数类型)储存的;如果这样,char s=“abc”;sizeof(s)=4; 对于字符串结回尾有一个’\0’做结束符,所以它占四个直接空间。sizeof()!!!!测定 再比如 char* s = “abcde”;sizeof(s) = 4; 因为 s 是一个指针,无论指针指向什么内容,指针本答身就是一个地址,它只占 4 个字节。 系统默认浮点型常量是 double 类型的精度,//2 表示’最小‘字符宽度//float 2.3f,2.3e10F; %f 单精度浮点数 %e 指数形式输出 %g 浮点型数据 会去掉多余的零 至多保留 6 位 sizeof 测量预留空间,sizeof name sizeof(char);strlen()测量长度 转义字符’\123’ 这个表示 asc 码为 123 的字符 char nerf =’’转义字符单引号括起来;但双引号内的不用 重定向: c1<words //使计算机从文件中查找输入而不是键盘 C 本身不提供输入输出语句 printf,scanf 通过调用库中的函数实现,他们也不是 c 语言中的关键字;
函数:
{ 随机数: 如果想要产生一个数是从 1 开始到最大值的,比如说,想要产生一个 1-100 之间的随机数,那么用法如下 int num = rand() % 100 + 1;srand 函数 srand(time(0)) srand 函数是随机数发生器的初始化函数,如果要确保每次产生的都不一样,我们需要引用一个专门为 rand 设置随机化种子的函数 srand() 枚举类型(enum)enum week{ Mon, Tues, Wed, Thurs, Fri, Sat, Sun };auto 赋值 Mon=0 Tues=1…. 赋予新的类型 week 可以赋予每一个枚举值若干个属性 基础 即使将参数传给无返回值的 void 函数也能实现对原始参数值的修改 void 函数利用(引用或者指针)来“返回”处理结果是程序员经常用到的方式,主要原因是:一可以让代码更简洁,二是能减少内存空间的占用。 ? 传值: 定义函数时函数括号中的变量名称为形式参数,简称形参或虚拟参数;Local variable :function scope ,block scope //for(int i) 形式参数 parameter 是被调函数的变量,实际参数是主调函数(main)赋给被调函数的具体值
注意
1、 C 语言中实参和形参之间的数据传递是单向的“值传递”,单向传递,只能由实参传给形参,反之不能。 2、 被调用函数的形参只有函数被调用时才会临时分配存储单元,一旦调用结束占用的内存便会被释放。 3、 传值方式传递的是实参的一个拷贝。 传值:将实参的值传递给形参 ? 主调函数向调用函数传递参数实际上只是将实参的拷贝(即临时副本)传递 给了被调用函数,并不是实参本身,这样被调用函数不能直接修改主调函数中变量的值,而只能修改其私有的临时变量副本的值。 ? 传递给调用函数的都是实参的一个拷贝,直接对拷贝进行操作不会影响实参。 invoke 调用 ,recursive 递归:(不会) n 往 n-1 归 f(n)=f(n-1)+f(n-2) 阶乘——stack 栈 last in first out; ? ?这种信息传递是单方向的,形参不能将值传回给实参。
指针 (*,&运算符)
(){ 函数改变全局变量不用指针;
1.float *ptr = &a;//定义指针变量
- 间接运算符/解引用 (得到指针所指向对象的值) &地址运算符(得到指针本身的地址) n = 22, * ptr = &n;//ptr 指向 n// Question:“space”== ? val = ptr;//把 ptr 指向地址的值赋予 val ar[i]等于* (ar+i) ptr++ 指针指向数组下一个元素 myfunct(&hour,&minute) //phour 指向 hour 的地址 传地址,用值计算,再传回地址 myfunct(x)传值 void myfunct(int phour,int pminute) } 数组 指针 函数:
``p->num = 5; // ->指向结构体成员运算符数组指针是指向数组首元素的地址的指针,其本质为指针;指针数组是数组元素为指针的数组,其本质为数组。 函数对指针进行操作,指针作用域只限于函数,但改变的地址可以影响 main()//可返回多个值
-
1。array as function arguments:引用传递,参数的地址相同 int sum_arr (int att【size】) //这是错的,不能传入长度 2.char s1=“hello”;//声明一个指针指向常量“hello”;char s2=“hello”;//在栈中开辟一个数组字符“hello”;/* s2=“he” 相当于* char s2[3]; * s2[0]=‘h’;* s2[1]=‘e’;s2[2]=‘\0’; 一般来说,如果你不给变量一个确定的值,就直接引用它,则系统不能 保证运行的唯一性,源而这是我们程序所不允许的。所以我们一般用初始化的方法来确定其值。 3.指针与多维数组;zippo[4][2]; zippo 表示二维数组首元素的地址;zippo[2][1]==((zippo+2)+1)//第 3 个一维数组的第 2 个 int 元素//
Static
图片缺失:C:\Users\Stan\AppData\Roaming\Typora\typora-user-images\image-20210405131130699.png
image-20210405131130699
(2)存储在静态数据区的变量会在程序刚开始运行时就完成初始化,也是唯一的一次初始化。共有两种变量存储在静态存储区:全局变量和 static 变量,只不过和全局变量比起来,static 可以控制变量的可见范围,说到底 static 还是用来隐藏的。
(3) 初始化数组, static char str[10];默认为 0
2、指针数组 char* name 是一个数组指针,数组里面保存的都是指针,那么 name[0]里面保存的就是指针,也就是你说的地址 例: int a[M][N]; int *p[M];//存放指针的数组 for(int i=0; i<M; i++) p[i] = a[i]; 之后用法度可以跟二维数组一样问,缺点在于答 M 是固定的 3、指向数组的指针 例: int a[M][N]; int (*p)[N]; p = a; 用起来跟二维数组没区别,缺点在于 N 是固定的 4、二级指针 例: int a[M][N]; int **p; p = (int )malloc(sizeof(int )*M); for(int i=0; i<M; i++) { p[i] = a[i]; } 之后的用法可以跟二维数组一样,缺点在于用法比较麻烦,需要维护动态内存
字符串
* ```{ getchar()从键盘读取,搭配putchar('*')用于输入密码时不显示密码;int getc(FILE *stream);从文件流中读取一个内字符。input validation:检验输入是否符合标准;gets()输入字符串过长可能造成缓冲区溢出,擦除内存中的其他数据;fgets(name[i], 20, stdin)is the best 空字符和空指针(NULL)是一个地址占 4byte
string.h
中有 strlen()strcat()strcmp()strncmp(zippo[i],“sadf”,4)/*检测该数组前 4 个是否 sadf//若两个 string 相同返回 0,若第一个字符在第二个字符 ASCII 前面返回-1// strcpy()strncpy() } ```
文件 i/o
* ```{ 重点:区别stdi/o的函数 区分是输出到文件流还是屏幕 fopen(, "r,w,a")文件指针是指向FILE的指针; rewind()使文件内部的指针重新回到文件开头 fseek(infile,offset,origin):文件头0(SEEK_SET),当前位置1(SEEK_CUR),文件尾2(SEEK_END))为基准,偏移offset(指针偏移量) ftell()返回偏移字节;fclose(ptr) ;while(feof(stdin)||feof(ptr)); 文本文件 fscanf windows对文本文件读写的时候,会将换行 \n自动替换成 \r\n。fscanf(stdin)or fscanf(ptr)二进制文件fread fwrite 频繁地保存和访问数据.那么应该采用二进制文件进行存放可以节省存储空间和转换时间。} 结构{ enum 先定义类型后定义结构变量; 用.访问; 类似数组 但成员可以是不同类型 typedef struct {}PNT;简化 结构运算 可以赋值= 传值到函数 today = (struct day){2014,07,13} } ```
运算符优先级 单目+- > %*/ >;=是运算符而不是语句 位运算{ ~取反运算符,0 和 1 互换 按位与& }
错误
- 都会出现错误提示: [Error] assignment to expression with array type
中文通俗意思:不可以赋值给具有数组类型的表达式。这里的表达式是指整个数组的首地址。
也就是说在 C 语言内部 数组的首地址是不可更改的,相当于被 const 修饰
SIGSEGV Segmentation fault.段错误
1.利用指针对数组间访时越界了,即间访到该数组后面的空间了(即间访了一段不属于操作系统给你的空间。)
2.间访悬挂或 空指针!!!
写入东西,应先用内存分配为指针分配一段空间或将其指向某个东西。

img
程序企图向指针 ps 所指内存中写入,但指针 ps 所指的是常量字符串,在生成可执行文件后它会与代码段放在一起,该区域是只读的,所以企图修改指针所指内容会出错。
Notice
<1>定义了指针后记得初始化,在使用的时候记得判断是否为 NULL <2>在使用数组的时候是否被初始化,数组下标是否越界,数组元素是否存在等 <3>在变量处理的时候变量的格式控制是否合理等
物理实验:
1。有效数字 加减取最高 乘除取最低 4 舍 6 入 5 抽偶;五”指的是根据 5 后面的数字来定,当 5 后有数时,舍 5 入 1;当 5 后无有效数字时,需要分两种情况来讲:①5 前为奇数,舍 5 入 1;②5 前为偶数,舍 5 不进。
统计学相关:测量方法:最小二乘法(假设实际 y:Σ(y1-y)^2;多变量偏导拟合;相关系数 r 与线性关系的拟合 0.999)与正态分布 3δ 逐差法(高中处理纸带)
APA style:
Bordo(2001)noted/claimed….
Law
实体法(Substantive Law) 是指规定具体权利义务内容或者法律保护的具体情况的法律,如民法、合同法、婚姻法、公司法等等。程序法是规定以保证权利和职权得以实现或行使,义务和责任得以履行的有关程序为主要内容的法律,如行政诉讼法、行政程序法、民事诉讼法、刑事诉讼法、立法程序法等等。
法理学在研究法律和法律现象的过程中,依据不同的标准,将法律分为不同的种类。根据法律规定内容的不同来进行划分,可以分为实体法和程序法。
最终解释权相关规定一般出现在合同的格式条款中,格式条款是当事人为了重复使用而预先拟定,并在订立合同时未与对方协商的条款。采用格式条款订立合同的,提供格式条款的一方应当遵循公平原则确定当事人之间的权利和义务,并采取合理的方式提示对方注意免除或者减轻其责任等与对方有重大利害关系的条款,按照对方的要求,对该条款予以说明。提供格式条款的一方未履行提示或者说明义务,致使对方没有注意或者理解与其有重大利害关系的条款的,对方可以主张该条款不成为合同的内容。有下列情形之一的,该格式条款无效:
(一)具有本法第一编第六章第三节和本法第五百零六条规定的无效情形;
(二)提供格式条款一方不合理地免除或者减轻其责任、加重对方责任、限制对方主要权利;
(三)提供格式条款一方排除对方主要权利。
公司创造利润无非“开源节流”。卖得多或者卖得贵都可以用毛利润来衡量。赚得多的同时能否压缩日常开支,更好为股东利益服务,就要看净利率了。所以同行业的两家竞品公司,毛利率相同的,净利率高的那家,管理能力更强。